Mi plantilla NestJS 12 + Prisma 7 para APIs en producción: cómo está hecha, cómo usarla y qué aprendí probándola
nestjs-prisma-production-starter por dentro: auth en tres modos, sesiones revocables al instante, rotación de refresh tokens con detección de robo, Argon2id, 2FA con TOTP, Prisma 7 y Zod 4. Con ataques reales contra una instancia local y lo que queda por pulir.
Contenido
Hace unas semanas publiqué mi plantilla de Hono + Prisma para APIs en producción. Esta es su gemela en NestJS: nestjs-prisma-production-starter, un repositorio de GitHub marcado como template (MIT) con una API REST lista para llevar a producción: sesiones con estado que se pueden revocar al instante, rotación de refresh tokens con detección de robo, Argon2id, 2FA con TOTP, recuperación de contraseña, rate limiting en base de datos, Prisma 7 sobre SQLite (o Turso), validación con Zod y documentación OpenAPI con Scalar.
La idea es la misma que con Hono: no quiero otro «hola mundo», quiero algo que puedas clonar, arrancar y desplegar sin reinventar la parte aburrida y peligrosa. Y como con Hono, no me limito a contarte lo que dice el README: la he descargado, compilado, probado y atacado (en local, contra mi propia instancia) para contarte qué hay de verdad dentro, qué funciona y qué todavía no está pulido.
758a0ac de main, en Linux con Node 24.21.0 y npm 11.19.0. El 25 de octubre repetí lo que cambia sobre la rama del PR #8 (commit 623e447), que corrige lo que yo mismo había encontrado; en cada medida te digo de qué commit es. Versiones reales instaladas: NestJS 12.2.0 sobre Express 5.3.0, Prisma 7.10.1, Zod 4.6.7, TypeScript 6.0.3, Jest 30.5.2 y ESLint 10.13.0. Las salidas de terminal son reales (recortadas cuando era largo). Lo que no he podido comprobar está marcado como «sin probar». Docker sí lo he probado (Docker 26.1.5, la imagen construida y ejecutada, docker-compose y Trivy 0.76.1); quedan sin verificar el SBOM, el despliegue en Coolify, el envío real de correo por SMTP, Turso, el funcionamiento con varias instancias a la vez y la ejecución de la CI de GitHub con los cambios del PR. Las partes que describo leyendo el código en lugar de ejecutarlo las marco como «lectura de código».fix/production-hardening, diez commits): npm audit pasa de 4 avisos altos a 0 (un overrides de multer), Trivy pasa de 1 alto a 0, salen cinco dependencias que nadie importaba, la imagen vuelve a node:24-alpine fijada por digest (antes node:25) y baja de 719 a 570 MB, el entorno se valida antes de migrar, los logs de producción salen en texto plano sin colores, las pruebas ya no pueden tocar una base de datos real y hay 84 pruebas en lugar de 62. Fusioné el PR el 25 de octubre a las 12:55 (hora de Madrid) y main ya contiene las correcciones (fusión por squash, commit 611dc0f; su árbol de Git es idéntico al de la rama que medí, 623e447). El artículo describe ese estado y, donde algo cambió, te cuento cómo era y cómo es; cuando digo «en main» para contar cómo era algo, me refiero al estado anterior a la fusión (758a0ac). Lo que no he tocado, y por qué (las decisiones de diseño y los cambios de CI), está en «Lo que queda por pulir». Todo lo medido es local: la CI de GitHub no se ha ejecutado con el PR.Qué es y para quién es
Es una API REST de «tareas» con usuarios, que sirve de esqueleto para cualquier backend serio. El dominio es deliberadamente pequeño (tareas, usuarios, sesiones, auditoría) para que todo el esfuerzo se vea en lo que importa: autenticación, seguridad, datos, pruebas y despliegue.
Lo más distintivo es que tiene tres niveles de autenticación que eliges con una variable (AUTH_MODE):
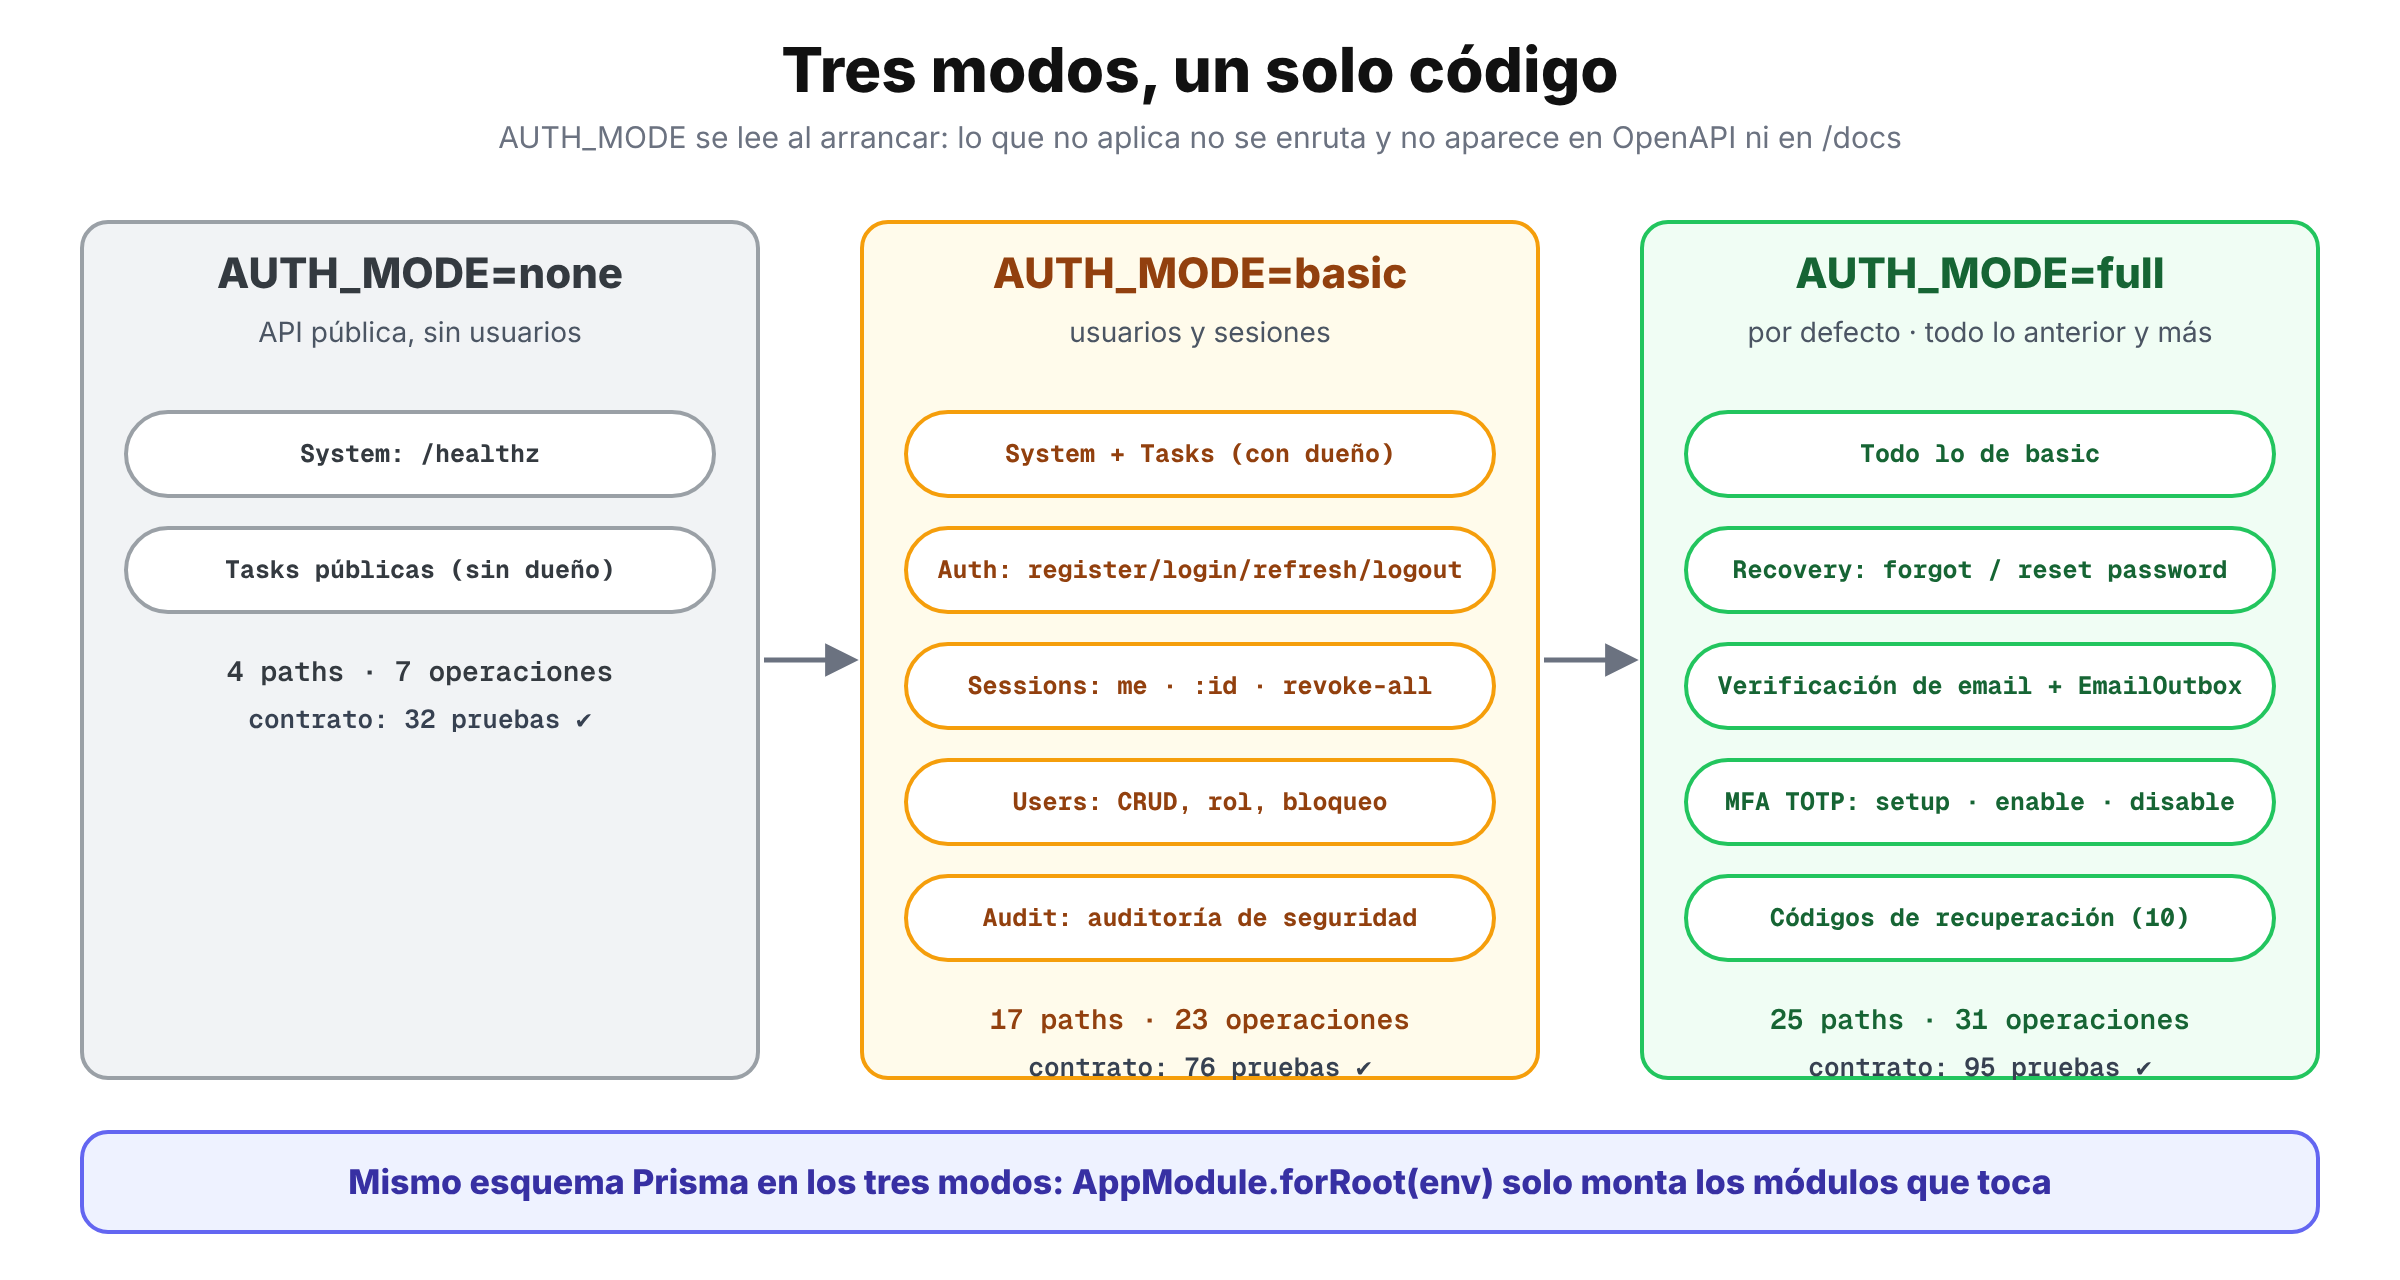
Con none tienes una API pública sin usuarios; con basic, usuarios, sesiones, roles y auditoría; con full (el valor por defecto), además verificación de email, recuperación de contraseña y 2FA. Lo que no aplica no se monta en el router ni aparece en OpenAPI. Lo he comprobado arrancando los tres modos:
| Modo | Paths en OpenAPI | Operaciones | POST /api/auth/login |
GET /api/tasks sin token |
|---|---|---|---|---|
none |
4 | 7 | 404 | 200 |
basic |
17 | 23 | 400 (existe; con {} falla la validación) |
401 |
full |
25 | 31 | existe | 401 |
Es para ti si quieres una base con las decisiones de seguridad ya tomadas (y razonadas), y quieres NestJS porque tu equipo ya lo usa, porque te gusta su estructura modular o porque la inyección de dependencias te encaja. Si lo que buscas es algo más pequeño y rápido de leer, tienes la de Hono; al final del artículo te cuento cuándo elegiría una u otra.
Descarga: cuatro formas de tenerla
| Forma | Cómo |
|---|---|
| Usar como plantilla (la recomendada) | Botón Use this template en GitHub: crea un repositorio tuyo con el código y sin el historial |
| GitHub CLI | gh repo create mi-api --template Collanteslu/nestjs-prisma-production-starter --private --clone |
| Clonar | git clone https://github.com/Collanteslu/nestjs-prisma-production-starter.git |
| ZIP | Code → Download ZIP en la página del repositorio |
Requisitos: Node.js 24.9 o superior y npm 11 o superior (están en engines; yo la he probado con Node 24.21.0 y no he probado versiones anteriores).
El repositorio está marcado como plantilla en GitHub (is_template: true) y tiene licencia MIT. Es un repositorio muy joven: main tiene 30 commits, todos entre el 22 y el 23 de octubre de 2026 (el PR #8 añade diez más).
Puesta en marcha en tres pasos
git clone https://github.com/Collanteslu/nestjs-prisma-production-starter.git
cd nestjs-prisma-production-starter
npm ci
cp .env.example .env
Abre .env y rellena los dos secretos JWT (la app no arranca sin ellos, salvo con AUTH_MODE=none):
openssl rand -base64 48   # úsalo para JWT_SECRET
openssl rand -base64 48   # y otro distinto para JWT_REFRESH_SECRET
Después, cliente de Prisma, migraciones y a correr:
npx prisma generate
npx prisma migrate deploy
npm run dev
La API escucha en http://localhost:3011. En desarrollo, con la base de datos vacía, se siembran dos usuarios de ejemplo ([email protected] y [email protected], contraseña password123) y tres tareas. En producción nunca se siembran demos: solo se crea el administrador inicial si defines ADMIN_EMAIL y ADMIN_PASSWORD.
npm test, no npx jest. El script añade --experimental-vm-modules; sin él fallan 10 de las 13 suites de hoy (cuando lo medí por primera vez eran 7 de 9) con «Must use import to load ES Module». Está en el package.json, pero conviene saberlo.Qué trae y qué versiones
| Pieza | Qué es | Versión probada |
|---|---|---|
| NestJS | Framework (módulos, DI, guards, pipes, interceptores) sobre Express | 12.2.0 (Express 5.3.0) |
| Prisma 7 | ORM con migraciones versionadas | 7.10.1 |
| libSQL | Adaptador de Prisma para SQLite local o Turso | @prisma/adapter-libsql 7.10.1 |
| Zod 4 | Validación de entrada y esquemas de OpenAPI | 4.6.7 |
| nestjs-zod | Integración Zod ↔ Nest/OpenAPI, vendorizada en vendor/ |
5.5.0 |
| @nestjs/swagger + Scalar | OpenAPI 3.0 generado y consola interactiva en /docs |
12.0.4 / 1.2.31 |
| @node-rs/argon2 | Hash de contraseñas Argon2id (nativo) | 2.2.2 |
| @nestjs/jwt | Firma y verificación de JWT (HS256) | 12.0.3 |
| helmet | Cabeceras de seguridad | 8.3.0 |
| nodemailer | Correo (SMTP) para recuperación y verificación | 10.2.1 |
| Jest + supertest | Pruebas unitarias e integración | 30.5.2 / 7.3.1 |
| ESLint + Prettier + Husky | Calidad de código y hooks de git | 10.13.0 / 3.9.10 / 9.1.7 |
| TypeScript | Modo estricto | 6.0.3 |
Dos decisiones que merece la pena entender:
nestjs-zodestá vendorizada. La versión publicada declara peer dependencies que se quedan en Nest y Swagger 11, y esta plantilla va con Nest 12. En vez de forzar--legacy-peer-depso unoverrides, el repositorio incluye una copia compilada envendor/nestjs-zody la instala confile:. Funciona, pero significa que esa pieza no se actualiza sola.- Express 5, no Fastify. Nest 12 usa Express 5 por defecto y la plantilla se apoya en ello (por ejemplo, el comodín de rutas
{*splat}de path-to-regexp v8, que verás en la parte de autenticación).
Si quieres entender cómo piensa NestJS por dentro antes de meterte en la plantilla, te recomiendo NestJS 12 a fondo; y para ver cómo se compara con los demás, la comparativa de Hono, Fastify, Express y NestJS.
La estructura del proyecto
nestjs-prisma-production-starter/
├── prisma/                 # schema.prisma + 10 migraciones versionadas
├── src/
│   ├── main.ts             # arranque: orden estricto (ver más abajo)
│   ├── configure-app.ts    # helmet, CORS, límites de body, Swagger/Scalar
│   ├── app.module.ts       # AppModule.forRoot(env): monta módulos según AUTH_MODE
│   ├── config/             # env.ts (Zod) + tokens de inyección
│   ├── database/           # PrismaService, MigrationsGuard, SeedService
│   ├── auth/               # login/registro/refresh/logout, JwtAuthGuard, AdminGuard
│   ├── sessions/           # sesiones, rotación y revocación de refresh tokens
│   ├── users/  tasks/  audit/
│   ├── mfa/                # TOTP + códigos de recuperación
│   ├── mail/               # recuperación, verificación y cola EmailOutbox
│   ├── rate-limit/         # guard, bloqueo por cuenta y almacén en BD
│   ├── jobs/               # CleanupService (cada hora)
│   ├── common/             # pipe, interceptores, filtro, middleware, utilidades
│   └── generated/          # cliente de Prisma (generado, no se versiona)
├── test/                   # 13 suites de Jest
├── contract/               # harness HTTP ejecutable (11 escenarios)
├── bruno/                  # colección de Bruno (32 peticiones)
├── scripts/                # bruno-smoke.sh, ops-rehearsal.sh, lockout-key.mjs, docker-smoke.sh (PR #8)
├── vendor/nestjs-zod/      # integración Zod vendorizada
├── Dockerfile  docker-compose.yml  docker-entrypoint.sh
└── AGENTS.md               # documentación larga (unas 500 líneas) del comportamiento
Los scripts de npm que vas a usar:
| Script | Qué hace |
|---|---|
npm run dev |
nest start --watch |
npm run build / npm start |
Compila a dist/ / arranca node dist/main.js |
npm run typecheck |
tsc --noEmit |
npm run lint |
ESLint |
npm test / npm run test:cov |
Jest (con y sin cobertura) |
npm run contract |
Harness de contrato HTTP |
npm run db:deploy / db:migrate |
prisma migrate deploy / migrate dev |
npm run test:e2e |
test-api.sh: recorrido de sesiones y bloqueos con curl |
Y por dónde pasa una petición, de un vistazo:
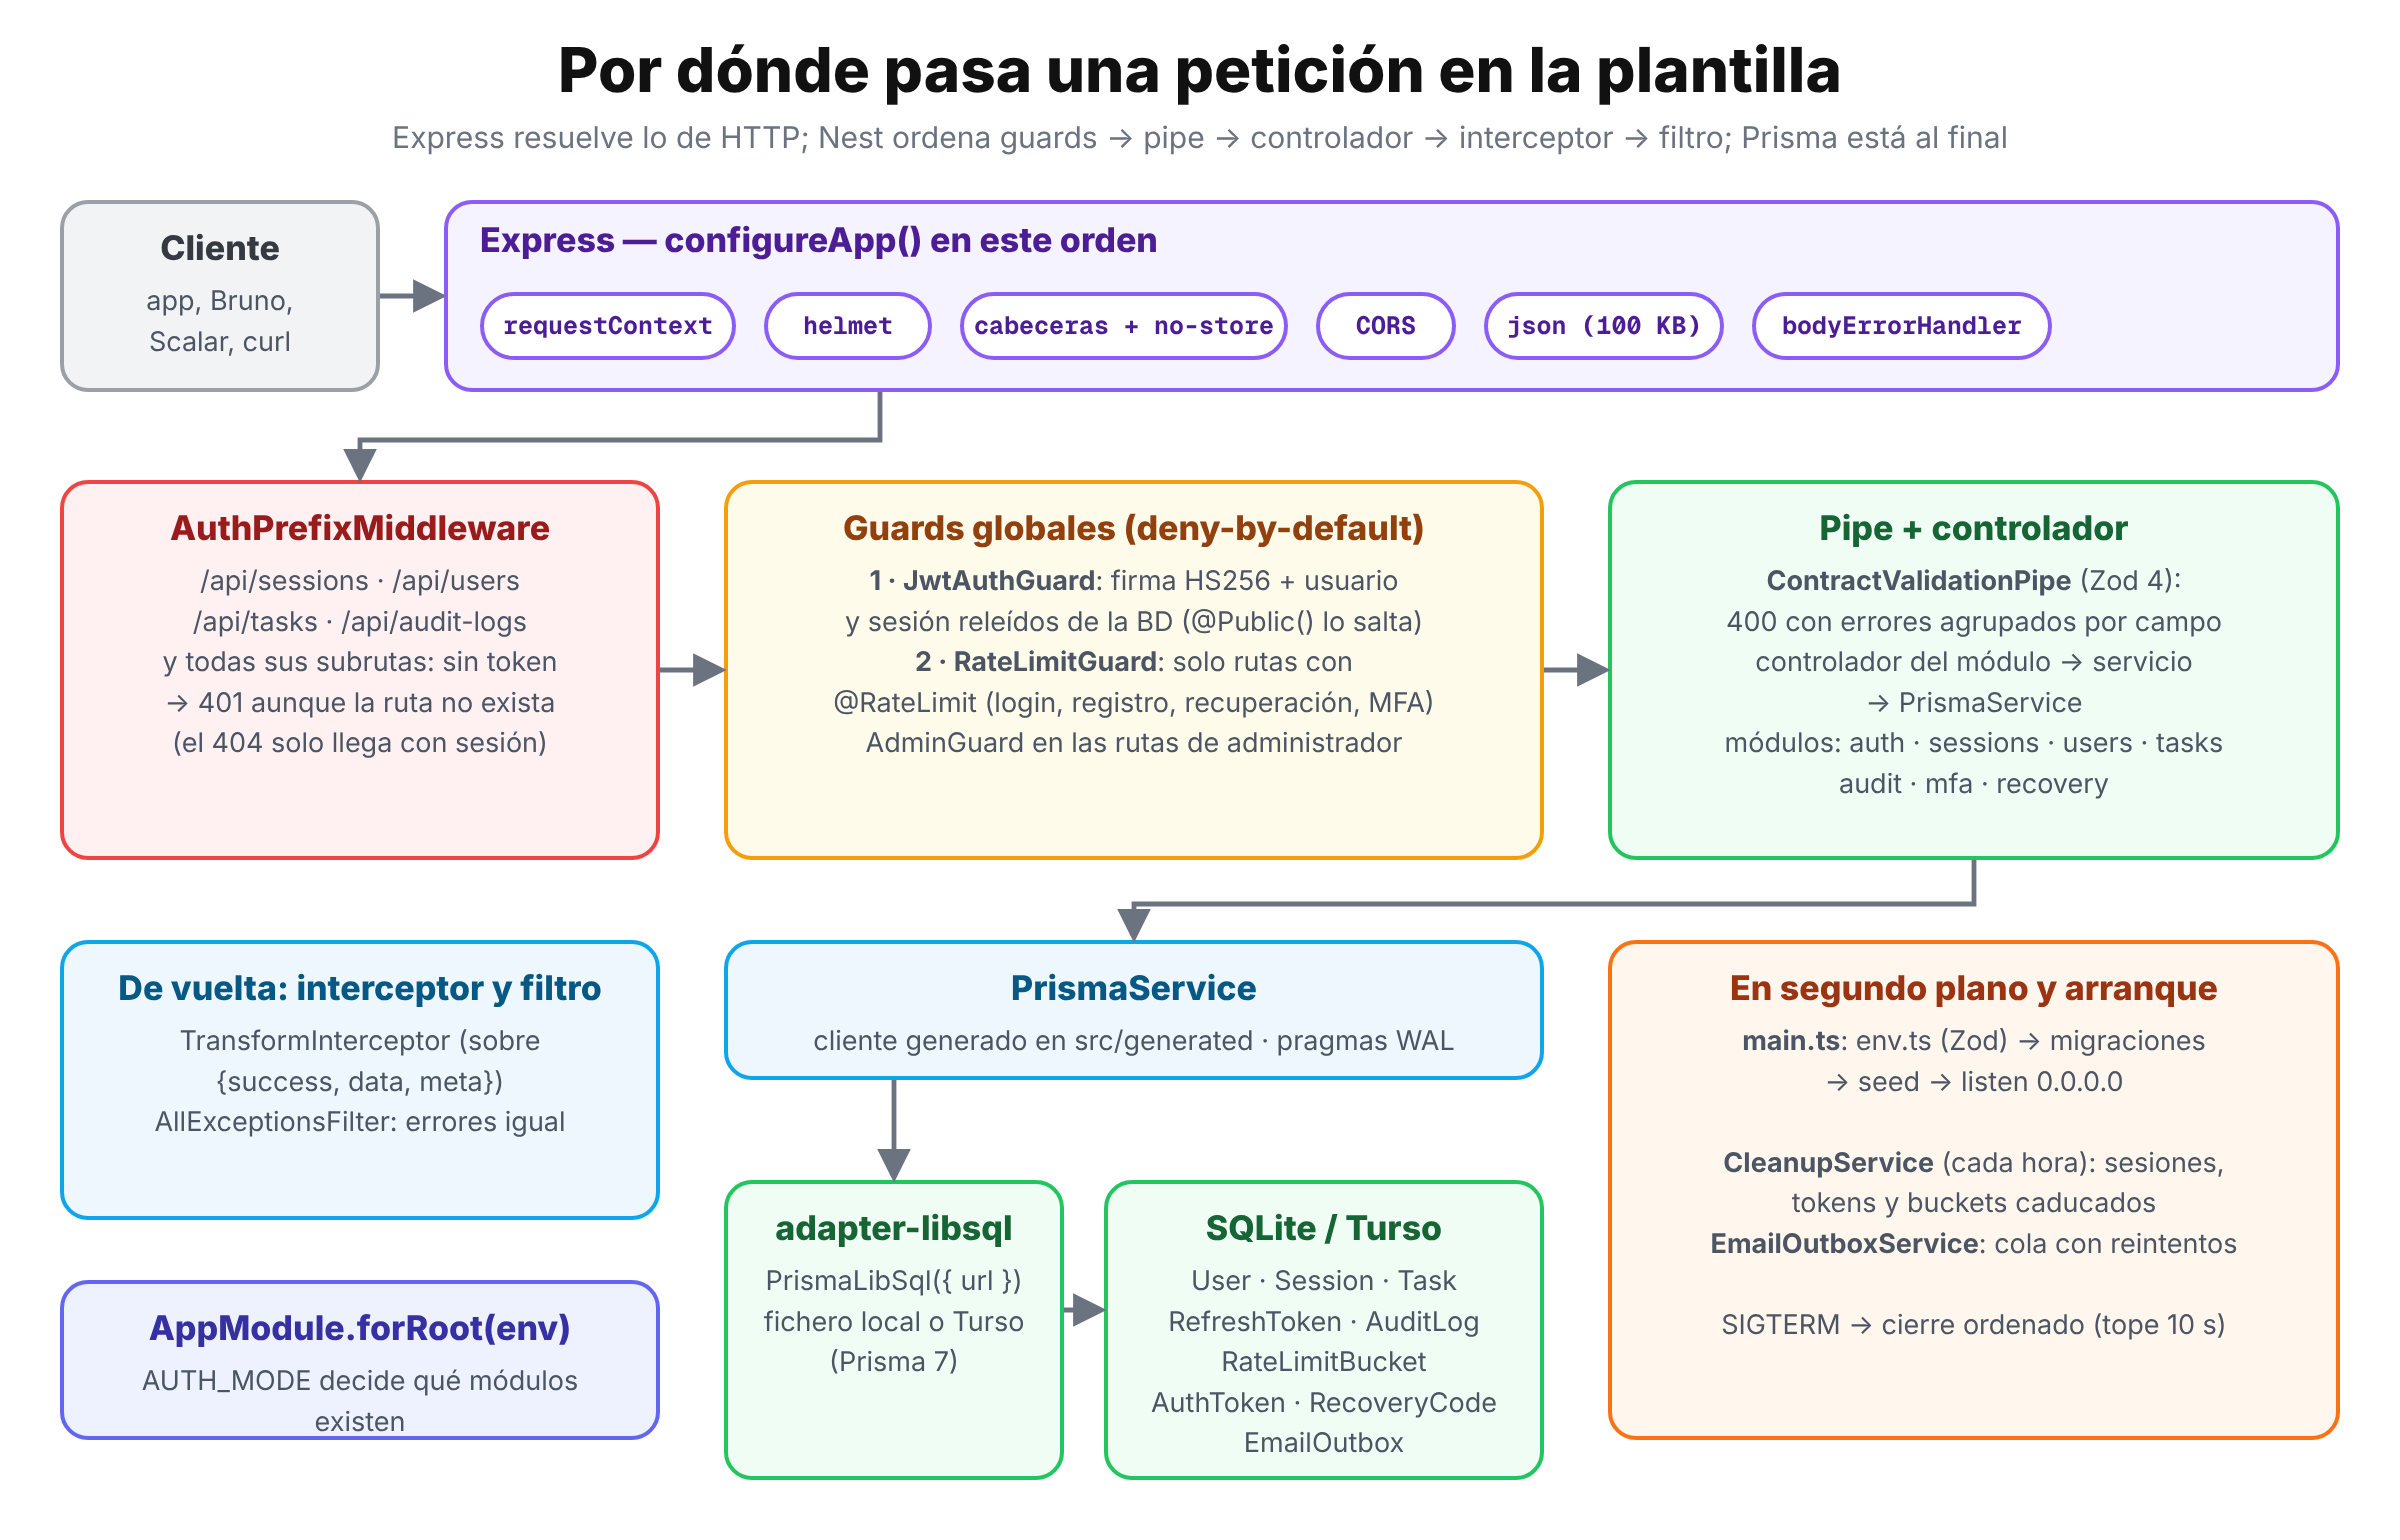
La parte de Express (configureApp()) hace lo propio de HTTP; Nest ordena después guards → pipe → controlador → interceptor → filtro de excepciones. Todo lo global se registra en AppModule con los tokens APP_GUARD, APP_PIPE, APP_INTERCEPTOR y APP_FILTER:
{ provide: APP_GUARD, useExisting: JwtAuthGuard },   // 1º: ¿quién eres? (deny-by-default)
{ provide: APP_GUARD, useClass: RateLimitGuard },    // 2º: ¿cuántas veces?
{ provide: APP_PIPE, useClass: ContractValidationPipe },
{ provide: APP_INTERCEPTOR, useClass: TransformInterceptor },   // sobre de respuesta
{ provide: APP_FILTER, useClass: AllExceptionsFilter },
Detalle que me gusta: JwtAuthGuard se registra con useExisting, no con useClass, para que el guard global y el AuthPrefixMiddleware compartan la misma instancia y la verificación del token exista una sola vez en el código.
Configuración que falla rápido
Lo primero que hace main.ts es loadEnv(): valida todas las variables de entorno con Zod y, si algo está mal, la app se niega a arrancar con un mensaje que dice qué falta. Las reglas de producción son estrictas. Esto es lo que pasa de verdad (salidas reales):
# Sin secretos (AUTH_MODE=full por defecto)
❌ Critical startup failure: Invalid or missing environment configuration:
{
  "JWT_SECRET": [
    "JWT_SECRET is required unless AUTH_MODE=none (generate one with: openssl rand -base64 48)"
  ],
  "JWT_REFRESH_SECRET": [ "JWT_REFRESH_SECRET is required unless AUTH_MODE=none (…)" ]
}
exit=1

# NODE_ENV=production con el mismo secreto en los dos JWT y sin clave de MFA
{
  "JWT_REFRESH_SECRET": [ "JWT_REFRESH_SECRET must differ from JWT_SECRET" ],
  "MFA_ENCRYPTION_KEY": [ "MFA_ENCRYPTION_KEY (>= 32 chars) is required in production with AUTH_MODE=full so TOTP secrets are encrypted with a dedicated, stable key (…)" ]
}
exit=1

# NODE_ENV=production con CORS_ORIGINS=*
{
  "CORS_ORIGINS": [ "CORS_ORIGINS=\"*\" is rejected in production: list the real origins, or set CORS_ALLOW_WILDCARD=true to allow any origin deliberately" ]
}
exit=1
Comprobé todas las reglas de producción de una en una: secretos de menos de 16 caracteres (rechazados), mismo secreto para ambos JWT (rechazado en cualquier entorno, porque un refresh token se aceptaría como access token), CORS_ORIGINS=* (rechazado salvo CORS_ALLOW_WILDCARD=true), MAIL_TRANSPORT=log en producción (rechazado, porque escribiría en el log los enlaces de recuperación, que son credenciales vivas) y SMTP con ignoreTLS=true (rechazado). Cada una termina con código de salida 1.
El fragmento de env.ts que lo hace posible usa superRefine de Zod 4:
.superRefine((cfg, ctx) => {
  const authEnabled = cfg.AUTH_MODE !== "none";
  if (authEnabled) {
    for (const key of ["JWT_SECRET", "JWT_REFRESH_SECRET"] as const) {
      if (!cfg[key]) ctx.addIssue({ code: "custom", path: [key],
        message: `${key} is required unless AUTH_MODE=none (generate one with: openssl rand -base64 48)` });
    }
  }
  if (authEnabled && cfg.JWT_SECRET && cfg.JWT_SECRET === cfg.JWT_REFRESH_SECRET) {
    // Same secret in ANY environment: a refresh token would then verify as an access token
    ctx.addIssue({ code: "custom", path: ["JWT_REFRESH_SECRET"],
      message: "JWT_REFRESH_SECRET must differ from JWT_SECRET" });
  }
  if (cfg.NODE_ENV !== "production") return;
  // … endurecimiento solo para producción …
})
Y el .env.example viene comentado en español, con el porqué de cada variable (proxy, CORS, rate limits, TTL de recuperación…). Lo que más vas a tocar:
| Variable | Para qué |
|---|---|
AUTH_MODE |
none, basic o full (por defecto) |
JWT_SECRET, JWT_REFRESH_SECRET |
Dos secretos distintos; en producción, de 32+ caracteres |
MFA_ENCRYPTION_KEY (+ _PREVIOUS) |
Cifra los secretos TOTP; obligatoria en producción con full; la anterior permite rotarla |
DATABASE_URL |
file:./dev.db por defecto; TURSO_DATABASE_URL + TURSO_AUTH_TOKEN lo sustituyen |
TRUST_PROXY, TRUST_PROXY_HOPS |
Para obtener la IP real detrás de un proxy (más abajo) |
CORS_ORIGINS |
Orígenes permitidos; * solo en desarrollo |
ENABLE_DOCS |
/docs y /openapi.json; apagados por defecto en producción |
MAIL_TRANSPORT, SMTP_URL, APP_URL |
none / log / smtp |
ADMIN_EMAIL, ADMIN_PASSWORD |
Administrador inicial en producción |
LOGIN_RATE_LIMIT_MAX, LOGIN_LOCKOUT_* |
Límites y bloqueo por cuenta |
RATE_LIMIT_ON_DB_FAILURE |
local (por defecto) o open si cae el almacén de contadores |
Referencia completa de variables
El esquema de src/config/env.ts define 36 variables. Esta es la tabla completa, sacada del código (no del README), con el valor por defecto que aplica la aplicación:
| Variable | Por defecto | Notas |
|---|---|---|
PORT |
3011 |
Se convierte a número |
NODE_ENV |
development |
development, production o test |
AUTH_MODE |
full |
none, basic o full |
JWT_SECRET |
— | Obligatoria salvo AUTH_MODE=none; mínimo 16 caracteres (32 en producción) |
JWT_REFRESH_SECRET |
— | Igual, y distinta de JWT_SECRET en cualquier entorno |
DATABASE_URL |
file:./dev.db |
SQLite local |
TURSO_DATABASE_URL, TURSO_AUTH_TOKEN |
— | Si existen, sustituyen al fichero local |
TRUST_PROXY |
false |
Solo true o 1 lo activan |
TRUST_PROXY_HOPS |
1 |
Entero entre 1 y 10 |
ADMIN_EMAIL, ADMIN_PASSWORD |
— | Administrador inicial; la contraseña, de 8 a 72 caracteres |
CORS_ORIGINS |
* (desarrollo) / vacío (producción) |
Lista separada por comas |
CORS_ALLOW_WILDCARD |
false |
Permite * en producción a conciencia |
ENABLE_DOCS |
true salvo en producción |
/docs y /openapi.json |
LOGIN_RATE_LIMIT_MAX |
10 |
Por IP y minuto |
REFRESH_RATE_LIMIT_MAX |
30 |
Por IP y minuto |
REGISTER_RATE_LIMIT_MAX |
5 |
Por IP y hora |
RECOVERY_RATE_LIMIT_MAX, MFA_RATE_LIMIT_MAX |
10 |
Por IP |
LOGIN_LOCKOUT_MAX_FAILURES |
5 |
Fallos antes de bloquear la cuenta |
LOGIN_LOCKOUT_MINUTES |
15 |
Duración del bloqueo |
AUDIT_RETENTION_DAYS |
90 |
0 desactiva el borrado de auditoría |
MAIL_TRANSPORT |
log (desarrollo) / none (producción) |
none, log, smtp o memory |
SMTP_URL |
— | smtps://usuario:clave@host:465; obligatoria con smtp |
MAIL_FROM |
NestJS API <no-reply@localhost> |
Remitente |
APP_URL |
http://localhost:3000 |
Base de los enlaces de los correos |
PASSWORD_RESET_TTL_MINUTES |
60 |
Caducidad del enlace de recuperación |
EMAIL_VERIFY_TTL_HOURS |
24 |
Caducidad del enlace de verificación |
REQUIRE_EMAIL_VERIFICATION |
false |
Exige verificar el email para entrar |
MFA_ENCRYPTION_KEY |
— | 32+ caracteres; obligatoria en producción con full |
MFA_ENCRYPTION_KEY_PREVIOUS |
— | Solo durante una rotación |
MFA_ISSUER |
NestJS API |
Nombre que ve la app autenticadora |
LOG_LEVEL |
— | fatal… trace o silent |
REFRESH_REUSE_GRACE_SECONDS |
10 |
Ventana en la que un refresh repetido es 409 y no robo |
RATE_LIMIT_ON_DB_FAILURE |
local |
local o open |
Fíjate en un detalle: las cadenas vacías cuentan como «sin definir». Es lo que hace que el docker-compose.yml pueda pasar CORS_ORIGINS=${CORS_ORIGINS:-} sin romper nada: si no defines la variable, llega vacía y se aplica el valor por defecto.
Además de los límites de cada variable, hay reglas cruzadas. Las ejecuté llamando a parseEnv() con cada combinación (salida real, una línea por caso):
RECHAZA AUTH_MODE=none + ADMIN_EMAIL → ADMIN_EMAIL / ADMIN_PASSWORD have no effect with AUTH_MODE=none (there are no users)
RECHAZA MAIL_TRANSPORT=smtp sin SMTP_URL → SMTP_URL is required when MAIL_TRANSPORT=smtp
RECHAZA REQUIRE_EMAIL_VERIFICATION sin transporte que entregue → … needs a mail transport that delivers (MAIL_TRANSPORT=smtp), otherwise nobody could verify
RECHAZA REQUIRE_EMAIL_VERIFICATION con AUTH_MODE=basic → … needs AUTH_MODE=full (email verification is off otherwise)
RECHAZA MFA_ENCRYPTION_KEY_PREVIOUS sin la actual → … only works together with MFA_ENCRYPTION_KEY
RECHAZA producción + smtp sin APP_URL → APP_URL is required in production when MAIL_TRANSPORT=smtp (it builds the emailed links)
RECHAZA producción + APP_URL en http → APP_URL must use https in production when MAIL_TRANSPORT=smtp
RECHAZA ADMIN_PASSWORD de 73 caracteres → Too big: expected string to have <=72 characters
RECHAZA TRUST_PROXY_HOPS=0 → Too small: expected number to be >=1
OK      producción mínima (2 JWT distintos + MFA_ENCRYPTION_KEY) → CORS_ORIGINS=[], MAIL_TRANSPORT=none
Las reglas que solo se aplican en producción, leídas directamente en el superRefine (estas no las ejecuté una a una: son lectura de código): MAIL_TRANSPORT=log se rechaza porque escribiría en los logs los enlaces de recuperación con credenciales vivas; CORS_ORIGINS=* se rechaza salvo CORS_ALLOW_WILDCARD=true; los secretos JWT necesitan 32 caracteres; MAIL_TRANSPORT=memory se rechaza («solo para pruebas»); y una SMTP_URL con ignoreTLS=true o rejectUnauthorized=false se rechaza para que nadie degrade el canal a texto plano.
La última línea es el mínimo absoluto para arrancar en producción: dos secretos JWT distintos de 32+ caracteres y la clave de MFA. Y fíjate en lo que implica el resultado: CORS queda vacío (ningún origen cruzado) y el correo en none hasta que lo configures. Es una configuración cerrada por defecto, que es lo que se espera de una plantilla de producción.
MFA_ENCRYPTION_KEY. Fuera de producción es opcional: si no la defines, la clave de cifrado de los secretos TOTP se deriva de JWT_SECRET (con HKDF-SHA256). Es cómodo para desarrollar, pero rotar el secreto JWT dejaría inservibles todos los autenticadores enrolados. Por eso en producción con AUTH_MODE=full es obligatoria: la clave de cifrado necesita un ciclo de vida independiente de la de firma.Prisma 7: modelo, migraciones y cliente
Nueve modelos pequeños
El esquema tiene nueve tablas con su propio propósito (prisma/schema.prisma):
| Modelo | Para qué |
|---|---|
User |
Usuario, rol (user/admin), bloqueo, borrado lógico, y los campos de MFA |
Session |
Una fila por sesión: isActive, expiresAt, IP y user agent |
RefreshToken |
Hash SHA-256 del refresh token, usedAt (rotación) y a qué sesión pertenece |
Task |
Tarea con borrado lógico (deletedAt); userId es opcional para el modo none |
AuditLog |
Registro de auditoría con índices por fecha, entidad, acción y usuario |
AuthToken |
Tokens de recuperación/verificación (solo el hash), atados al email al que se enviaron |
EmailOutbox |
Cola persistente de correos con estado, intentos y reintento con espera |
RecoveryCode |
Códigos de recuperación de MFA (solo hash), uno por fila |
RateLimitBucket |
Contadores de rate limiting (rl:login:IP, lockout:…) en la propia BD |
Un detalle de diseño: el cliente de Prisma se crea con omit global para que password, totpSecret y totpLastStep no salgan en ninguna consulta salvo que lo pidas explícitamente (omit: { password: false }). Es una de esas decisiones que evitan filtrar un hash por un include descuidado, y lo comprobé en el ataque: pedir include=user,password no devuelve ningún campo de contraseña.
Migraciones versionadas, nunca db push
Hay diez migraciones en prisma/migrations/ (de 0_init a 20261023090922_email_outbox). El arranque comprueba que el historial de la base coincide con el del repositorio; si no, no arranca. Esto es lo que ocurre en producción con una base nueva sin migrar (salida real, recortada):
ERROR [Bootstrap] Migration history does not match prisma/migrations:
  Pending: 0_init, 20260929000000_hash_refresh_tokens_and_indexes, 20261001211304_rate_limit_buckets, …
MigrationsGuard
exit=1
Mensaje claro y fail closed. En contenedor, el docker-entrypoint.sh es quien aplica las migraciones (prisma migrate deploy) antes de arrancar. Lo ejecuté primero sin Docker, directamente con sh ./docker-entrypoint.sh node dist/main.js y un DATABASE_URL=file:…/data/prod.db en un directorio que no existía:
🚀 Aplicando migraciones de base de datos...
SQLite database prod.db created at file:/…/data/prod.db
10 migrations found in prisma/migrations
Applying migration `0_init`
…
Applying migration `20261023090922_email_outbox`
⚡ Iniciando servidor NestJS...
El script crea el directorio, aplica las 10 migraciones, arranca el servidor, /healthz responde y /docs da 404 (producción). Y cuando la base existe pero no tiene historial de migraciones (un caso real si migras desde otra herramienta), no inventa nada: se niega a hacer el baseline automático y te da el procedimiento manual:
Error: P3005
The database schema is not empty. …
❌ No se aplicaron las migraciones.
   La base de datos existe SIN historial de migraciones (P3005). Procedimiento manual:
     1. Copia de seguridad del fichero/BD actual.
     2. Verificar que el esquema existente es el esperado …
     3. Solo si el esquema coincide:  node node_modules/prisma/build/index.js migrate resolve --applied 0_init
     4. node node_modules/prisma/build/index.js migrate deploy
   Nunca ejecutes resolve en un esquema que no hayas verificado.
exit=1
Esto es lo que quiero de una plantilla de producción: que un fallo se note en el arranque y no a las tres de la madrugada.
El cliente: libSQL, WAL y Turso
PrismaService extiende PrismaClient con el adaptador PrismaLibSql. Si defines TURSO_DATABASE_URL, se usa Turso; si no, el fichero local. Al arrancar aplica los pragmas de SQLite (en mi log: SQLite pragmas applied at startup (journalMode=wal)) y el adaptador espera hasta 5 segundos al único escritor de SQLite en vez de fallar con SQLITE_BUSY bajo concurrencia.
El seed
SeedService corre tras la comprobación de migraciones. Fuera de producción siembra los dos usuarios demo y tres tareas; con AUTH_MODE=none siembra dos tareas públicas de ejemplo; en producción solo crea el administrador inicial si la base está vacía y has definido ADMIN_EMAIL y ADMIN_PASSWORD. Lo verifiqué: en el arranque en producción, el login de [email protected] da 401 (no existe) y el del administrador del entorno da 200.
El punto de entrada: orden estricto
El main.ts documenta su propio orden y es muy didáctico:
const env = loadEnv();                         // 1. valida .env con Zod (o aborta)
Logger.overrideLogger(nestLogLevels(env.LOG_LEVEL));   // 2. nivel de log
const app = await NestFactory.create<NestExpressApplication>(AppModule.forRoot(env), {
  bodyParser: false,   // el body se configura de forma explícita en configureApp()
  abortOnError: false,
});
await configureApp(app, env, features);        // 3. helmet, CORS, límites, docs
await app.init();
await prisma.applySqlitePragmas();             // 4. pragmas de SQLite
await assertMigrationsUpToDate(prisma);        // 5. migraciones al día o exit(1)
await app.get(SeedService).run();              // 6. seed
cleanup.start();  outbox?.start();             // 7. limpieza horaria y worker de correo
installShutdownHooks(app, …);                  // 8. cierre ordenado (tope 10 s)
await app.listen(env.PORT, "0.0.0.0");         // 9. y solo entonces, escuchar
Dos observaciones: la app solo escucha cuando todo lo anterior ha ido bien, y en el apagado (SIGTERM) cierra el servidor, para los trabajos y desconecta Prisma. Lo medí: del SIGTERM a la salida pasan 39–47 ms sin tráfico.
configureApp() fija el resto: helmet, una CSP específica solo para /docs, Referrer-Policy: no-referrer y Cache-Control: no-store en todas las respuestas, CORS por lista, y un json({ limit: 100 KB }) con un manejador de errores de body que responde 400 (JSON mal formado) o 413 (demasiado grande). También desactiva x-powered-by y los etags, y usa el query parser simple.
Módulos e inyección de dependencias: el mapa completo
Si vienes de Hono o de Express, esta es la parte de NestJS que más cuesta al principio y la que más compensa después. Por eso la recorro entera, con el código real.
Un módulo es una caja con puertas
En Nest todo vive dentro de un @Module. Un módulo declara qué controladores monta, qué proveedores (servicios) crea, qué importa de otros módulos y qué exporta para que otros lo usen. Lo que no exportas es privado. Esta plantilla tiene 14 módulos: el raíz, seis globales (disponibles en todas partes sin importarlos) y siete «de funcionalidad». Este es el reparto, sacado de los ficheros *.module.ts:
| Módulo | Global | Qué aporta | Quién lo ve |
|---|---|---|---|
ConfigProviderModule |
sí | APP_ENV y APP_FEATURES (el entorno validado y las capacidades según AUTH_MODE) |
todos |
DatabaseModule |
sí | PrismaService |
todos |
RateLimitModule |
sí | RateLimitService, LoginLockoutService, PasswordConfirmLockoutService, RateLimitGuard |
todos |
AuditModule |
sí | AuditService |
todos |
MailModule |
sí | MailService, AuthTokensService, AccountMailService, EmailOutboxService |
todos |
MfaModule |
sí | TotpService, MfaService |
todos (el login los necesita siempre) |
SessionsModule |
no | TokensService, SessionsService y las rutas /api/sessions |
AuthModule, UsersModule, RecoveryModule, MfaRoutesModule lo importan |
AuthModule |
no | /api/auth/* (registro, login, refresh, logout) |
solo con AUTH_MODE distinto de none |
UsersModule, AuditLogsModule |
no | /api/users, /api/audit-logs |
solo con autenticación |
RecoveryModule, MfaRoutesModule |
no | recuperación de contraseña, verificación de email y rutas de 2FA | solo con AUTH_MODE=full |
TasksModule |
no | /api/tasks, el recurso de ejemplo |
siempre (pública con none) |
Fíjate en RateLimitModule, AuditModule o MfaModule: son globales porque casi cualquier controlador los necesita y repetir imports: [AuditModule] en cada módulo sería ruido. El precio es el de siempre con lo global: un módulo nuevo puede usar AuditService sin declarar de dónde viene, y eso oculta dependencias. Es una decisión razonable aquí; en un proyecto con veinte módulos de dominio yo preferiría importar explícitamente.
AppModule.forRoot(env): un módulo dinámico
El módulo raíz no es un decorador estático. Es una función que recibe el entorno ya validado y devuelve la definición del módulo:
static forRoot(env: Env): DynamicModule {
  const features = featuresOf(env);
  return {
    module: AppModule,
    imports: [
      ConfigProviderModule.forEnv(env),
      DatabaseModule, RateLimitModule, AuditModule, MailModule,
      MfaModule,
      TasksModule,
      ...(features.auth ? [SessionsModule, AuthModule, UsersModule, AuditLogsModule] : []),
      ...(features.accountSecurity ? [RecoveryModule, MfaRoutesModule] : []),
    ],
    controllers: [HealthController, SystemController],
    providers: [ SeedService, CleanupService, JwtAuthGuard, /* … APP_GUARD, APP_PIPE, … */ ],
  };
}
Eso resuelve algo que en Hono se hace con if al montar rutas: con AUTH_MODE=none las rutas de autenticación no existen (no es que devuelvan 404 por una condición, es que el módulo nunca se carga). El entorno entra por un token de inyección, no por una variable global:
export const APP_ENV = Symbol("APP_ENV");
// en el proveedor:   { provide: APP_ENV, useValue: env }
// en cualquier clase: constructor(@Inject(APP_ENV) private readonly env: Env) {}
La consecuencia práctica es la que más me gusta de este diseño: los tests pueden construir la aplicación con el entorno que quieran (AppModule.forRoot(loadEnv()) con otras variables) sin tocar process.env más allá de lo imprescindible.
constructor(private readonly prisma: PrismaService, @Inject(APP_ENV) private readonly env: Env) significa «dame una instancia compartida de PrismaService (la resuelvo por el tipo) y el valor registrado bajo APP_ENV (lo resuelvo por el símbolo)». Las interfaces y los tipos de TypeScript no existen en tiempo de ejecución, por eso lo que no es una clase necesita un token con @Inject.Los cinco proveedores globales y su orden
AppModule registra cinco piezas con los tokens especiales APP_GUARD, APP_PIPE, APP_INTERCEPTOR y APP_FILTER. Se aplican a todas las rutas, y el orden en que Nest las ejecuta es fijo:
| Orden | Pieza | Qué hace en esta plantilla |
|---|---|---|
| 1 | AuthPrefixMiddleware |
Autentica antes de enrutar en los cuatro prefijos protegidos (para que una subruta inexistente dé 401 y no 404) |
| 2 | JwtAuthGuard |
Exige Bearer salvo @Public(); comprueba firma, usuario y sesión en la BD |
| 3 | RateLimitGuard |
Solo actúa en rutas con @RateLimit(...) |
| 4 | Interceptor (entrada) | TransformInterceptor lee sus metadatos y deja pasar |
| 5 | ContractValidationPipe |
Valida body, query y params con Zod |
| 6 | El método del controlador | Tu código |
| 7 | TransformInterceptor (salida) |
Envuelve en { success, data, meta } |
| — | AllExceptionsFilter |
Si cualquier paso lanza, construye el sobre de error |
Una nota sobre el paso 2: en AppModule el guard aparece dos veces, JwtAuthGuard como proveedor normal y { provide: APP_GUARD, useExisting: JwtAuthGuard }. No es un descuido: el AuthPrefixMiddleware necesita la misma instancia del guard para llamar a authenticate(), y useExisting evita que Nest cree dos instancias distintas.
Dos consecuencias de este orden que merece la pena saber, porque no son evidentes:
- El rate limit se ejecuta después de autenticar. Como
/loginy/registerson@Public(), para ellas el guard de JWT es un simple «pasa», y el límite por IP actúa de verdad. Pero en una ruta protegida, un cliente sin token recibe 401 antes de gastar un solo contador. - La validación ocurre antes que tu código. Tu controlador nunca ve un cuerpo, un
queryo unosparamssin validar. Lo que evita filtrar campos sensibles en la salida no es un serializador, sino elomitglobal de Prisma (la contraseña y el material de 2FA nunca salen de la base de datos salvo en el login). Enmainhabía además unZodSerializerInterceptorregistrado globalmente que no validaba nada: ninguna ruta de la plantilla declara un esquema de respuesta (busquéZodResponseyZodSerializerDtoensrc/: solo aparecía en un comentario del controlador de salud). El PR #8 lo quita para que nadie crea que las respuestas se validan; si algún día quieres validar la salida, añade un DTO de respuesta por ruta y vuelve a registrarlo.
Decoradores propios: @Public, @AuthUser, @RateLimit
Los decoradores de Nest son metadatos más una convención. Los tres que usa la plantilla ocupan menos de 15 líneas cada uno:
// @Public(): marca la ruta; el guard lee el metadato con Reflector
export const IS_PUBLIC_KEY = "isPublic";
export const Public = () => SetMetadata(IS_PUBLIC_KEY, true);

// @AuthUser(): extrae el usuario que el guard dejó en la petición
export const AuthUser = createParamDecorator(
  (_data: unknown, ctx: ExecutionContext): AuthUserPayload =>
    ctx.switchToHttp().getRequest<RequestWithUser>().user as AuthUserPayload,
);
Y así quedan en un controlador (el de login, recortado): @Post("login") @Public() @HttpCode(200) @RateLimit("login") @TopLevelEnvelope(). Cuatro decoradores y sabes qué hace la ruta sin abrir el método: pública, devuelve 200, limitada y con el sobre «plano». Esa legibilidad por metadatos es el argumento a favor de NestJS; el argumento en contra es que hay que conocer el sistema para entender qué ocurre entre los decoradores (el orden de la tabla anterior).
El sobre de respuesta
Todas las respuestas tienen la misma forma (TransformInterceptor), también los errores (AllExceptionsFilter), con un requestId para rastrear en los logs. Es la misma forma que usa la plantilla de Hono:
{
  "success": false,
  "message": "Validation error in request payload",
  "errors": { "title": ["Title must be at least 3 characters long"] },
  "meta": {
    "requestId": "3681cb18-ac3c-4363-a142-0293a3fe5646",
    "timestamp": "2026-10-24T05:51:20.061Z",
    "durationMs": 2.4,
    "apiVersion": "2.0.0"
  }
}
Una ruta que no existe responde con el mismo sobre ("Route not found: GET /nada", 404). Lo único que no va envuelto es /healthz, a propósito, para que lo consuma un orquestador:
{"status":"healthy","timestamp":"2026-10-24T05:44:46.666Z","uptimeSeconds":7,"database":{"status":"connected","latencyMs":1}}Los logs de Nest, por el contrario, no son JSON: salen en texto con el formato [Nest] pid - fecha LOG [Contexto] mensaje. En main, dentro de un contenedor llevaban además códigos de color ANSI salvo que definieras NO_COLOR=1 (lo medí: 62 líneas con secuencias ESC sin la variable, 0 con ella). El PR #8 lo corrige: en producción el logger se crea con colors: false (el nivel sale de LOG_LEVEL, en src/logging.ts, con su prueba) y en la imagen del PR conté 0 líneas con ESC de 110 sin tocar nada. Siguen siendo texto, no JSON (ver «Lo que queda por pulir»).
Validación y errores: el viaje de una petición mala
El 80 % del trabajo de una API real es decir «no» con educación y con la misma forma siempre. Aquí hay tres piezas que lo hacen y que conviene entender juntas: los esquemas de Zod, el ContractValidationPipe y el AllExceptionsFilter.
Un esquema, tres usos
Los esquemas viven en src/schemas/request.schemas.ts (Zod 4) y se usan para tres cosas a la vez: validar la entrada, tipar el controlador y generar OpenAPI. El pegamento es createZodDto de nestjs-zod (versión 5.5.0, vendorizada en vendor/ porque la plantilla fija esa versión):
export const createTaskSchema = z.object({ title: z.string().min(3, "Title must be at least 3 characters long").max(100) /* … */ });
export class CreateTaskRequest extends createZodDto(createTaskSchema) {}

// en el controlador:
async create(@Body() dto: CreateTaskRequest) { /* dto ya está validado y tipado */ }
El truco es que CreateTaskRequest es una clase real (Nest necesita clases para los metadatos de @Body()) cuyo contenido se deriva del esquema. Con class-validator tendrías el esquema repartido en decoradores; aquí es un objeto que puedes reutilizar, componer (.extend, .pick, ...listParams) y probar suelto.
El pipe: el mensaje depende de dónde falló
ContractValidationPipe envuelve al ZodValidationPipe de nestjs-zod por una razón concreta: la librería solo lleva el ZodError, y la API de referencia (la de Hono) devuelve un mensaje distinto según el origen del fallo. El pipe lo traduce. Salida real contra mi instancia local:
POST /api/tasks   {"title":"ab","status":"nope"}
HTTP 400
{"success":false,"message":"Validation error in request payload",
 "errors":{"title":["Title must be at least 3 characters long"]}, "meta":{…}}

GET /api/tasks?limit=-5
HTTP 400
{"success":false,"message":"Invalid request query parameters",
 "errors":{"limit":["Too small: expected number to be >=1"]}, "meta":{…}}
Mira la primera: yo envié también "status":"nope" y no aparece en errors. Es el comportamiento por defecto de z.object: los campos desconocidos se descartan en silencio, no se rechazan. Es lo contrario de .strict(). Para una API pública suele ser lo cómodo; si prefieres que un cliente con un campo mal escrito se entere, tendrías que añadir .strict() en los esquemas. Y es la razón por la que mi prueba de asignación masiva (role: "admin" en el registro) terminó en role: "user": el campo no llega al servicio.
El filtro: la tabla de traducción
AllExceptionsFilter es un @Catch() sin argumentos: atrapa todo. Lo que hace es una cadena de if ordenada de lo más específico a lo más general. La tabla, leída del código y confirmada con las pruebas del repositorio y con curl donde se indica:
| Qué se lanza | Código | Mensaje | Comprobado |
|---|---|---|---|
Error de body-parser entity.parse.failed |
400 | Malformed JSON in request body |
curl |
entity.too.large (más de 100 KB) |
413 | Payload Too Large: … maximum permitted limit of 100 KB. |
curl |
ZodValidationException |
400 | Validation error in request payload + errors |
curl |
ZodSerializationException |
500 | Internal server error. (el detalle va al log) |
solo lectura de código |
Prisma P2002 (único violado) |
409 | Conflict: A record with the same unique value already exists. |
lectura de código |
Prisma P2025 (no encontrado) |
404 | Resource not found. |
lectura de código |
| Otro error conocido de Prisma | 500 | Internal server error. |
lectura de código |
RateLimitedException |
429 | cuerpo propio con retryAfterSeconds + cabecera Retry-After |
curl |
RetryAfterException (bloqueo de cuenta) |
429 | sobre estándar + Retry-After |
curl |
NotFoundException de enrutado («Cannot GET /x») |
404 | Route not found: GET /x |
curl |
Cualquier otra HttpException |
su código | su mensaje (y details si lo lleva) |
curl |
| Cualquier otra cosa | 500 | Internal server error. |
lectura de código |
Tres detalles finos que me parecen buenas decisiones:
- El 404 de enrutado se reescribe. Nest responde por defecto
Cannot GET /nada; el filtro lo cambia aRoute not found: GET /nadapara que sea idéntico al de la plantilla de Hono. Sin eso, un cliente tendría que tratar dos formatos de 404. - El 500 no filtra nada en producción. Solo con
NODE_ENV=developmentel mensaje del error interno se incluye endetails; conproductionel cuerpo es siempreInternal server error.y la traza va al log. (Esto lo leo del código; no provoqué un 500 real para verlo.) - Los errores de body-parser no pasan por el filtro. Express procesa el cuerpo antes de que Nest enrute, así que el 400/413 sale de un middleware de error en
configure-app.ts, no del filtro. Los dos usan el mismo constructor de cuerpos (buildErrorPayload) para que el resultado sea idéntico; hay incluso una rama «cinturón y tirantes» en el filtro por si algún día cambia el orden.
Un 404 que no es lo que parece
Una petición GET /api/tasks/no-es-uuid devuelve 404 («Task with ID 'no-es-uuid' not found»), no 400. Los identificadores se tratan como cadenas opacas: no se exige formato UUID en la ruta. Es coherente con el diseño (un id que no existe y un id mal formado son lo mismo para el cliente) y evita validar de más, pero conviene saberlo si esperabas un 400.
Registro: el hueco entre «comprobar» y «crear»
El register hace primero un findUnique por email y, si no existe, un create. Entre ambas operaciones hay un hueco en el que otra petición puede colarse. Lo que decide el resultado no es el código de la aplicación, sino el índice único de la base de datos y el filtro (P2002 → 409). Lo probé con 8 peticiones simultáneas con el mismo email, tres rondas, y luego con 12 en la batería de ataques:
ronda 1 (8 registros simultáneos, mismo email):   1 × 201   7 × 409
ronda 2:                                          1 × 201   7 × 409
ronda 3:                                          1 × 201   7 × 409
12 registros simultáneos del mismo email:         201: 1, 409: 11
SELECT email, count(*) … GROUP BY email  →  una fila por email (3 filas, count=1)
logs: 0 líneas ERROR
Exactamente un ganador, ningún 500 y ninguna fila duplicada. Esa es la diferencia entre «comprobar y luego insertar» a secas y hacerlo con una restricción única detrás: la comprobación previa es solo para dar un mensaje amable; la garantía la da el índice.
Autenticación por dentro
Este es el corazón de la plantilla y la parte en la que más tiempo he invertido. Te lo cuento en el orden en que ocurre.
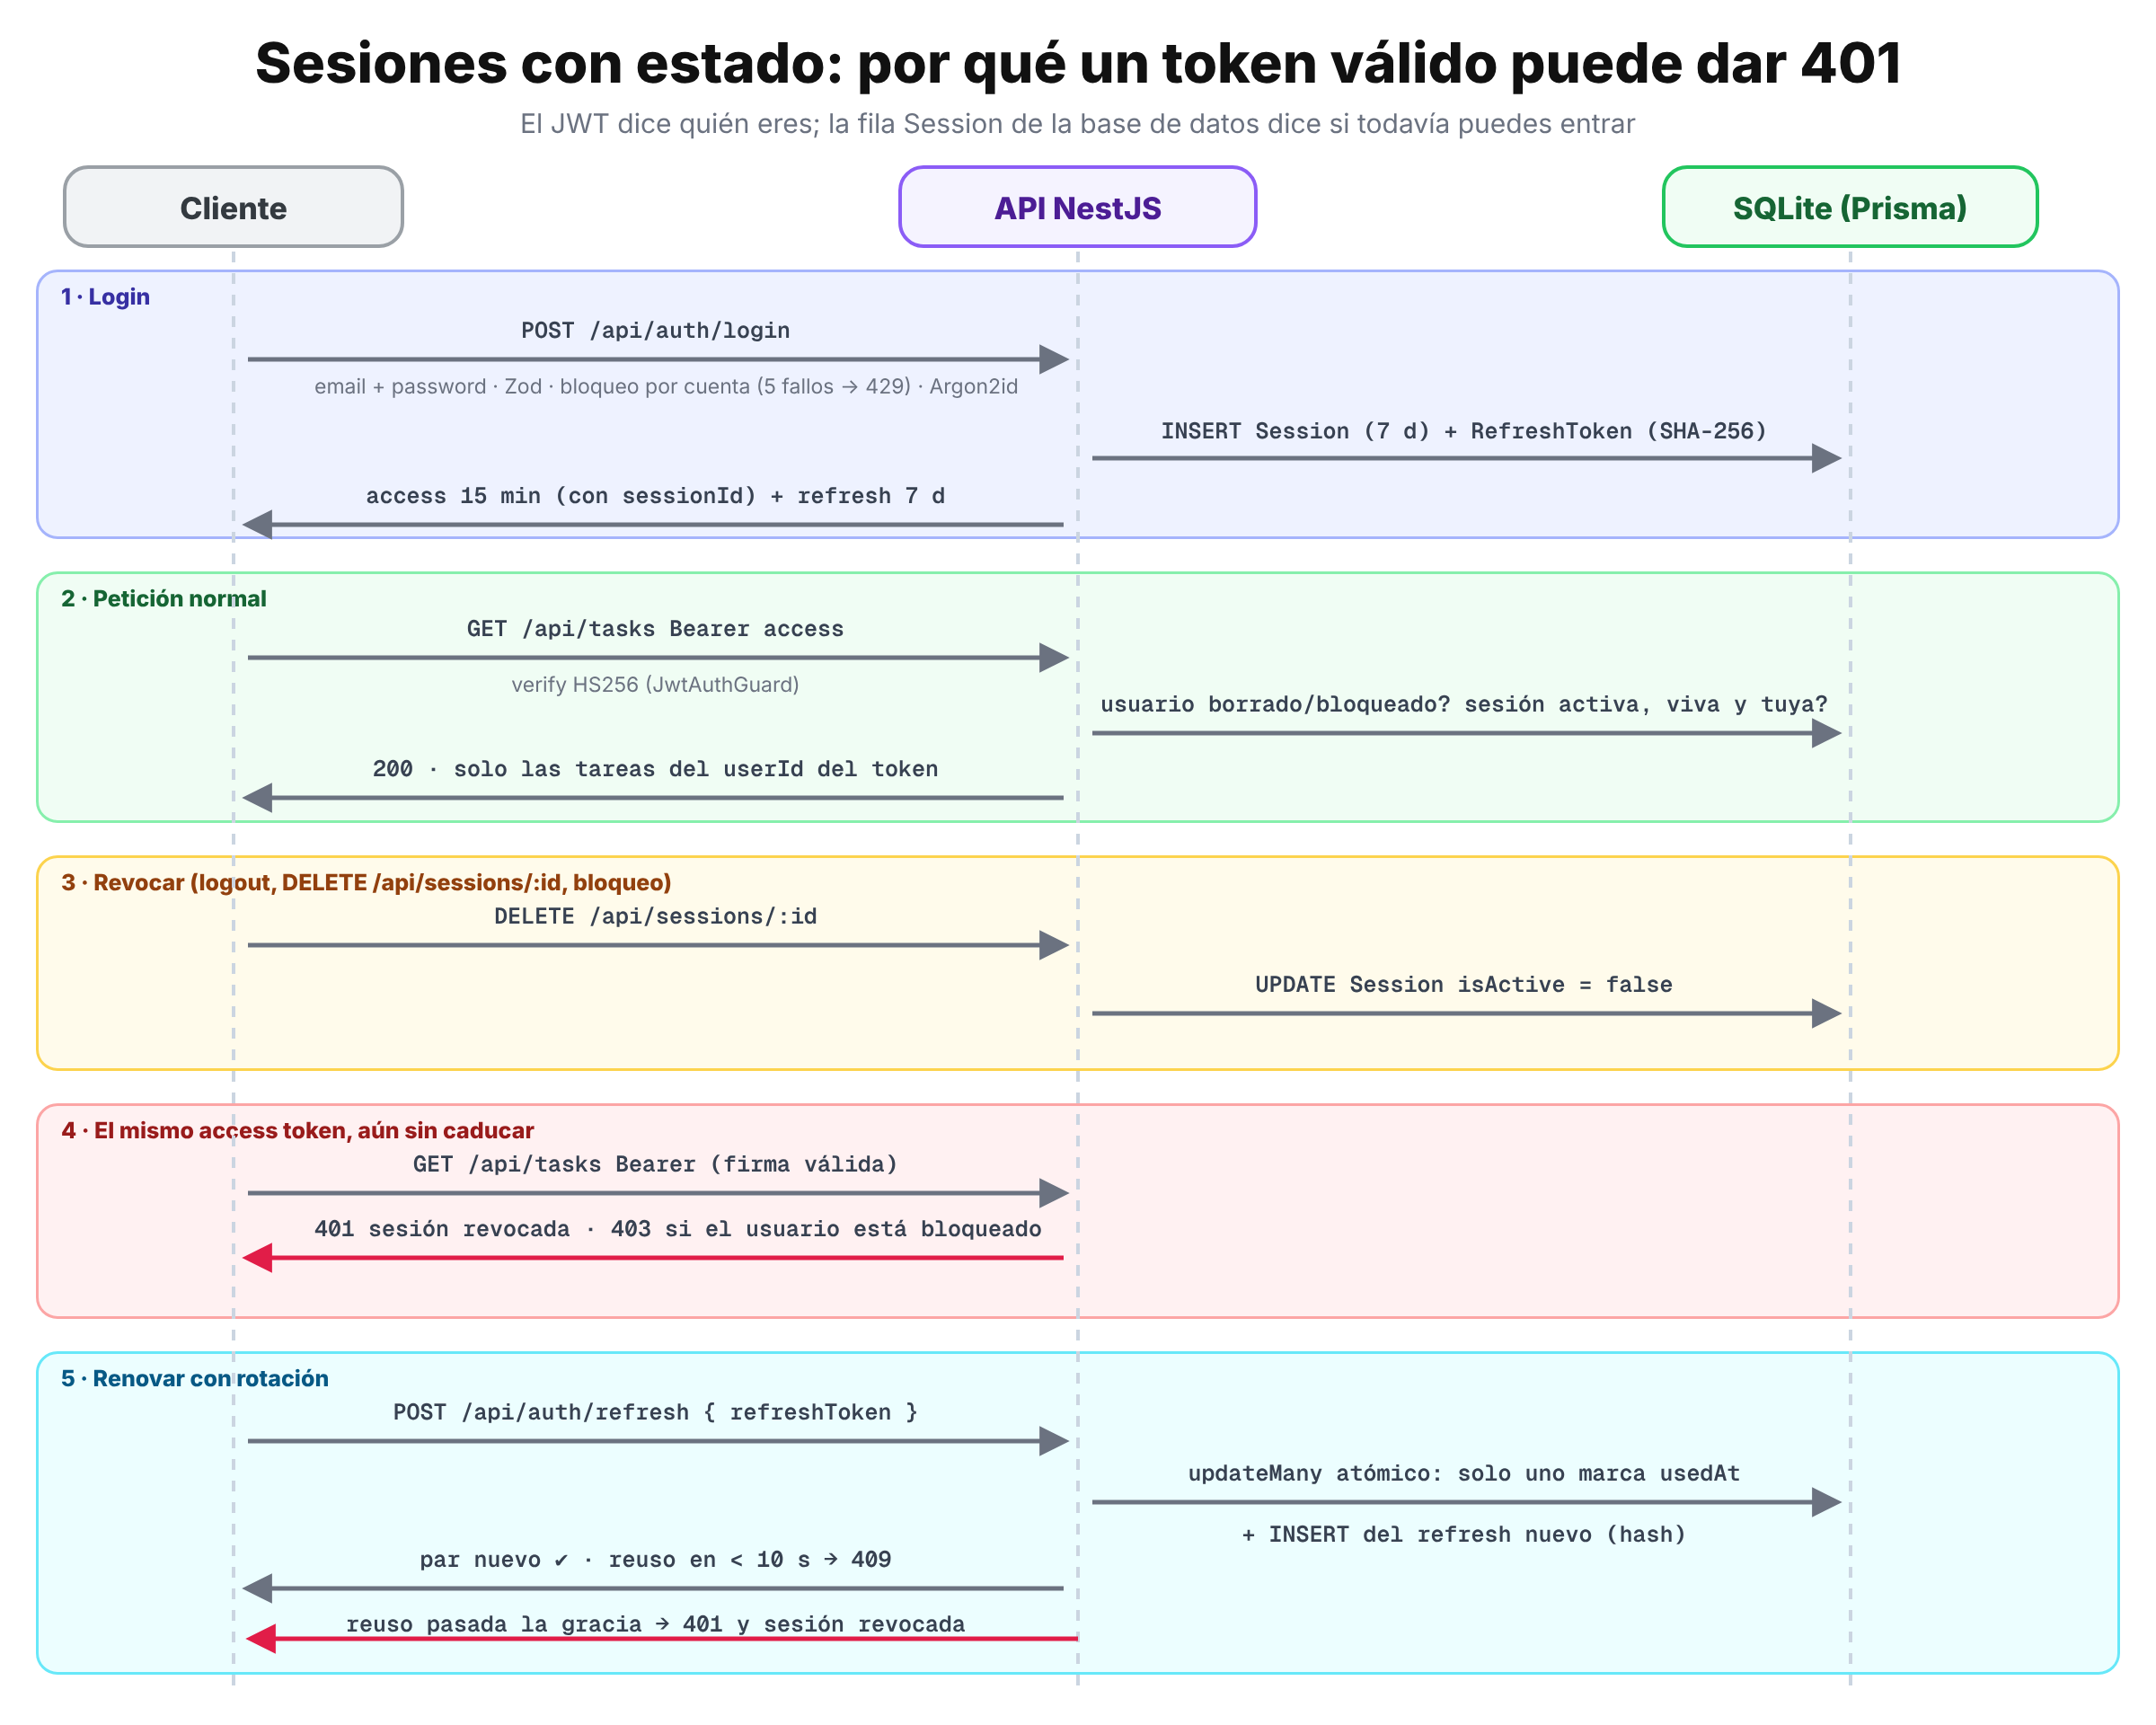
1. Contraseñas: Argon2id, con un truco contra el timing
src/common/utils/password.ts usa Argon2id con los parámetros mínimos recomendados por OWASP (19 MiB de memoria, 2 iteraciones, 1 hilo):
const ARGON2_OPTIONS = { memoryCost: 19_456, timeCost: 2, parallelism: 1 } as const;

export async function comparePassword(plainPassword: string, stored: string): Promise<boolean> {
  if (stored.startsWith("$argon2")) return verify(stored, plainPassword);
  if (stored.startsWith("$2")) return bcrypt.compare(plainPassword, stored); // legacy
  return false;   // formato desconocido: falla cerrado
}

export function needsRehash(stored: string): boolean {
  return !stored.startsWith("$argon2");
}
Tres cosas buenas aquí. Primera: un formato de hash desconocido nunca autentica. Segunda: si vienes de una versión antigua con bcrypt, los hashes antiguos siguen valiendo y se actualizan en el sitio tras el siguiente login correcto (migración progresiva, sin reescribir nada en masa). Tercera: cuando el email no existe, el login compara contra un hash falso real (getDummyHash()), para que existir o no existir tarde lo mismo. Lo comprobé en la base de datos: los hashes guardados tienen la forma $argon2id$v=19$m=19456,t=2,p=1$….
¿Y el timing? Medí el login de un email existente con contraseña incorrecta contra uno inexistente, en varias rondas (limpiando los contadores entre una y otra): las medianas se solapan (17,9–34,7 ms existente, 18–23,4 ms inexistente) y un login correcto tarda unos 17 ms. No es una prueba estadística seria, pero no vi ninguna diferencia sistemática.
memoryCost/timeCost y mide.2. El login, paso a paso
El método login de auth.controller.ts hace, en este orden:
- Bloqueo por cuenta antes de mirar la contraseña (5 fallos → 429 durante 15 minutos), incluso para emails que no existen.
- Busca el usuario (con
omit: { password: false }solo aquí) y compara con el hash real o con el falso. - Si falla:
lockout.recordFailure(email)y un registroLOGIN_FAILEDen auditoría con un seudónimo del email (nunca la dirección en claro). - Solo después de acertar la contraseña comprueba si la cuenta está bloqueada o sin verificar (así no se puede enumerar el estado de una cuenta sin saber su contraseña).
- Si el usuario tiene 2FA activado, exige el código TOTP o un código de recuperación (
MFA_REQUIRED/MFA_INVALID). - Rehash a Argon2id si hace falta, reinicio del contador y creación de la sesión.
{
  "success": true,
  "message": "Authentication successful",
  "accessToken": "eyJhbGciOiJIUzI1NiIs…",
  "refreshToken": "eyJhbGciOiJIUzI1NiIs…",
  "expiresIn": 900,
  "sessionId": "24bd1ca5-75b1-42b1-8…",
  "user": { "id": "user-2", "name": "Ana García", "email": "[email protected]", "role": "user" },
  "meta": { "requestId": "20e9a244-…", "timestamp": "2026-10-24T05:51:19.946Z", "durationMs": 137.34, "apiVersion": "2.0.0" }
}
El access token dura 15 minutos y lleva el sessionId; el refresh token se firma con otro secreto y la sesión tiene un tope absoluto de 7 días. Los refresh tokens se guardan solo como hash SHA-256.
3. El guard que lo revisa todo en cada petición
JwtAuthGuard es global: todas las rutas exigen autenticación salvo las marcadas con @Public() (deny-by-default, mejor que al revés). Este es su corazón, recortado:
payload = this.jwt.verify<JwtPayload>(token, { secret: this.env.JWT_SECRET, algorithms: ["HS256"] });
// …
const [user, session] = await Promise.all([
  this.prisma.user.findUnique({ where: { id: payload.userId },
    select: { id: true, role: true, isBlocked: true, blockedReason: true, deletedAt: true } }),
  this.prisma.session.findUnique({ where: { id: payload.sessionId },
    select: { userId: true, isActive: true, expiresAt: true } }),
]);
if (!user || user.deletedAt)  throw new UnauthorizedException("…no longer exists.");
if (user.isBlocked)           throw new ForbiddenException("Access denied: Account has been suspended…");
if (!session?.isActive || session.userId !== user.id || session.expiresAt < new Date())
  throw new UnauthorizedException("Session has been revoked or expired. Please sign in again.");
request.user = { userId, sessionId, email, role: user.role };   // el rol sale de la BD
Por eso un token con la firma perfecta puede dar 401 (la sesión se revocó) o 403 (el usuario está bloqueado) antes de que caduque, y por eso el rol se lee de la base de datos y no del token: si degradas a un administrador, el cambio vale en la siguiente petición. El precio: dos lecturas de BD por petición autenticada (son por clave primaria y van en paralelo con Promise.all).
Hay una pieza más, el AuthPrefixMiddleware, que existe por una razón sutil: un guard global solo se ejecuta en rutas que coinciden. Sin él, un sondeo a /api/tasks/lo/que/sea sin token devolvería 404 y filtraría qué rutas existen. Con él, los cuatro prefijos protegidos (/api/sessions, /api/users, /api/tasks, /api/audit-logs) y todas sus subrutas dan 401 sin token. Con Express 5 el comodín se escribe {*splat}:
...["api/sessions", "api/users", "api/tasks", "api/audit-logs"].flatMap((prefix) => [
  { path: prefix, method: RequestMethod.ALL },
  { path: `${prefix}/{*splat}`, method: RequestMethod.ALL },
]),
Lo comprobé con curl: GET /api/tasks/no/existe sin token → 401; con token → 404.
4. Rotación de refresh tokens y detección de robo
Cada refresh token solo vale una vez. El truco para que dos peticiones simultáneas no ganen las dos es un updateMany atómico dentro de una transacción:
const rotated = await this.prisma.$transaction(async (tx) => {
  const claimed = await tx.refreshToken.updateMany({
    where: { tokenHash, sessionId, usedAt: null, expiresAt: { gt: now } },
    data: { usedAt: now },
  });
  if (claimed.count !== 1) return false;       // alguien lo usó antes que yo
  await tx.refreshToken.create({ data: { tokenHash: hashToken(next.refreshToken), userId: user.id, sessionId, expiresAt: next.refreshExpiresAt } });
  return true;
});
// si no ganó: ¿fue hace menos de REFRESH_REUSE_GRACE_SECONDS (10 s)? → 409 (concurrente)
// si fue hace más → se considera robo: revokeSession(sessionId) y 401
Lo que pasó en mis pruebas reales:
| Prueba | Resultado |
|---|---|
| Refresh con un token válido | 200, par nuevo |
| Reusar ese mismo token al instante | 409 («already rotated by a concurrent request») |
| 3 refresh simultáneos con el mismo token | 200, 409, 409 (exactamente uno gana) |
| Reusar un token ya rotado pasados 11 s | 401 y la sesión queda revocada; 1 fila TOKEN_REUSE_DETECTED en auditoría |
| Usar el access token como refresh, y el refresh como Bearer | 401 en ambos casos |
Es decir: la «familia» de tokens es la sesión, y revocarla no desloguea al usuario en sus otros dispositivos. Matiz honesto: la ventana de gracia de 10 s significa que un atacante que reproduzca un token dentro de esos segundos solo recibe un 409, no una revocación.
5. Fuerza bruta, bloqueo y rate limiting
Hay dos capas y conviene no confundirlas:
- Por IP (
RateLimitGuard): contadores de ventana fija en la base de datos (RateLimitBucket), así que valen para varias instancias. Se aplica solo a las rutas con@RateLimit(...): login 10/min, refresh 30/min, registro 5/h, recuperación y MFA. DevuelveX-RateLimit-LimityX-RateLimit-Remaining. Si el almacén falla, en las rutas críticas aplica una ventana local en memoria (RATE_LIMIT_ON_DB_FAILURE=local) en vez de abrirse. - Por cuenta (
LoginLockoutService): 5 fallos → 15 minutos de bloqueo, con una clave seudonimizada, comprobado antes de la contraseña.
intentos 1–5 con contraseña incorrecta → 401
intento 6 (incluso con la contraseña CORRECTA) → 429, Retry-After: 900
la sesión admin que ya estaba abierta → sigue funcionando
11ª petición de login desde una IP → 429
13 emails distintos desde la misma IP → 429 a partir del 11º
rotando X-Forwarded-For / CF-Connecting-IP / X-Real-IP con TRUST_PROXY=false → 429 igualmente
Un matiz que conviene saber: el bloqueo por cuenta es también una palanca de denegación: cualquiera puede dejar a un usuario sin poder iniciar sesión 15 minutos (sus sesiones abiertas no se ven afectadas). Es un compromiso habitual y está documentado, pero es un compromiso.
6. 2FA con TOTP y códigos de recuperación
Con AUTH_MODE=full, un usuario puede activar TOTP (SHA-1, 6 dígitos, 30 s, ±1 ventana). Los detalles que importan y que comprobé de extremo a extremo:
- Para iniciar la configuración (
/api/auth/mfa/setup) hay que reconfirmar la contraseña: con una incorrecta, 403. - El secreto se guarda cifrado con AES-256-GCM (en la BD empieza por
v1.); la clave esMFA_ENCRYPTION_KEY, y conMFA_ENCRYPTION_KEY_PREVIOUSse puede rotar sin perder los dispositivos ya enrolados (el ensayoops-rehearsal.sh mfa-rotationpasó: K1 → K1+K2 → K2, con el secreto recifrado de forma perezosa). enablecon000000→ 400; con un código real → devuelve 10 códigos de recuperación (solo se guardan sus hashes).- Login sin código →
MFA_REQUIRED; código erróneo →MFA_INVALID(y cuenta como fallo para el bloqueo); código correcto → 200. - Un código TOTP no se puede reutilizar (
totpLastStep): repetirlo da 401. Un código de recuperación funciona una vez y luego da 401.
enable no sirve para el login siguiente si estás en el mismo intervalo de 30 s, por la protección contra repetición. Es el comportamiento correcto, pero en un script de pruebas hay que esperar al siguiente intervalo.7. Verificación de email y recuperación de contraseña
Los correos no se envían dentro de la petición HTTP: se encolan en EmailOutbox y un worker los entrega con reintentos acotados (5 intentos, con espera). Los enlaces llevan un token aleatorio de un solo uso del que solo se guarda el hash SHA-256, y está atado al email al que se envió: si el usuario cambia de email, el enlace viejo deja de valer. forgot-password valida el cuerpo y responde sin revelar si la cuenta existe (hay una prueba del contrato que lo fija; con MAIL_TRANSPORT=none lo vi devolver 202).
Esta parte la comprobé con el harness de contrato (grupo recovery, 11 pruebas en verde) usando un servidor SMTP de pruebas que incluye el propio repositorio. No he probado un envío real con un proveedor SMTP.
8. El limitador por dentro: una fila, una sentencia
El limitador por IP y el bloqueo por cuenta comparten una sola tabla, RateLimitBucket, que es lo más simple que se puede imaginar:
CREATE TABLE "RateLimitBucket" ("key" TEXT NOT NULL PRIMARY KEY, "count" INTEGER NOT NULL, "resetAt" DATETIME NOT NULL)Después de seis intentos de login fallidos a [email protected] y un séptimo con la contraseña correcta (que también dio 429), esto es lo que había en la tabla (consulta real a la base de datos de mi instancia local):
('rl:login:127.0.0.1',                       7, '2026-10-24T06:35:14.252+00:00')   ← 7 peticiones en la ventana de 1 min
('lockout:a163bdfbd5cea78c30b92db0067a6552', 5, '2026-10-24T06:49:14.395+00:00')   ← 5 fallos, bloqueo 15 min
Dos cosas se ven a simple vista. El 6.º intento ya devolvió 429 y no sumó al contador de fallos (se quedó en 5): la comprobación de bloqueo va antes de la contraseña. Y la clave de bloqueo no lleva el email, lleva un seudónimo (lockout:a163…), un HMAC con una clave derivada de JWT_SECRET. Quien lea la tabla no obtiene direcciones de correo.
El código que incrementa el contador es esta función de 30 líneas:
async hit(key: string, windowMs: number): Promise<Bucket> {
  for (let attempt = 0; attempt < 3; attempt++) {
    const now = new Date();
    // 1) incremento atómico de una ventana viva
    const updated = await this.prisma.rateLimitBucket.updateMany({
      where: { key, resetAt: { gt: now } }, data: { count: { increment: 1 } },
    });
    if (updated.count === 0) {
      // 2) no hay ventana viva: borra la caducada (si existe) y abre una nueva
      await this.prisma.rateLimitBucket.deleteMany({ where: { key, resetAt: { lte: now } } });
      try {
        return await this.prisma.rateLimitBucket.create({ data: { key, count: 1, resetAt: new Date(now.getTime() + windowMs) }, select: { count: true, resetAt: true } });
      } catch (error) {
        // 3) otra instancia abrió la ventana primero: reintenta como incremento
        if (error instanceof Prisma.PrismaClientKnownRequestError && error.code === "P2002") continue;
        throw error;
      }
    }
    const bucket = await this.prisma.rateLimitBucket.findUnique({ where: { key }, select: { count: true, resetAt: true } });
    if (bucket) return bucket;
  }
  throw new Error(`Could not update rate limit bucket '${key}'`);
}
No hay leer–modificar–escribir en código de aplicación: cada paso es una sentencia atómica y la carrera se resuelve con la clave primaria (el P2002) y un bucle de hasta tres intentos. Es un diseño que funciona con varias instancias compartiendo una base de datos (Turso), que es justo para lo que está pensado.
Para el bloqueo, recordFailure añade una pieza más: tras sumar el fallo llama a slide(), que empuja resetAt hacia adelante. Es una ventana deslizante: el bloqueo se mide desde el último fallo, no desde el primero. Sin ello, cinco fallos repartidos a lo largo de 14 minutos desbloquearían la cuenta un minuto después del último.
Y el guard, cuando la tabla no está disponible, no se limita a «abrir la mano»:
// RATE_LIMIT_ON_DB_FAILURE=local (por defecto): login, refresh, register, recuperación y MFA
// siguen limitados con una ventana en memoria del proceso; el resto de rutas falla abierto.
// Además cuenta métricas: storeFailures, localAllowed, localBlocked, openAllowed.Promise.all desde Node (todos a la vez), contra una instancia local con la configuración por defecto y con el límite por IP elevado a 1000 para aislar el bloqueo por cuenta:
Escenario
401
429
Valores por defecto (límite por IP: 10/min), Promise.all
10
20
Límite por IP a 1000, Promise.all
30
0
Valores por defecto, 30 procesos curl lanzados en segundo plano
6
24
Con la configuración por defecto, el límite por IP corta la ráfaga en 10 (y el bloqueo de cuenta aún no se ha activado en ese momento). Sin ese límite, las 30 peticiones pasaron por la comprobación y solo la siguiente (la correcta) recibió el 429 de Retry-After: 900. Con curl, que arranca cada proceso con unos milisegundos de diferencia, el bloqueo se activó tras 6. Conclusión práctica: «5 intentos» son 5 intentos en serie; un atacante con muchas IPs y peticiones paralelas puede gastar más. No lo considero grave, pero es la cifra honesta.9. TOTP: comprobado contra los vectores de la RFC 6238
La plantilla no usa ninguna librería de TOTP: implementa HOTP/TOTP en unas 80 líneas con node:crypto (createHmac("sha1", …), truncamiento dinámico, timingSafeEqual). Eso se puede fiar si y solo si coincide con los vectores oficiales, así que los ejecuté contra TotpService compilado. El apéndice B de la RFC 6238 da códigos de 8 dígitos para el secreto ASCII 12345678901234567890; el servicio emite 6, que son los seis últimos dígitos:
secreto base32: GEZDGNBVGY3TQOJQGEZDGNBVGY3TQOJQ
t=59           RFC: 94287082 → últimos 6: 287082 | servicio: 287082 OK
t=1111111109   RFC: 07081804 → últimos 6: 081804 | servicio: 081804 OK
t=1111111111   RFC: 14050471 → últimos 6: 050471 | servicio: 050471 OK
t=1234567890   RFC: 89005924 → últimos 6: 005924 | servicio: 005924 OK
t=2000000000   RFC: 69279037 → últimos 6: 279037 | servicio: 279037 OK
Cinco de cinco. Y el comportamiento alrededor del código, también real:
mismo paso, lastStep=null                  → 56666666   (paso aceptado: se devuelve el contador)
mismo paso, lastStep=paso                  → null       (repetición rechazada)
código del paso anterior (+30 s después)   → 56666666   (dentro de la ventana ±1)
código con 90 s de retraso                 → null       (fuera de ventana)
código '12345' (5 dígitos)                 → null
El método verifyTotp recorre siempre los tres candidatos (paso−1, paso, paso+1) y no sale al primer acierto, con timingSafeEqual en cada comparación: así el tiempo de respuesta no revela cuál coincidió. La condición step > lastStep impide reutilizar un código, y MfaService la convierte en una sentencia atómica (updateMany … WHERE totpLastStep IS NULL OR totpLastStep < step): dos peticiones simultáneas con el mismo código no pueden ganar las dos.
El cifrado en reposo, ejecutado igualmente:
cifrado: v1 . 16 car. . 22 car. . 43 car.          ← versión . IV (12 bytes) . etiqueta GCM . texto cifrado
dos cifrados del mismo secreto iguales?  false      ← IV aleatorio
descifrar con K1:                       {"secret":"GEZD…","fromPreviousKey":false}
descifrar con K2 (previous=K1):         {"secret":"GEZD…","fromPreviousKey":true}   ← y MfaService lo recifra con K2
descifrar con una clave ajena      →    Unable to decrypt TOTP secret: no configured MFA key matches
cifrado manipulado (1 carácter)    →    Unable to decrypt TOTP secret: no configured MFA key matches
Esa última línea es la gracia de AES-GCM: no solo cifra, autentica. Cambiar un solo carácter del texto cifrado hace que el descifrado falle en vez de devolver basura. Y los códigos de recuperación (xguy-uxd6-6b4o-b7km, 16 caracteres base32 = 80 bits aleatorios) se guardan solo como SHA-256: 80 bits de entropía hacen innecesario un hash lento.
10. La bandeja de salida de correo: simulada con tiempo virtual
La verificación de email y la recuperación de contraseña dependen de que el correo salga aunque el proveedor falle o el proceso se reinicie. Eso lo resuelve EmailOutboxService, un patrón conocido (transactional outbox): la petición solo escribe una fila (EmailOutbox) y un worker la entrega, con reintentos. Las piezas, en orden:
- Reclamar una fila es atómico:
updateMany WHERE id = … AND status = 'pending'pasa la fila asending. Dos instancias no pueden entregar el mismo correo; la que pierde la carrera busca la siguiente. - Filas huérfanas. Si un worker muere con la fila en
sending, a los 5 minutos otro la vuelve apending. - El token se crea al entregar, no al encolar. Así el token en claro nunca se guarda: en la fila solo hay
userIdytype. - Fallos terminales sin reintentar: con
MAIL_TRANSPORT=none, o si la cuenta ya no existe o está bloqueada, la fila se retira en el acto (no tiene sentido reintentar).
El comentario del código decía «5 intentos, ≈15 minutos» (en main sigue diciéndolo). Quise comprobarlo y lo hice sin red ni SMTP: instancié el servicio compilado con una base de datos en memoria falsa y un transporte que siempre falla, y avancé un reloj virtual:
WARN  Email delivery failed (attempt 1/5, type=email_verify), retrying in 30s
t=   0 s → intento 1 fallido, estado=pending
WARN  Email delivery failed (attempt 2/5, …), retrying in 60s
t=  30 s → intento 2 fallido, estado=pending
WARN  Email delivery failed (attempt 3/5, …), retrying in 120s
t=  90 s → intento 3 fallido, estado=pending
WARN  Email delivery failed (attempt 4/5, …), retrying in 240s
t= 210 s → intento 4 fallido, estado=pending
ERROR Email delivery abandoned after 5 attempts (type=email_verify)
t= 450 s → intento 5 fallido, estado=failed
métricas: {"enqueued":0,"sent":0,"retried":4,"failed":1}
El resultado real: se rinde a los 450 segundos (7,5 minutos), no a los ≈15 minutos del comentario. La tabla de esperas tenía cinco valores (30, 60, 120, 240 y 480 s), pero el quinto intento es el último y, al fallar, no hay un «siguiente»: la espera de 480 s nunca se usaba. Es un detalle menor (el usuario siempre puede pedir otro enlace), pero es el tipo de cosa que solo aparece cuando ejecutas el código. El PR #8 deja la tabla en cuatro esperas (30, 60, 120 y 240 s) y corrige el comentario a «7,5 minutos»: el comportamiento no cambia, solo deja de mentir. (La traza de arriba es la medida original sobre 758a0ac; no la repetí con el cambio.)
11. La limpieza horaria
CleanupService arranca con un ciclo inmediato y un temporizador cada hora (con unref(), para no impedir que el proceso termine). Qué borra y cuándo:
| Qué | Se borra cuando |
|---|---|
| Sesiones | caducadas, o inactivas desde hace más de 24 h (los refresh tokens caen por ON DELETE CASCADE) |
| Refresh tokens | caducados, o rotados hace más de 24 h |
Tokens de correo (AuthToken) |
caducados, o usados hace más de un día |
| Códigos de recuperación | usados hace más de 30 días (los no usados se quedan hasta que se reinicie el 2FA) |
| Ventanas del limitador | resetAt ya pasado |
| Auditoría | más antigua que AUDIT_RETENTION_DAYS (90 por defecto; 0 la conserva siempre) |
| Bandeja de salida | filas sent/failed de hace más de 30 días |
Hay una sutileza que me gustó: purgar un refresh token rotado no rompe la detección de robo. Un token ya purgado que alguien reproduzca no coincide con ninguna fila, y el código lo trata igual que uno reutilizado (revoca la sesión). Y los fallos de limpieza se atrapan y se registran: un error en la limpieza nunca tumba la petición ni el proceso.
Los recursos: tareas, usuarios, sesiones y auditoría
Con AUTH_MODE=full el OpenAPI generado tiene 25 paths, 31 operaciones y 18 esquemas. Así se reparten (las etiquetas son las de Scalar):
| Grupo | Rutas | Quién |
|---|---|---|
| System | GET /healthz (más GET / con el índice de la API) |
Público |
| Auth | POST /api/auth/register, login, refresh, logout |
Público (con rate limit) salvo logout |
| Auth (recuperación) | forgot-password, reset-password, verify-email, resend-verification |
Público (con rate limit) |
| MFA | POST /api/auth/mfa/setup, enable, disable · DELETE /api/users/:id/mfa |
Usuario autenticado · admin |
| Sessions | GET /api/sessions/me, DELETE /api/sessions/:sessionId, POST /api/sessions/revoke-all |
Usuario |
| Tasks | GET/POST /api/tasks, GET/PUT/DELETE /api/tasks/:id, POST /api/tasks/:id/restore |
Usuario (solo las suyas; admin con scope=all) |
| Users | GET/POST /api/users, GET/PUT/DELETE /api/users/:id, PATCH …/block, PATCH …/role, POST …/revoke-sessions |
Admin |
| Audit | GET /api/audit-logs |
Admin |
Las listas aceptan paginación, ordenación y filtros con corchetes, y include para relaciones. Un ejemplo real con el administrador de la demo (todas las tareas, las que contienen «UI», con su usuario):
curl -g "localhost:3011/api/tasks?scope=all&filter[title][contains]=UI&include=user&sort=-createdAt" \
  -H "authorization: Bearer $TOKEN"
{
"success": true,
"data": [
{ "id": "task-3", "userId": "user-2", "title": "Design Frontend UI",
"description": "Build web dashboard consuming the REST API.", "completed": false,
"deletedAt": null, "createdAt": "2026-10-24T05:43:37.489Z",
"user": { "id": "user-2", "email": "[email protected]", "name": "Ana García" } }
],
"pagination": { "total": 1, "page": 1, "limit": 10, "totalPages": 1, "hasNextPage": false, "hasPrevPage": false },
"meta": { "requestId": "7cf2680b-…", "timestamp": "2026-10-24T05:44:12.010Z", "durationMs": 8.09, "apiVersion": "2.0.0" }
}Reglas de acceso que verifiqué con un usuario normal: 403 en todas las rutas de administrador (usuarios, auditoría, scope=all), y 404 (no 403) al pedir una tarea o una sesión ajena, para que no se pueda sondear qué identificadores existen. Los ataques de asignación masiva no funcionan: registrarse con role: "admin" da role: "user", un PUT con role no lo cambia y una tarea enviada con userId, id o deletedAt ignora esos campos. Las tareas se borran de forma lógica (DELETE) y se pueden restaurar (POST …/restore). Además hay protecciones del último administrador: no se puede degradar, bloquear ni borrar (409/400).
Documentación OpenAPI y Scalar
La documentación se genera con @nestjs/swagger y la integración con Zod, y se sirve con Scalar en /docs (y el JSON en /openapi.json). Verifiqué que /docs responde 200 text/html en desarrollo y 404 en producción (salvo ENABLE_DOCS=true), con una CSP propia solo para esa ruta. La spec es OpenAPI 3.0.0 con un esquema de seguridad BearerAuth, y el repositorio incluye una prueba que la valida con @apidevtools/swagger-parser. Y, como te enseñé arriba, los módulos desactivados por AUTH_MODE desaparecen de la documentación.
A diferencia de la de Hono, donde cada ruta se declara una sola vez y la documentación sale del mismo código que valida, aquí la validación (Zod) y la documentación (decoradores @ApiOperation…) se escriben en sitios distintos del controlador. Funciona y la prueba de contrato ayuda a que no se desincronicen, pero la posibilidad de que deriven existe.
Tutorial: añadir un recurso nuevo (notas privadas), de punta a punta
Hasta aquí he descrito la plantilla. Ahora la uso. El ejercicio: añadir un recurso Note (notas privadas de cada usuario) con CRUD completo, siguiendo las convenciones del repositorio. Lo hice en una copia del repositorio, no en el original, y todo lo que ves a continuación está ejecutado: el código, las migraciones, las pruebas y las respuestas. El resultado fue un modelo de Prisma, una migración, 4 ficheros nuevos, 3 líneas en app.module.ts (con el import) y 7 pruebas.
npm install y exporta DATABASE_URL=file:/ruta/a/tu.db solo para los comandos de Prisma. Para npm test, desexporta DATABASE_URL: la suite crea sus propias bases de datos temporales y, si la variable está definida, en main 21 de las 62 pruebas fallan (lo sufrí; está en «Problemas reales y cómo los resolví»). El PR #8 lo corrige: la suite fuerza siempre una base SQLite temporal.Paso 1: el modelo (prisma/schema.prisma)
model Note {
  id        String   @id @default(uuid())
  userId    String
  title     String
  body      String   @default("")
  pinned    Boolean  @default(false)
  createdAt DateTime @default(now())
  updatedAt DateTime @updatedAt

  user User @relation(fields: [userId], references: [id], onDelete: Cascade)

  // Listado del dueño: primero las fijadas, luego las más recientes
  @@index([userId, pinned, createdAt])
}
Y en model User, la relación inversa: notes Note[]. Dos decisiones: onDelete: Cascade (si se borra un usuario, se van sus notas, igual que ocurre con sus sesiones) y un índice compuesto que coincide con la consulta del listado (dueño → fijadas → fecha).
Paso 2: la migración
npx prisma migrate dev --name notesPrisma generó prisma/migrations/20261024061724_notes/migration.sql con este contenido, sin que yo escribiera una línea de SQL:
-- CreateTable
CREATE TABLE "Note" (
    "id" TEXT NOT NULL PRIMARY KEY,
    "userId" TEXT NOT NULL,
    "title" TEXT NOT NULL,
    "body" TEXT NOT NULL DEFAULT '',
    "pinned" BOOLEAN NOT NULL DEFAULT false,
    "createdAt" DATETIME NOT NULL DEFAULT CURRENT_TIMESTAMP,
    "updatedAt" DATETIME NOT NULL,
    CONSTRAINT "Note_userId_fkey" FOREIGN KEY ("userId") REFERENCES "User" ("id") ON DELETE CASCADE ON UPDATE CASCADE
);

-- CreateIndex
CREATE INDEX "Note_userId_pinned_createdAt_idx" ON "Note"("userId", "pinned", "createdAt");
La migración se versiona en git y es lo que ejecuta el contenedor al arrancar (prisma migrate deploy). Un detalle curioso: al guardar el esquema, prisma format realineó las columnas de otro modelo (EmailOutbox) que yo no toqué. Es solo espacio en blanco, pero te ensucia el diff: revisa siempre qué ficheros cambian antes de hacer commit.
Paso 3: los esquemas de Zod (src/schemas/request.schemas.ts)
/** Notas: crear (los valores por defecto los pone Zod) */
export const createNoteSchema = z.object({
  title: z.string().trim()
    .min(1, { message: "Title is required" })
    .max(100, { message: "Title cannot exceed 100 characters" })
    .meta({ example: "Idea para el viernes" }),
  body: z.string().max(5000, { message: "Body cannot exceed 5000 characters" }).optional().default(""),
  pinned: z.boolean().optional().default(false),
});

/** Notas: actualizar. Sin `default()`: un PUT parcial no debe pisar campos que no envía */
export const updateNoteSchema = z
  .object({
    title: z.string().trim().min(1).max(100).optional(),
    body: z.string().max(5000).optional(),
    pinned: z.boolean().optional(),
  })
  .refine((data) => Object.keys(data).length > 0, {
    message: "Provide at least one field to update (title, body or pinned)",
  });

/** Notas: query del listado */
export const noteQuerySchema = z.object({
  ...listParams,
  pinned: z.enum(["true", "false"]).optional(),
  sortBy: z.enum(["createdAt", "title"]).default("createdAt"),
});
Mira la diferencia entre crear y actualizar: en crear, body y pinned llevan .default(); en actualizar, no. Si los llevaran, un PUT con solo { "title": "nuevo" } pondría body a "" y pinned a false: borraría datos sin avisar. Es un error clásico con Zod y lo cubre una de las pruebas. El .refine rechaza un cuerpo vacío ({}), y listParams reutiliza la paginación del resto de la API.
Paso 4: DTO, servicio, controlador y módulo
El DTO son tres líneas (createZodDto convierte cada esquema en una clase):
export class CreateNoteRequest extends createZodDto(createNoteSchema) {}
export class UpdateNoteRequest extends createZodDto(updateNoteSchema) {}
export class NoteQuery extends createZodDto(noteQuerySchema) {}
El servicio es el lugar para la regla importante: toda consulta lleva el userId del dueño, de modo que olvidarlo sea imposible por construcción.
@Injectable()
export class NotesService {
  constructor(private readonly prisma: PrismaService) {}

  async list(userId: string, q: { page: number; limit: number; search?: string; pinned?: string; sortBy: "createdAt" | "title"; order: "asc" | "desc" }) {
    const where: Prisma.NoteWhereInput = { userId };
    if (q.pinned !== undefined) where.pinned = q.pinned === "true";
    if (q.search) where.OR = [{ title: { contains: q.search } }, { body: { contains: q.search } }];
    const [total, items] = await Promise.all([
      this.prisma.note.count({ where }),
      this.prisma.note.findMany({
        where, skip: (q.page - 1) * q.limit, take: q.limit,
        orderBy: [{ pinned: "desc" }, { [q.sortBy]: q.order }],   // las fijadas siempre primero
      }),
    ]);
    return { total, items };
  }

  /** 404 tanto si no existe como si es de otro usuario: no se puede sondear qué ids existen */
  async getOwned(userId: string, id: string) {
    const note = await this.prisma.note.findFirst({ where: { id, userId } });
    if (!note) throw new NotFoundException(`Note with ID '${id}' not found.`);
    return note;
  }

  create(userId: string, data: { title: string; body: string; pinned: boolean }) {
    return this.prisma.note.create({ data: { ...data, userId } });
  }
  async update(userId: string, id: string, data: Prisma.NoteUpdateInput) {
    await this.getOwned(userId, id);
    return this.prisma.note.update({ where: { id }, data });
  }
  async remove(userId: string, id: string) {
    await this.getOwned(userId, id);
    await this.prisma.note.delete({ where: { id } });
  }
}
Fíjate en getOwned: devuelve 404 tanto si la nota no existe como si es de otro usuario. Un 403 le diría a un atacante «ese id existe, pero no es tuyo». El 404 no filtra nada.
El controlador es donde se ve el estilo de Nest: decoradores para la ruta, la documentación OpenAPI y la inyección. Estos son los puntos clave (completo, son 80 líneas):
@ApiTags("Notes")
@ApiBearerAuth("BearerAuth")
@Controller("api/notes")
export class NotesController {
  constructor(private readonly notes: NotesService, private readonly audit: AuditService) {}

  @Get()
  @ApiOperation({ summary: "Listar mis notas", description: "Paginado; las fijadas salen primero." })
  async list(@Query() q: NoteQuery, @AuthUser() user: AuthUserPayload) {
    const { total, items } = await this.notes.list(user.userId, q);
    return { data: items, pagination: buildPagination(total, q.page, q.limit) };
  }

  @Post()
  async create(@Body() dto: CreateNoteRequest, @AuthUser() user: AuthUserPayload, @Req() req: Request) {
    const note = await this.notes.create(user.userId, dto);
    await this.audit.record(req, { userId: user.userId, action: "CREATE", entity: "Note", entityId: note.id });
    return { message: "Note created successfully.", data: note };
  }
  // PUT :id, DELETE :id y GET :id siguen el mismo patrón
}
Nota que no hay ningún @UseGuards. No hace falta: el guard de JWT es global y deny-by-default, así que un controlador nuevo nace protegido. Tampoco construyo el sobre de respuesta ni gestiono errores: devuelvo { data, pagination } y el TransformInterceptor lo envuelve; lanzo NotFoundException y el filtro lo convierte al formato de error. Cada pieza hace una cosa, y yo solo escribo la que es mía.
El módulo, por último, tiene diez líneas:
@Module({ controllers: [NotesController], providers: [NotesService] })
export class NotesModule {}
Ni PrismaService ni AuditService aparecen en imports: son globales (ver la tabla de módulos).
Paso 5: registrarlo (y el gotcha que me dio un 404)
En app.module.ts hay que hacer dos cosas, y la segunda es la que se olvida:
// 1) montar el módulo solo cuando hay autenticación
...(features.auth ? [SessionsModule, AuthModule, UsersModule, AuditLogsModule, NotesModule] : []),

// 2) añadir el prefijo al AuthPrefixMiddleware
...["api/sessions", "api/users", "api/tasks", "api/audit-logs", "api/notes"].flatMap(/* … */)
Lo primero es obvio: con AUTH_MODE=none las notas no tienen dueño, así que el módulo no se monta. Lo segundo no lo es. Escribí primero la prueba «una subruta inexistente sin token debe dar 401» y falló con 404:
await http().get("/api/notes").expect(401);
await http().get("/api/notes/a/b/c").expect(401);   // sin el prefijo en el middleware: 404
Sin el prefijo, la ruta /api/notes sí era 401 (el guard global la cubre), pero /api/notes/a/b/c daba 404 y, con ello, filtraba que /api/notes es un prefijo real. Añadí "api/notes" a la lista y pasó. Esa es la trampa de la plantilla: la protección profunda de rutas depende de una lista escrita a mano. Y, como cuento en la sección de pruebas, en 758a0ac ninguna prueba del repositorio la vigilaba: si añadías un recurso y olvidabas la línea, nadie te avisaba. Mi prueba la convierte en una comprobación automática. El PR #8 añade test/auth-prefix.middleware.spec.ts, que recorre los cuatro prefijos originales, pero esa lista de la prueba también está escrita a mano: un recurso nuevo sigue necesitando su propia comprobación, como la mía.
Paso 6: las pruebas
Las pruebas siguen el estilo del repositorio (supertest contra la aplicación real, sin simular la base de datos): test/notes.spec.ts tiene 7 casos y cubre lo que importa de este recurso. Estos son los casos, con los nombres tal como los escribí en el fichero:
 PASS  test/notes.spec.ts
  notes: un recurso nuevo de punta a punta
    ✓ exige autenticación, también en subrutas que no existen
    ✓ valida el cuerpo y aplica los valores por defecto
    ✓ lista solo las notas propias, con las fijadas primero
    ✓ una nota ajena responde 404, igual que una que no existe
    ✓ un PUT parcial no pisa los campos que no envía y uno vacío da 400
    ✓ borrar y dejar rastro en la auditoría
    ✓ aparece en la especificación OpenAPI
La suite completa con mis 7 pruebas nuevas (sobre 758a0ac, con las 62 de entonces):
Test Suites: 10 passed, 10 total
Tests:       69 passed, 69 total
Time:        10.366 s
Es decir, 62 originales + 7 nuevas = 69, en 10 segundos. La rama del PR #8 tiene hoy 84 pruebas en 13 suites; no repetí el tutorial encima de ella. Durante el desarrollo me encontré dos problemas más, ambos con su solución en «Problemas reales y cómo los resolví»: un 429 inesperado al registrar tantos usuarios de prueba desde la misma IP (el límite de registro es 5 por hora) y el DATABASE_URL exportado que rompía la suite (corregido en el PR #8).
Paso 7: probarlo con curl
Levanté la copia con node dist/main.js y probé a mano. Respuestas reales (con los meta recortados):
# crear (el título llega con espacios; Zod lo recorta y pone los valores por defecto)
POST /api/notes {"title":"  Idea para el viernes  ","pinned":true}
HTTP 201
{"success":true,"message":"Note created successfully.",
 "data":{"id":"19ba614d-fd75-46e4-826a-4e0129af2467","userId":"080ff971-…","title":"Idea para el viernes","body":"","pinned":true,
         "createdAt":"2026-10-24T06:33:58.922Z","updatedAt":"2026-10-24T06:33:58.922Z"},"meta":{…}}

# crear con datos inválidos (dos errores a la vez, agrupados por campo)
POST /api/notes {"title":"","body":123}
HTTP 400
{"success":false,"message":"Validation error in request payload",
 "errors":{"title":["Title is required"],"body":["Invalid input: expected string, received number"]},"meta":{…}}

# listar con limit=2 (3 notas en total: la fijada primero, luego la más reciente)
GET /api/notes?limit=2
HTTP 200
{"success":true,"data":[ {"title":"Idea para el viernes","pinned":true,…}, {"title":"Llamar al banco","pinned":false,…} ],
 "pagination":{"total":3,"page":1,"limit":2,"totalPages":2,"hasNextPage":true,"hasPrevPage":false},"meta":{…}}

# buscar
GET /api/notes?search=banco   →   ['Llamar al banco']  {total: 1, page: 1, limit: 10, totalPages: 1, …}

# PUT vacío
PUT /api/notes/<id> {}
HTTP 400
{"success":false,"message":"Validation error in request payload",
 "errors":{"_root":["Provide at least one field to update (title, body or pinned)"]},"meta":{…}}
Paso 8: la documentación se actualiza sola
Sin tocar nada de OpenAPI, el documento pasó de 25 rutas y 31 operaciones a 27 rutas y 36 operaciones (/api/notes y /api/notes/{id}), y de 18 a 20 esquemas (CreateNoteRequest y UpdateNoteRequest). Eso es lo mejor de generar la especificación desde el código: no hay un fichero que se te olvide.
noteQuerySchema hereda listParams, que incluye sort e include. Aparecen en la documentación de GET /api/notes… pero mi servicio no los implementa: los ignora. La documentación generada promete algo que el código no cumple. Si reutilizas un esquema compartido, comprueba qué parámetros documentas de más. (En mi tutorial lo dejé así para mostrarlo; en un proyecto real o los implementas o usas .omit() en el esquema.)Lo que cuesta añadir un recurso
Contando solo lo que escribí: un modelo de 14 líneas, ~30 de esquemas Zod, 4 ficheros de código (DTO, servicio, controlador, módulo: unas 150 líneas en total), 3 líneas de registro y 108 de pruebas. Cada pieza tiene su sitio y ninguna es opcional. En Hono hay menos ceremonia (rutas y esquemas en un par de ficheros); aquí hay más ficheros, pero cada uno es predecible, y en un equipo grande eso es una ventaja: nadie discute dónde va cada cosa.
Probar la API
Las pruebas del repositorio (reales, en mi máquina)
| Qué | Resultado |
|---|---|
npm run typecheck |
Limpio (~2 s) |
npm run lint |
Limpio (~2 s) |
npm test (Jest 30) |
84 pruebas en 13 suites, todas en verde, en unos 12 s (en 758a0ac: 62 en 9 suites, 8–10 s) |
npm run test:cov |
Cobertura: 67,21 % sentencias, 53,27 % ramas, 63,34 % funciones, 67,03 % líneas (en 758a0ac: 66,38 / 51,64 / 63,05 / 66,14) |
npm run contract — modo full |
95 pruebas, 0 fallos (7,2 s) |
npm run contract — modo basic |
76 pruebas, 0 fallos (recuperación y MFA se saltan: no existen) |
npm run contract — modo none |
32 pruebas, 0 fallos |
bash scripts/bruno-smoke.sh |
29 peticiones conformes, 0 inesperadas; Users/Delete User se omite a propósito (borra usuarios demo). Medido el 24 de octubre en 758a0ac; no lo repetí con el PR |
bash test-api.sh |
Recorrido completo de sesiones y bloqueos con curl, en verde (24 de octubre, 758a0ac; no lo repetí con el PR) |
npx prettier --check . |
1 fichero con formato distinto (.github/workflows/ci.yml, que el PR no toca); en 758a0ac eran 26 |
npm audit y npm audit --omit=dev |
0 vulnerabilidades las dos (en 758a0ac: 4 altas, todas de multer) |
Las 13 suites de Jest son app, auth-prefix.middleware, concurrency, email-outbox, env-guards, lockout-key, logging, password, rate-limit-resilience, system-docs, test-isolation, totp y trust-proxy (las cuatro que no estaban en main son auth-prefix.middleware, logging, system-docs y test-isolation). Me gusta que la concurrencia tenga su propia suite: comprueba que de varios refresh simultáneos gana exactamente uno, que la revocación gana a un refresh que corre a la vez, y que los contadores de rate limit son atómicos (admiten exactamente max). Y test-isolation fija que la suite nunca escribe en una base remota ni habla con un servidor de correo real.
El harness de contrato (npm run contract) arranca la app con una base de datos nueva por modo y ejecuta 11 escenarios HTTP (system, mounting, auth, sessions, tasks, users, audit, recovery, mfa, ratelimit, ratelimit-login) con un servidor SMTP de pruebas incluido. Fija los comportamientos concretos que tenía la plantilla de Hono: ids de la semilla, mensajes, códigos de estado. Es lo que da sentido al «paridad» del que habla el README.
jest.config.js fija mínimos de cobertura por fichero para las rutas críticas (guard de rate limit, bloqueo, jwt-auth.guard, hashing, TOTP…), una buena práctica.main, el setup-env.ts de Jest usaba process.env.DATABASE_URL ??= …: si tenías DATABASE_URL exportado en tu shell, los tests lo usaban (y escribían en esa base). Yo lo tenía apuntando a una base de laboratorio ya usada y fallaron 21 de 62; al quitarlo, volvieron a pasar las 62. El PR hace que el setup-env.ts fuerce siempre una base SQLite temporal y limpie también TURSO_DATABASE_URL y SMTP_URL, con una prueba que lo fija: lo comprobé exportando las tres variables y las 84 pruebas pasaron sin crear el fichero al que apuntaba DATABASE_URL. Si trabajas sobre main, haz unset DATABASE_URL antes de npm test.Si rompo el código, ¿lo notan las pruebas? Un experimento de mutaciones
Que una suite esté en verde no dice mucho; lo que importa es si se pondría en rojo ante un fallo. Así que hice un experimento sencillo, de los que se llaman pruebas de mutación hechas a mano: copié el repositorio, rompí a propósito once trozos de código críticos (de uno en uno, restaurando después cada uno), y ejecuté las dos suites que trae la plantilla: las 62 pruebas de Jest y el «arnés de contrato» (95 pruebas HTTP contra el servidor compilado). Cada mutante es una frase: «¿qué pasaría si alguien cambiara esto?». (El experimento es del 24 de octubre, sobre 758a0ac; el único mutante que repetí sobre la rama del PR #8 es M8, más abajo.)
| # | Mutación (lo que rompí) | Jest (62) | Contrato (95) |
|---|---|---|---|
| M1 | Refresh: leer y luego escribir, en lugar del updateMany atómico |
sobrevive | sobrevive |
| M1b | Igual, con una espera de 25 ms entre leer y escribir (carrera ampliada) | sobrevive | sobrevive |
| M2 | Refresh: quitar la condición usedAt: null |
detectado (1 fallo) | detectado (1 fallo) |
| M3 | Guard: dejar de comprobar la sesión | detectado (1 fallo) | no compila |
| M4 | Limitador: contador de leer-modificar-escribir | sobrevive | sobrevive |
| M5 | TOTP: permitir reutilizar un código | detectado (1 fallo) | sobrevive |
| M6 | Login: el hash «falso» deja de ser un hash real | detectado (1 fallo) | sobrevive |
| M7 | Env: aceptar el mismo secreto en los dos JWT | detectado (1 fallo) | sobrevive |
| M8 | AuthPrefixMiddleware: quitar el prefijo api/tasks |
sobrevive (con el PR #8 lo detecta: 2 fallos) | sobrevive |
| M9 | Prisma: quitar el omit global de la contraseña |
sobrevive | detectado (5 fallos) |
| M10 | Bloqueo de cuenta: contar fallos pero no bloquear nunca | detectado (1 fallo) | no compila |
(«No compila»: TypeScript rechazó mi mutación antes de poder ejecutar el arnés. Es una defensa gratis, pero no una prueba de que la suite lo vería.)
Lectura honesta del resultado: de 11 mutantes, 7 los detecta alguna de las dos suites y 4 sobreviven a las dos (M1, M1b, M4 y M8; con el PR #8, M8 deja de sobrevivir). Y se ve algo interesante: las dos suites son complementarias. Jest atrapa fallos de lógica fina (TOTP, el hash falso, el entorno); el arnés de contrato atrapa lo que se ve desde fuera (que la contraseña no salga en las respuestas). Ninguna de las dos por sí sola vale: Jest se dejó pasar M9; el contrato se dejó pasar M5, M6 y M7.
Los supervivientes merecen un párrafo cada uno:
- M8, el prefijo olvidado. Es el fallo que me dio el 404 en el tutorial de «notas». Si alguien quita
api/tasksde la lista del middleware, ninguna prueba falla, y a partir de ahíGET /api/tasks/lo/que/seasin token devuelve 404 en vez de 401. No hay explotación directa (no se expone ningún dato), pero sí un filtrado de qué rutas existen. La solución eran unas pocas líneas de prueba, y es lo primero que añadí en mi copia (mi prueba de «notas» ya lo hace para su prefijo). El PR #8 incorpora esa prueba, y repetí M8 sobre la rama: quitoapi/tasksde la lista y ahora fallan 2 pruebas. No repetí los otros diez mutantes. - M1 y M1b, la rotación no atómica. Aquí está lo más instructivo. El código real usa un
updateManycondicional, que es lo correcto. Pero cuando lo sustituí por «leer y luego escribir», ninguna suite lo notó, ni siquiera ampliando la carrera con 25 ms de espera. La razón es SQLite: con una base de datos embebida de un solo escritor, las transacciones interactivas se serializan y el código no atómico parece atómico. Dicho de otro modo: la prueba de concurrencia de esta plantilla no puede distinguir el código correcto del incorrecto en SQLite. Con Turso (varias instancias contra una base de datos remota) la carrera sí existiría. El código está bien; lo que falta es una prueba que lo demuestre en un entorno donde importe. - M4, el contador del limitador. Sustituí el
updateManyatómico por «leer el contador, sumar uno y escribir». Ninguna de las dos suites lo notó, por la misma razón que en M1: con un solo escritor la carrera no se materializa, y los tests de límite hacen peticiones secuenciales. El código real es correcto; lo que falta es una prueba que lo demuestre bajo concurrencia real.
Un último detalle de higiene, y una corrección de mi propio experimento: en una primera pasada del arnés de contrato, M2 y M4 mostraron decenas de fallos con fetch failed. No eran fallos de la plantilla ni detección real: yo mismo había matado con pkill el servidor de otra prueba que corría en paralelo en la misma máquina. Repetí todos los mutantes del arnés de contrato con la máquina en reposo y los números de la tabla son los de esa repetición limpia (M2 pasó de «22 fallos» a 1 y M4 de «detectado» a «sobrevive»). Lo cuento porque un experimento contaminado que no se corrige es peor que no hacerlo.
La integración continua
El workflow «CI & Typecheck» ejecuta: npm audit, comprobación de que las migraciones coinciden con el esquema (migrate diff), typecheck, build, ESLint, construcción de la imagen Docker, escaneo con Trivy (falla con vulnerabilidades altas o críticas con arreglo disponible), un SBOM CycloneDX como artefacto, Jest con cobertura y la matriz de contrato (full/basic/none) más el humo de Bruno. Las acciones están fijadas por SHA y Dependabot revisa npm, Docker y Actions cada semana. El último run de main (758a0ac, el 23 de octubre a las 19:42, hora de Madrid) terminó en verde. La parte de Docker y Trivy sí la ejecuté yo en local (resultados en «Docker y despliegue»; adelanto: en 758a0ac Trivy marcaba un multer alto que habría hecho fallar ese paso, y con el PR #8 sale limpio); el SBOM no lo generé, así que de ese paso me fío del historial de CI. El PR #8 no toca ningún workflow (el token con el que lo subí no tiene permiso workflow), así que la CI no se ha ejecutado con los cambios, sigue sin prettier --check y todo lo anterior lo comprobé en local.
Lo que he atacado (y qué pasó)
Todo lo que sigue lo lancé solo contra mi instancia local (base de datos de laboratorio, puertos de loopback). Es una batería con scripts propios (fetch de Node), no una herramienta de pentesting, y no sustituye una auditoría; pero cubre lo que más suele romperse:
| Ataque | Resultado |
|---|---|
JWT manipulado: role=admin sin resignar, alg=none, secreto equivocado, caducado, firma alterada, Bearer vacío, esquema Basic |
401 en todos |
| Reuso de refresh (inmediato, concurrente ×3, tras 11 s) | 409 · 200/409/409 · 401 con sesión revocada y auditoría |
| Fuerza bruta de login (6 intentos, correcto incluido) | 429 a partir del 6º, Retry-After: 900 |
Rotar X-Forwarded-For, CF-Connecting-IP, X-Real-IP con TRUST_PROXY=false |
Siguen contando como la misma IP → 429 |
Inyección SQL (' OR '1'='1, ' OR 1=1; DROP TABLE User; --…) en el login, en search/filter/sort/completed y en el id de la ruta |
401/400/404, las tablas intactas |
Filtrar por un campo no permitido; pedir password con include |
El filtro se ignora; el hash no sale |
Asignación masiva (rol en registro y PUT, userId/id/deletedAt en tareas) |
Ignorado en todos los casos |
Un título con <script> y SQL |
Se guarda tal cual: es una API JSON, escapar al pintar es cosa del cliente |
| Acceso a rutas de admin / a recursos ajenos con un usuario normal | 403 / 404 |
| Cuerpo de 110 KB; JSON mal formado | 413 / 400 en el sobre estándar |
Revocación inmediata (logout, revoke-all, bloquear al usuario, último admin) |
La siguiente petición ya da 401 / 403; el último admin está protegido |
Estos son los números del TRUST_PROXY real (14 logins con emails distintos, TRUST_PROXY=true, TRUST_PROXY_HOPS=1), que es donde más suelen equivocarse las plantillas:
| Escenario | Resultado |
|---|---|
Cliente directo que rota X-Forwarded-For en cada petición (sin proxy que reescriba) |
Eludía el límite (todos 401): es la advertencia de la documentación, la red debe estar cerrada y el proxy debe sobrescribir la cabecera |
Proxy que añade su IP (falsa-i, 203.0.113.9) |
429 a partir del 11º: se lee la IP de la derecha |
Proxy que sobrescribe X-Forwarded-For y recibe CF-Connecting-IP y X-Real-IP falsificadas |
429 a partir del 11º: esas cabeceras se ignoran |
Es el mismo problema de la IP real que anoté en la plantilla de Hono; aquí TRUST_PROXY_HOPS es un número y solo se lee X-Forwarded-For desde la derecha. La parte de «mi red tiene que estar cerrada» sigue siendo responsabilidad tuya.
Segunda tanda: asignación masiva, tipos, tokens falsos y rutas
Con la primera tanda cubrí fuerza bruta, inyección, JWT y cabeceras. En la segunda fui a por lo que un revisor de seguridad probaría después. Todo contra mi instancia local (nada fuera de mi máquina), con respuestas reales:
| Prueba | Resultado |
|---|---|
Registro con __proto__, constructor.prototype y role=admin |
201 pero role=user; un registro posterior sigue siendo normal (sin contaminación de prototipos) |
Esa cuenta recién creada hace GET /api/users |
403 («requires administrator privileges») |
PUT de una tarea con __proto__ y un userId ajeno |
200, pero el userId sigue siendo el mío |
Login con Content-Type: text/plain |
400 |
Login con formulario application/x-www-form-urlencoded |
200 (¡acepta formularios!) |
| JSON con 90 000 corchetes anidados (<100 KB) | 400 («Malformed JSON»), sin colgar el servidor |
| Objeto anidado a 5 000 niveles | 401 (se trata como credenciales inválidas) |
Query con search de 20 000 caracteres / 2 000 parámetros repetidos |
431 (cabeceras demasiado grandes) |
| Título de 101 caracteres | 400 |
| Contraseña de 76 bytes (19 caracteres de 4 bytes) | 400 («Password cannot exceed 72 bytes (accented characters and emoji take more than one)») |
| Registrar el mismo email con otras mayúsculas / con espacios | 409 / 409 (se normaliza) |
| 12 registros simultáneos del mismo email | {201: 1, 409: 11} |
| Refresh token usado como access token, y al revés | 401 / 401 |
| Token con la firma válida pero algoritmo HS512 | 401 |
Token firmado con la clave real y role=admin, sesión de un usuario normal |
403 (el rol sale de la base de datos) |
Firma válida con un sessionId inexistente / sin sessionId |
401 / 401 |
PATCH /api/tasks, DELETE /api/auth/login, GET /api/auth/login |
404 en las tres (el mismo sobre de error) |
GET /.env, /dist/main.js, /prisma/schema.prisma, /docs/%2e%2e/.env y similares |
404 en todas |
X-Request-Id con <script> / de 500 caracteres |
se ignora y se genera un UUID (36 caracteres) |
X-Request-Id: ok-id-123 |
se respeta tal cual |
Lo que más me gusta de esta tabla es la fila del token «firmado con la clave real»: aunque un atacante consiguiera el secreto JWT y fabricara un token con role=admin, no obtendría privilegios, porque la plantilla ignora el rol del token y lo lee de la base de datos en cada petición. Ese es el coste de dos consultas por petición que mencioné antes, y aquí se ve lo que compra.
POST /api/auth/login acepta application/x-www-form-urlencoded además de JSON (lo comprobé con curl -d 'email=…&password=…': 200). No es una vulnerabilidad por sí misma, pero amplía la superficie: un formulario HTML en otro dominio puede enviar un POST de este tipo sin una petición previa de CORS (preflight). La API no usa cookies, así que no hay CSRF clásico (el token va en una cabecera que el navegador no añade solo), pero si algún día añadieras sesiones por cookie, esto sería lo primero que vigilar. Lo apunto como «bajo» y con una solución trivial: rechazar cualquier Content-Type que no sea JSON.Endurecimiento de seguridad: lo que hay y lo que falta
Resumen de lo que hay, todo comprobado salvo lo marcado:
- Cabeceras (helmet + propias), verificadas en una respuesta:
Content-Security-Policy,Strict-Transport-Security: max-age=31536000; includeSubDomains,Referrer-Policy: no-referrer,Cache-Control: no-store,X-Content-Type-Options: nosniff,Cross-Origin-Opener-PolicyyCross-Origin-Resource-Policy: same-origin,X-Frame-Options: SAMEORIGIN, másX-Request-IdyServer-Timing. - Fail closed en configuración, migraciones y formatos de hash desconocidos (visto arriba).
- Secretos: JWT distintos, de 32+ caracteres en producción; clave de MFA dedicada y rotable.
- Datos personales en logs de seguridad: el email se seudonimiza; las contraseñas y TOTP nunca salen en consultas (
omit). - CORS por lista en producción; en desarrollo es
*, y lo verifiqué (Access-Control-Allow-Origin: *); en producción solo respondió al origen configurado. - Documentación apagada en producción (
/docsy/openapi.json→ 404). - Contenedor (probado, ver «Docker y despliegue»): usuario
node, sistema de ficheros de solo lectura,cap_drop: ALL,no-new-privileges, 512 MB y 1 CPU, puerto publicado solo en127.0.0.1. - Cadena de suministro en CI: base fijada por digest, acciones fijadas por SHA,
npm audit(0 avisos en la rama del PR #8), Trivy (lo ejecuté en local; 0 altos o críticos con arreglo) y SBOM (sin probar localmente). - Copias de seguridad cifradas: el ensayo
ops-rehearsal.sh backup-restorehace unVACUUM INTO, cifra el resultado con age (ChaCha20-Poly1305), comprueba que un fichero manipulado se rechaza, restaura y verifica que el login y el gruposystemdel contrato funcionan sobre lo restaurado. Lo ejecuté tras instalarage1.2.1 y pasó entero.
Esto es lo que devuelve GET /healthz en una instancia local (recortado):
HTTP/1.1 200 OK
X-Request-Id: 548dad19-62a2-4dec-b324-9f1c925eb14e
Content-Security-Policy: default-src 'self';base-uri 'self';…;script-src 'self';…;upgrade-insecure-requests
Cross-Origin-Opener-Policy: same-origin
Cross-Origin-Resource-Policy: same-origin
Referrer-Policy: no-referrer
Strict-Transport-Security: max-age=31536000; includeSubDomains
X-Content-Type-Options: nosniff
X-Frame-Options: SAMEORIGIN
Cache-Control: no-store
Access-Control-Allow-Origin: *        # modo desarrollo
Server-Timing: total;dur=1.5

{"status":"healthy","timestamp":"…","uptimeSeconds":1,"database":{"status":"connected","latencyMs":0}}
Y lo que no hace (o hace con matices) está en «Lo que queda por pulir» más abajo.
Docker y despliegue
docker-compose.yml, vi pasar el HEALTHCHECK y la escaneé con Trivy. Lo hice primero con 758a0ac (24 de octubre) y, tras las correcciones, con la rama del PR #8 (25 de octubre). Primero describo los ficheros (los del PR) y luego, en «Lo que pasó cuando la construí y la ejecuté de verdad», están los resultados, incluidos los fallos.El Dockerfile
Dos etapas sobre node:24-alpine fijada por digest (en main era node:25-alpine, una línea sin LTS; el PR #8 vuelve a 24, que coincide con engines, con la CI y con AGENTS.md): la primera instala dependencias, genera el cliente de Prisma y compila; la segunda instala solo producción (npm ci --omit=dev --ignore-scripts, reconstruyendo únicamente los paquetes de Prisma que necesitan descargar su motor, y borrando typescript, que entra como peer opcional de Prisma), borra de la imagen final npm, npx, corepack y yarn (menos superficie, y se van las dependencias que npm vendoriza consigo mismo, con CVEs propios; en main solo se borraban npm y npx), copia dist y el cliente generado, y corre como usuario node. Como ya no hay npx en la imagen, el docker-entrypoint.sh ejecuta la CLI de Prisma directamente con node node_modules/prisma/build/index.js, y valida el entorno con el propio loadEnv() de la aplicación antes de migrar:
ENV DATABASE_URL=file:/app/data/prod.db
…
RUN npm ci --omit=dev --ignore-scripts \
  && npm rebuild @prisma/engines prisma \
  && rm -rf node_modules/typescript node_modules/@typescript \
  && npm cache clean --force
…
RUN rm -rf /usr/local/lib/node_modules/npm /usr/local/lib/node_modules/corepack /opt/yarn-* \
  && rm -f /usr/local/bin/npm /usr/local/bin/npx /usr/local/bin/corepack /usr/local/bin/yarn /usr/local/bin/yarnpkg
USER node
…
HEALTHCHECK --interval=30s --timeout=5s --start-period=20s --retries=3 \
  CMD wget -qO- "http://127.0.0.1:${PORT}/healthz" >/dev/null || exit 1
ENTRYPOINT ["./docker-entrypoint.sh"]
CMD ["node", "dist/main.js"]
# docker-entrypoint.sh (fragmento): primero validar, después migrar
node -e 'require("./dist/config/env.js").loadEnv()'
PRISMA="node node_modules/prisma/build/index.js"
$PRISMA migrate deploydocker-compose.yml
ports:
  - "127.0.0.1:3011:3011"      # nunca en todas las interfaces
read_only: true
tmpfs: [ /tmp ]
security_opt: [ "no-new-privileges:true" ]
cap_drop: [ ALL ]
mem_limit: 512m
cpus: "1.0"
volumes:
  - sqlite_data:/app/data      # el fichero SQLite vive aquí
Los secretos se leen del entorno con ${JWT_SECRET:?…}: si faltan, docker compose ni arranca.
Lo que pasó cuando la construí y la ejecuté de verdad
Instalé Docker 26.1.5 en mi máquina de pruebas (con dockerd lanzado a mano, sin systemd), docker-compose 2.26.1 y Trivy 0.76.1, y lo repetí todo con el commit 758a0ac (24 de octubre) y otra vez, tras las correcciones, con la rama del PR #8 (25 de octubre). Estas son las medidas de la rama del PR, con lo que medí en 758a0ac entre paréntesis:
| Qué | Resultado |
|---|---|
| Construcción sin caché | 19,7 s (antes, 20,2 s) |
| Tamaño de la imagen | 570 MB (antes, 719 MB): la capa de npm ci --omit=dev pesa 396 MB (antes, 493 MB) y dist/ ocupa unos 700 kB; el node_modules de producción sigue en unos 424 MiB por la CLI de Prisma y sus motores |
| Base | Alpine 3.24.3 con Node v24.22.1 (antes, Alpine 3.23.4 con Node v25.9.0); el proceso corre como uid=1000(node) |
Arranque hasta /healthz 200 (migraciones incluidas, volumen vacío) |
unos 3–4 s (3,6 s con docker run, contando el arranque del contenedor) |
| Raíz de solo lectura | touch /app/x → Read-only file system; /tmp y /app/data sí son escribibles |
| Privilegios | CapEff: 0000000000000000 y NoNewPrivs: 1 dentro del contenedor |
Sin npm ni compilador |
which npm npx corepack yarn tsc dentro del contenedor no encuentra ninguno |
HEALTHCHECK |
healthy (el script scripts/docker-smoke.sh del PR lo espera y pasa entero; antes, starting a los 5 s y healthy a los 40 s) |
/docs y /openapi.json en producción |
404 los dos |
Parada con docker stop |
156 ms, código de salida 0, y el log dice Received SIGTERM: closing application... (antes, 73 ms: son medidas únicas con docker stop y no sé atribuir la diferencia; la aplicación en sí sale en unos 40 ms, ver «Rendimiento y consumo») |
| Persistencia | Recreé el contenedor con el mismo volumen: No pending migrations to apply., el sembrado de demo desactivado y el login del administrador funciona (medido en 758a0ac; no lo repetí con el PR) |
En 758a0ac lo ejecuté con las mismas opciones del docker-compose.yml (--read-only, --tmpfs /tmp, --cap-drop ALL, no-new-privileges, 512 MB, 1 CPU, volumen en /app/data) y después con el propio docker-compose up -d: el contenedor quedó Up … 127.0.0.1:3011->3011/tcp, y docker inspect confirmó ReadonlyRootfs=true, CapDrop=[ALL], memoria 536.870.912 bytes, 1 CPU y no-new-privileges:true. Sobre la rama del PR repetí la ejecución con esas opciones (docker run) y el scripts/docker-smoke.sh; no volví a levantar el docker-compose, porque el PR no toca el de Nest. Un detalle útil: docker compose lee automáticamente el .env del directorio, así que para comprobar que sin variables no arranca tuve que usar --env-file /dev/null; entonces sí:
error while interpolating services.api.environment.[]: required variable JWT_SECRET is missing a value: Define JWT_SECRET en el entorno o en .envMi primer intento de arrancar el contenedor (en 758a0ac) falló por una razón instructiva: las variables no llegaron al contenedor (un despiste mío con sudo) y el log fue este (recortado):
🚀 Aplicando migraciones de base de datos...
SQLite database prod.db created at file:/app/data/prod.db
10 migrations found in prisma/migrations
Applying migration `0_init`
…
Applying migration `20261023090922_email_outbox`
⚡ Iniciando servidor NestJS...
❌ Critical startup failure: Invalid or missing environment configuration:
{
  "JWT_SECRET": [ "JWT_SECRET is required unless AUTH_MODE=none (…)", "JWT_SECRET must contain at least 32 characters in production (…)" ],
  "MFA_ENCRYPTION_KEY": [ "MFA_ENCRYPTION_KEY (>= 32 chars) is required in production with AUTH_MODE=full so TOTP secrets are encrypted with a dedicated, stable key (…)" ]
}
Dos lecturas: el fallo es claro y a prueba de errores (dice qué variable falta y cómo generarla), pero fíjate en el orden: en main las migraciones se aplican antes de validar el entorno, porque el script de entrada migra y solo después arranca Node. Con un despliegue mal configurado la base de datos ya se ha modificado cuando la aplicación se niega a arrancar. Lo comprobé después con un volumen vacío y sin secretos: el contenedor salía con código 1 y dejaba un prod.db de 192 KB con las migraciones aplicadas.
El PR #8 invierte el orden. El entrypoint ejecuta primero el loadEnv() de la aplicación. Repetí la prueba con un volumen vacío y sin secretos: el contenedor sale con código 1 y el mismo mensaje, pero ya no hay migraciones ni prod.db: el volumen sigue vacío.
❌ Critical startup failure: Invalid or missing environment configuration:
{
  "JWT_SECRET": [ "JWT_SECRET is required unless AUTH_MODE=none (…)", "JWT_SECRET must contain at least 32 characters in production (…)" ],
  "JWT_REFRESH_SECRET": [ … ],
  "MFA_ENCRYPTION_KEY": [ … ]
}758a0ac, Trivy 0.76.1 sobre nestjs-starter:lab daba el sistema operativo (Alpine 3.23.4) limpio (0) y 1 HIGH en las dependencias de Node: multer 2.4.0, con arreglo en 2.5.0 (denegación de servicio por una petición abortada durante el filtrado asíncrono de ficheros; es el mismo paquete que marca npm audit). Con el PR #8 (overrides de multer, Node 24, imagen reconstruida) el mismo comando, con los parámetros del workflow (--ignore-unfixed --severity HIGH,CRITICAL), devuelve 0: Alpine 3.24.3 con 0 y las dependencias de Node con 0. Ojo con lo que significa: --ignore-unfixed esconde lo que todavía no tiene arreglo. El workflow de CI no ha cambiado (exit-code: '1'), así que por lo que dice el fichero, ese paso ahora pasaría; no he ejecutado la CI de GitHub, esto es el escáner en local más la lectura del workflow.Dos cosas más que solo se ven al ejecutarla en contenedor:
- Los logs ya no salen con colores ANSI en producción (corregido en el PR #8). En
758a0ac, dentro del contenedorConsoleLoggerpintaba con códigos de escape si no se le decía lo contrario: sinNO_COLOR, 62 líneas del arranque contenían secuenciasESC; con-e NO_COLOR=1, 0. En la imagen del PR, sin ninguna variable, conté 0 líneas conESCde 110 (docker logs). Si usasmain, ponNO_COLOR=1en tu entorno; los logs siguen siendo texto, no JSON. - El consumo en contenedor se mide de dos maneras. En
758a0ac, con la aplicación en reposo,docker statsmarcaba 79,4 MiB yVmRSSdentro del contenedor 148.020 kB (≈144,6 MiB). Con la imagen del PR (Node 24.22.1) medí 93,8 MiB y 160.880 kB (≈157 MiB), unos segundos después de arrancar y de hacer un login; no sé cuánto de la subida es de la versión de Node y cuánto de cuándo se mide, y no repetí la medida con el mismo protocolo. No son medidas contradictorias:docker statsdescuenta la caché de ficheros del cgroup yVmRSScuenta las páginas residentes, incluidas las que vienen del binario de Node mapeado (esta explicación es mía, no la he verificado con el cgroup). Para comparar con otra plantilla, usa siempre la misma medida.
Quedan sin probar la generación real del SBOM y el despliegue en Coolify (más abajo).
Desplegar en Coolify
Los pasos serían los mismos que con la plantilla de Hono (te los conté en el artículo de Coolify): crear la aplicación desde el repositorio con el build pack de Dockerfile, puerto 3011, un volumen persistente en /app/data (sin él pierdes la base de datos en cada despliegue), y estas variables:
NODE_ENV=production
AUTH_MODE=full
JWT_SECRET=…                 # openssl rand -base64 48
JWT_REFRESH_SECRET=…         # otro distinto
MFA_ENCRYPTION_KEY=…         # otro más, y no lo pierdas
CORS_ORIGINS=https://app.tudominio.com
[email protected]
ADMIN_PASSWORD=…             # solo se usa si la BD está vacía
TRUST_PROXY=true
TRUST_PROXY_HOPS=1           # Traefik; 2 si hay Cloudflare delante de Traefik
MAIL_TRANSPORT=smtp
SMTP_URL=smtps://usuario:[email protected]:465
APP_URL=https://api.tudominio.com.env.example y de las reglas de env.ts que sí he ejercitado (por ejemplo, que MFA_ENCRYPTION_KEY es obligatoria y CORS_ORIGINS no puede ser *). Y recuerda lo del proxy: TRUST_PROXY=true solo es seguro si no se puede llegar a la app saltándose el proxy y el proxy sobrescribe X-Forwarded-For.Si publicas detrás de Cloudflare, te interesarán Cloudflare Tunnel a fondo (así no abres ningún puerto) y WAF y DDoS a fondo como segunda línea delante de los límites de la propia API.
Lista de comprobación antes de salir a producción
Esta es la lista que yo seguiría con la plantilla, ordenada por «lo que más duele si se olvida». En la última columna te digo cómo lo sé: probado (lo ejecuté), código (lo deduzco leyendo los ficheros) o sin probar.
| # | Qué hacer | Por qué | Cómo lo sé |
|---|---|---|---|
| 1 | Generar tres secretos distintos (JWT_SECRET, JWT_REFRESH_SECRET, MFA_ENCRYPTION_KEY) con openssl rand -base64 48 y guardar la clave de MFA fuera del servidor |
Sin la clave de MFA no se pueden descifrar los secretos TOTP de los usuarios | Probado: el arranque falla sin ellos; el cifrado y la rotación, con el ensayo |
| 2 | Montar un volumen persistente en /app/data |
Sin volumen pierdes la base SQLite en cada despliegue | Probado con volumen de Docker |
| 3 | Programar copias cifradas con ops-rehearsal.sh backup-restore (o tu propio VACUUM INTO + age) y ensayar la restauración |
Una copia que nunca has restaurado no es una copia | Probado (el ensayo pasa entero) |
| 4 | Fijar CORS_ORIGINS a tus dominios (no *) |
En producción la configuración rechaza * |
Probado |
| 5 | Si hay proxy: TRUST_PROXY=true y TRUST_PROXY_HOPS con el número exacto de saltos; que el proxy sobrescriba X-Forwarded-For y que no se pueda llegar a la app saltándose el proxy |
Si no, el rate limit y el bloqueo ven la IP del proxy (o una falsificada) | Probado en local con un proxy de prueba |
| 6 | Poner MAIL_TRANSPORT=smtp y un SMTP_URL real, y APP_URL con tu dominio público |
Con el transporte none la recuperación de contraseña y la verificación no entregan nada (el correo falla definitivamente) |
Probado con el transporte none; SMTP real sin probar |
| 7 | Mantener el overrides de multer (^2.5.0) hasta que Nest lo incluya |
npm audit y Trivy lo marcaban como alto |
Probado: con el override, 0 avisos y 0 en Trivy. Está en el PR #8; en main tienes que añadirlo tú |
| 8 | En main: NO_COLOR=1 en el entorno del contenedor |
Logs sin secuencias ANSI (el PR #8 ya lo hace en producción) | Probado |
| 9 | Añadir un límite global de peticiones en tu proxy o en Cloudflare | El rate limit de la plantilla solo cubre auth, recuperación y MFA; /api/tasks no tiene |
Probado (lectura y ataques) |
| 10 | Decidir si expones /healthz fuera de tu red |
Es público y devuelve uptime y latencia de la base de datos: útil para el orquestador, pero informa a cualquiera | Probado |
| 11 | Comprobar que la versión de Node de la imagen, la de la CI y engines coinciden |
En main no coincidían (imagen en 25, CI en 24); el PR #8 las alinea en 24 |
Probado (versiones) |
| 12 | Cambiar la contraseña del administrador inicial y quitar ADMIN_PASSWORD del entorno tras el primer arranque |
Solo se usa si la base está vacía | Código (y el arranque con volumen vacío lo creó) |
| 13 | Revisar qué haces con /api/auth/login aceptando también application/x-www-form-urlencoded |
Ver la fila 12 de «Lo que queda por pulir» | Probado |
| 14 | Si vas a tener varias instancias, probar el rate limit en base de datos y el outbox con tu base remota (Turso) antes de fiarte | Pensado para ello, no medido | Sin probar |
| 15 | Antes de desplegar una imagen nueva, ejecutar scripts/docker-smoke.sh <imagen> |
Arranca con el sistema de ficheros de solo lectura, migra, comprueba el login del administrador, el HEALTHCHECK y el usuario sin privilegios |
Probado (solo está en el PR #8) |
Hay una más que no cabe en una tabla: lee AGENTS.md (unas 500 líneas). Es la mejor documentación del repositorio, mejor que el README, y recoge el porqué de cada decisión de seguridad.
Rendimiento y consumo
Medí las dos plantillas el 25 de octubre en la misma máquina, compiladas (dist/), con LOG_LEVEL=error, bases SQLite nuevas y autocannon (20 conexiones, 8 s), tres rondas alternadas cada una, sobre las ramas de los dos PR (Nest 623e447, Hono fc44204) y con Node 24.21.0. Es una referencia orientativa: la máquina es compartida y esto no es un banco de pruebas serio. La primera ronda de NestJS salió más lenta en el login (55 ms de mediana en caliente, frente a 28 y 33 en las otras dos) y no sé por qué, así que doy las tres.
| NestJS (3 rondas) | Hono (3 rondas) | |
|---|---|---|
Arranque hasta /healthz 200 |
909 / 883 / 882 ms | 626 / 642 / 677 ms |
| Memoria en reposo (RSS) | 186 / 188 / 188 MiB | 154 / 153 / 154 MiB |
| Memoria tras la carga | 442 / 439 / 437 MiB | 374 / 384 / 392 MiB |
| Primer login (en frío) | 203 / 148 / 173 ms | 310 / 300 / 334 ms |
| Login (mediana, en caliente) | 55 / 28 / 33 ms | 288 / 283 / 305 ms |
GET /healthz |
5.444 / 6.011 / 6.060 req/s | 3.859 / 4.174 / 3.994 req/s |
GET /api/tasks autenticado |
930 / 904 / 876 req/s (≈21–22 ms) | 756 / 742 / 772 req/s (≈25–26 ms) |
SIGTERM → salida |
42 / 43 / 34 ms | 45 / 28 / 53 ms |
(En 758a0ac y 644a5d2, el 24 de octubre y con dos rondas, salió algo parecido: arranque 826 / 700 ms frente a 657 / 670 ms, RSS en reposo 186 / 189 frente a 153 / 150 MiB y /api/tasks a 904 / 878 frente a 758 / 712 req/s.)
La lectura honesta: no hay diferencias que cambien una decisión. NestJS consume unos 34 MiB más en reposo y arranca unos 240 ms más tarde; en rendimiento bruto de rutas va por delante en esta prueba (unas 900 frente a unas 750 req/s en /api/tasks). La diferencia grande en login, de unas 10 veces, es el algoritmo de hash, no el framework (bcryptjs a 12 rondas frente a Argon2id a los mínimos de OWASP), así que no es una comparación de frameworks.
Hono o NestJS: cuándo elegir cuál
Son dos plantillas con el mismo contrato HTTP y distinta filosofía. Estos son los datos reales de cada repositorio el 25 de octubre, en la rama de su PR de correcciones (Hono en fc44204, PR #23; NestJS en 623e447, PR #8). Los dos están ya fusionados en main (el 25 de octubre: Hono a las 12:54, NestJS a las 12:55, hora de Madrid; el árbol de Git de main es idéntico al de cada rama). Antes de la fusión, main estaba en 644a5d2 (Hono, 7 de octubre) y 758a0ac (NestJS, 23 de octubre):
| Hono + Prisma 7 | NestJS 12 + Prisma 7 | |
|---|---|---|
Código de src/ (sin generado) |
5.303 líneas | 6.622 líneas |
| Pruebas | 148 en 18 ficheros (Vitest) | 84 en 13 suites (Jest) + contrato (95/76/32) + Bruno |
| Hash de contraseñas | bcryptjs, 12 rondas (~300 ms por login) | Argon2id (m=19 MiB, t=2), login de ~20–30 ms; bcrypt solo para migrar |
| Logs | JSON con pino | Texto de ConsoleLogger (no JSON; sin colores ANSI en producción desde el PR #8) |
| Rutas + validación + docs | Una sola declaración (@hono/zod-openapi) |
Controlador + Zod + decoradores de Swagger |
| Cliente tipado para el front | hc<AppType>, sin generar código |
No |
| 2FA, recuperación, modos de auth, rate limit en BD | Sí | Sí |
Cola de correo persistente (EmailOutbox) |
No | Sí |
| Rotación de la clave de cifrado de MFA | No | Sí (MFA_ENCRYPTION_KEY_PREVIOUS) |
| Docker | node:24-alpine fijada por digest, sin npm ni corepack en la imagen, read_only y cap_drop en el compose (imagen de 547 MB; la construí y la ejecuté con --read-only; Trivy 0) |
node:24-alpine fijada por digest, sin npm ni corepack en la imagen, read_only, cap_drop, Trivy y SBOM en la CI (imagen de 570 MB; la construí y la ejecuté; Trivy 0) |
| Arranque / RSS en reposo | ~640 ms / ~154 MiB | ~880 ms / ~188 MiB |
npm audit hoy |
0 avisos (en main: 9, 3 altos) |
0 avisos (en main: 4 altos, todos de multer) |
| Dónde corre | Node, y Hono en sí corre en Workers, Bun, Deno… | Solo Node |
(Un aviso: en el artículo de Hono conté 60 pruebas y Node 20/22; el repositorio ha seguido creciendo desde entonces: main tiene 144 pruebas y la rama de su PR #23, 148. Los números de la tabla son los del repositorio, no los del artículo.)
Elige Hono si quieres lo más pequeño y fácil de leer, un cliente tipado de extremo a extremo para tu frontend, logs JSON de serie, o si te interesa poder mover el código a otros entornos de ejecución (Workers, Bun…). Te lo conté con detalle en Hono a fondo.
Elige NestJS si tu equipo ya trabaja con Nest o va a crecer (módulos, inyección de dependencias, convenciones que todo el mundo reconoce), si prefieres que cada responsabilidad (guard, pipe, interceptor, filtro) tenga un sitio, o si valoras lo operativo que trae esta plantilla (cola de correo, rotación de claves, ensayos de copia de seguridad, contenedor endurecido). El precio es más código, más «ceremonia» y un arranque algo más pesado.
Y si dudas entre más opciones, Express a fondo, Fastify a fondo y la comparativa de los cuatro te dan el contexto de por qué existen las dos plantillas.
Problemas reales y cómo los resolví
Esta es la sección que más me habría gustado encontrar antes de empezar. Son los tropiezos que tuve de verdad al trabajar con la plantilla, con el síntoma exacto (para que lo encuentres si te pasa) y la solución que funcionó.
| # | Síntoma | Causa | Solución |
|---|---|---|---|
| 1 | npx jest falla con Must use import to load ES Module: …/node_modules/@nestjs/testing/index.js |
La suite usa módulos ES y necesita las opciones de Node que lleva el script de npm test |
Usa npm test (ejecuta node --experimental-vm-modules … jest.js), no npx jest |
| 2 | En main, con una base de datos usada, 21 de las 62 pruebas fallan |
test/setup-env.ts hace process.env.DATABASE_URL ??= …: si lo tienes exportado, la suite usa tu base en lugar de la temporal |
unset DATABASE_URL antes de npm test (y exporta DATABASE_URL solo para los comandos de Prisma). Corregido en el PR #8: setup-env.ts fuerza la base temporal |
| 3 | migrate deploy falla con P3005 («the database schema is not empty») |
La base ya tenía las tablas pero sin historial de migraciones (por ejemplo, creada con db push) |
No hagas resolve a ciegas. El propio docker-entrypoint.sh te da el procedimiento: copia de seguridad, migrate diff para comprobar que el esquema es el esperado y solo entonces migrate resolve --applied 0_init |
| 4 | En mis pruebas nuevas, 429 al registrar el 6º usuario | El registro tiene un límite de 5 por hora y por IP, y la suite registra más desde la misma IP | Subir REGISTER_RATE_LIMIT_MAX y LOGIN_RATE_LIMIT_MAX con process.env antes de que se llame a loadEnv() en el setup-env.ts de tu copia |
| 5 | GET /api/notes/a/b/c sin token → 404 en lugar de 401 |
Un recurso nuevo no está en la lista de prefijos de AuthPrefixMiddleware |
Añadir el prefijo (api/notes y api/notes/{*splat}) y una prueba; en 758a0ac era el mutante M8, que sobrevivía; el PR #8 añade la prueba de los cuatro prefijos de siempre, pero la de tu recurso nuevo la escribes tú |
| 6 | Mi prueba de «arranque sin secretos» arrancaba igual | dotenv cargó el .env del repositorio |
Lanzarla desde otro directorio o con --env-file /dev/null |
| 7 | El contenedor arranca, migra y luego se niega a arrancar por falta de MFA_ENCRYPTION_KEY |
El script de entrada migra antes de validar el entorno | Define las tres claves antes del primer despliegue; corregido en el PR #8: ahora valida antes de migrar |
| 8 | En main, los logs del contenedor llenos de ^[[32m… |
ConsoleLogger pintaba con ANSI si no había NO_COLOR |
NO_COLOR=1 en el entorno (probado: 0 líneas con ESC); el PR #8 ya lo evita en producción |
| 9 | El contenedor aparece como health: starting durante casi medio minuto aunque la API ya responde |
El HEALTHCHECK solo ejecuta su primera comprobación tras --interval=30s |
No es un fallo: espera o ejecuta curl localhost:3011/healthz a mano |
| 10 | npm audit fix --force propone bajar @nestjs/platform-express a 11.1.1 |
npm resuelve el aviso de multer degradando Nest |
No lo hagas: añade el overrides de multer a 2.5.0 (ya incluido en el PR #8) |
| 11 | El login de administrador con la contraseña de producción falla en desarrollo | ADMIN_EMAIL/ADMIN_PASSWORD solo se aplican en producción; en desarrollo el sembrado crea [email protected] y [email protected] con password123 |
Usa esas cuentas en local (y recuerda que no existen en producción) |
| 12 | POST /api/sessions/login devuelve Missing or malformed Bearer Token |
La ruta de login es /api/auth/login; /api/sessions es un recurso protegido |
Usa la ruta correcta; el mensaje sale del middleware de prefijos, no del login |
Los números 2, 7, 8 y 10 no son errores de uso, sino de cómo estaba empaquetada la plantilla en main; el PR #8 (ya fusionado) los corrige.
Lo que aprendí probándola
- Un guard global solo vigila las rutas que existen. Con un guard
deny-by-defaultcasi todo queda protegido, pero un sondeo sin token a una subruta inexistente bajo/api/tasks,/api/users… respondería 404 en lugar de 401, y eso filtra la forma de tu API. ElAuthPrefixMiddlewarelo evita (lo comprobé:GET /api/tasks/x/y/zsin token → 401; una ruta fuera de esos prefijos,/api/noexiste, → 404) y es un buen recordatorio de probar el caso feo, no solo el camino feliz (y de que ese caso tenga su prueba: el PR #8 añade la que faltaba). - Compartir la instancia importa.
useExistingen lugar deuseClasspara el guard global permite que el middleware y el guard usen exactamente el mismo objeto y el token se verifique una vez. - Las operaciones atómicas ganan a leer y luego escribir. La rotación de refresh tokens con
updateManycondicionado es lo que hace que «de tres refresh a la vez, gana uno» sea cierto, y tiene su propia suite para demostrarlo. - Comprobar el bloqueo antes de la contraseña (y compararla contra un hash falso cuando la cuenta no existe) evita que el login revele cuentas.
- Que algo sea rápido no lo hace más seguro, y que algo sea lento tampoco: la diferencia de unas 10 veces en el login con Hono es el algoritmo, no el framework.
- La protección contra repetición tiene sus costes de UX: el TOTP que usas para activar el 2FA no vale para el siguiente login en el mismo intervalo de 30 s.
- Mis propios errores de prueba me enseñaron cosas. Mis tests fallaban solo porque tenía una variable de entorno exportada, y mi prueba de «arranque sin secretos» arrancó igualmente porque
dotenvcargó el.envdel repositorio (hay que lanzarla desde otro directorio). Las dos cosas ya están anotadas para que no te pasen (y la primera, corregida en el PR #8). - Un harness de contrato entre dos implementaciones es una gran idea: es lo que permite mantener dos plantillas con el mismo comportamiento sin que se separen en silencio.
Lo que queda por pulir
Quiero ser tan honesto aquí como en el artículo de Hono. En la primera pasada (24 de octubre, 758a0ac) no encontré ningún fallo crítico en mis pruebas de seguridad, pero sí catorce cosas que arreglaría. El 25 de octubre corregí en el PR #8 las que se podían arreglar sin tocar la lógica de autenticación; el PR ya está fusionado, y la columna «Estado» distingue lo que está corregido en el PR #8 (y por tanto ya en main; era lo que estaba roto en 758a0ac) de lo que sigue igual. Severidad según mi criterio:
| # | Severidad | Qué (en 758a0ac) |
Estado y qué haría |
|---|---|---|---|
| 1 | Media-baja | npm audit --audit-level=high fallaba (4 avisos altos, todos de multer 2.0.0–2.4.0, GHSA-q7qp-rjg7-q26m) y Trivy marcaba la imagen (1 HIGH: multer 2.4.0, arreglo en 2.5.0). @nestjs/[email protected] fija [email protected] exacto. La plantilla no tiene rutas de subida de ficheros, así que el riesgo práctico era bajo, pero esos dos pasos de la CI podían ponerse en rojo (el último run, el 23 de octubre, fue verde). Ojo: el npm audit fix --force que sugiere npm instalaría @nestjs/[email protected], un descenso que no quieres |
Corregido en el PR #8: "overrides": { "multer": "^2.5.0" }. Medido en la rama: npm audit 0 (también --omit=dev) y Trivy 0; typecheck, build, lint, 84 pruebas y el contrato (95/76/32) en verde. Cuando Nest publique una versión que incluya multer 2.5, se puede quitar el override |
| 2 | Baja | Cinco dependencias declaradas que no se importaban en ningún sitio: @nestjs/config, @nestjs/schedule, nestjs-pino, pino y (en desarrollo) pino-pretty (lo comprobé buscando en todo src/ y test/). Y como consecuencia, los logs de producción no son JSON sino el texto de Nest |
Corregido en el PR #8: las cinco dependencias están fuera y el lockfile pasa de 846 a 812 paquetes (recuento del 25 de octubre sobre los dos package-lock.json). Sigue igual: los logs son texto. Para JSON, Nest trae new ConsoleLogger({ json: true, colors: false }) (lo probé aislado), pero no lo he integrado en main.ts |
| 3 | Baja | Versiones de Node que no coincidían: la imagen usaba node:25-alpine (una línea no LTS, tras un bump de Dependabot), engines pide >=24.9, la CI prueba con Node 24 y AGENTS.md decía node:24-alpine. Es decir, las pruebas no corrían en la versión que se despliega |
Corregido en el PR #8: la imagen es node:24-alpine fijada por digest (Node 24.22.1 al construirla), coherente con engines, la CI y AGENTS.md. Cuando salga la siguiente LTS habrá que cambiar el digest; Dependabot propone el bump |
| 4 | Baja | La documentación y los comentarios arrastraban el origen «port»: muchos comentarios decían «port of the reference…», la semilla incluye una tarea «Learn Hono Framework», el README era muy breve (91 líneas, en inglés) y mandaba a AGENTS.md para casi todo, mientras .env.example está en español |
Corregido en parte en el PR #8: «the reference» pasa a «the Hono starter» (solo comentarios; lo verifiqué con el diff), AGENTS.md y el README se actualizan (100 líneas, con una sección de Docker). Sigue igual: la semilla de desarrollo aún crea «Learn Hono Framework», el README sigue siendo breve y en inglés, y .env.example en español |
| 5 | Baja | prettier --check . marcaba 26 ficheros y la CI solo ejecuta ESLint |
Corregido en parte: el PR formatea los 26 ficheros (en un commit aparte, solo formato) y añade vendor/ a .prettierignore; ahora solo falla .github/workflows/ci.yml. Sigue igual: la CI no ejecuta prettier --check (no he podido tocar workflows: el token con el que subí el PR no tiene permiso workflow) |
| 6 | Baja | Los tests respetaban un DATABASE_URL exportado (??= en setup-env.ts) y escribían en esa base; con una base usada, 21 de 62 fallaron. Tampoco ignoraban TURSO_DATABASE_URL ni SMTP_URL |
Corregido en el PR #8: setup-env.ts fuerza una base SQLite temporal y limpia las variables de Turso y SMTP; test-isolation.spec.ts lo fija. Comprobado exportando las tres: 84 pruebas en verde |
| 7 | Cosmética | GET / anunciaba documentationUrl: "/docs" en producción aunque /docs da 404; el log dice Application is running on: http://127.0.0.1:3011 aunque escucha en 0.0.0.0; un comentario «Constant-time bcrypt comparison» cuando ya es Argon2id; los comentarios de bruno-smoke.sh se contradicen sobre las devDependencies; el comentario de la bandeja de salida decía «≈15 minutos» y el código se rinde a los 450 s (7,5 min) |
Corregido en parte en el PR #8: GET / solo anuncia /docs si están activas (ENABLE_DOCS=true en producción), el comentario de bcrypt se actualiza y el del outbox dice ahora 7,5 minutos (la tabla de esperas pasa a cuatro valores; el comportamiento no cambia). Siguen igual: la línea de log con 127.0.0.1 (la vi también en la imagen del PR) y los comentarios de bruno-smoke.sh |
| 8 | Diseño (no es un fallo) | El bloqueo por cuenta permite que cualquiera deje fuera a un usuario 15 minutos (denegación de servicio dirigida). El registro revela si un email ya existe (409: enumeración de usuarios). El rate limit solo cubre las rutas decoradas (auth, recuperación, MFA), no /api/tasks. La ventana de 10 s de gracia del refresh permite una repetición con respuesta 409. Las claves de rate limit guardan la IP en claro. /healthz es público y muestra uptime y latencia de BD. Argon2id está en el mínimo de OWASP |
Sin cambios, a propósito: son trade-offs de diseño y cambiarlos toca la lógica de autenticación, así que el PR #8 no los toca y los dejo a tu criterio. Lo que haría: aceptar el bloqueo por cuenta si tu amenaza es la fuerza bruta (y no un atacante que conozca emails), o bloquear por pareja cuenta+IP; responder igual al registrar (y confirmar por email) si te importa la enumeración; revisar el rate limit ruta a ruta y poner un límite global en tu proxy; subir los parámetros de Argon2 si tu amenaza lo pide |
| 9 | Test | 62 pruebas y 66 % de cobertura (la de Hono tiene 144); nestjs-zod está vendorizada y no se actualizará sola; la colección de Bruno no cubre MFA ni recuperación (sí el contrato) |
Mejorado en el PR #8: 84 pruebas (22 nuevas: prefijos, logs, GET / y aislamiento) y 67,2 % de cobertura; Hono tiene 148. Sigue igual: nestjs-zod vendorizada y la colección de Bruno. Añade pruebas propias al extender |
| 10 | Baja | Docker: las migraciones se aplicaban antes de validar el entorno, los logs salían con colores ANSI salvo NO_COLOR=1, y la imagen pesaba 719 MB (493 MB solo de npm ci --omit=dev) |
Corregido en el PR #8: el entrypoint valida primero (con un volumen vacío y sin secretos, el volumen se queda vacío), los logs de producción salen sin colores y la imagen baja a 570 MB (396 MB de npm ci, sin typescript, npm, corepack ni yarn). Sigue igual: el node_modules de producción ocupa unos 424 MiB por la CLI de Prisma |
| 11 | Media-baja (pruebas) | Dos huecos que descubrió mi experimento de mutaciones: (a) AuthPrefixMiddleware no tenía ninguna prueba (M8); (b) la suite de concurrencia no distingue el código atómico del que no lo es en SQLite (M1, M1b y M4 sobreviven a las dos suites) |
(a) Corregido en el PR #8: test/auth-prefix.middleware.spec.ts (unitaria y a través del router); repetí M8 y ahora fallan 2 pruebas. (b) Sigue igual: haría falta una prueba contra una base con varios escritores (Turso) o que inyecte una pausa en la transacción |
| 12 | Baja | El login acepta application/x-www-form-urlencoded además de JSON (200 con curl -d). La API no usa cookies, así que no hay CSRF clásico, pero amplía la superficie y permite enviar un login desde un formulario de otro dominio sin preflight de CORS |
Sigue igual (el PR no lo toca). Restringir el login a application/json |
| 13 | Cosmética | El ZodSerializerInterceptor estaba registrado globalmente pero ninguna ruta declaraba un esquema de respuesta, así que no validaba nada de lo que sale |
Corregido en el PR #8: se quita del AppModule (y del diagrama de este artículo). Si quieres validar la salida, añade un DTO de respuesta por ruta y vuelve a registrarlo |
| 14 | Diseño | El bloqueo de cuenta bajo una ráfaga realmente simultánea deja pasar más de 5 intentos: comprueba al principio y registra el fallo al final. Medido: con el límite por IP desactivado, las 30 peticiones pasaron la comprobación; con la configuración por defecto, el límite por IP corta en 10 | Sin cambios, a propósito (diseño). Aceptable porque el limitador por IP lo cubre; si quieres cerrarlo, haz la comprobación y el contador en una sola sentencia |
Otras cosas que quedan fuera del PR y que conviene tener presentes: los cambios de CI (formato, npm audit también de desarrollo) los he dejado sin hacer por el permiso del token; npm 11 solo avisa de los scripts de instalación de las dependencias (@prisma/engines) y una versión futura de npm podría exigir declararlos; y @scarf/scarf, una dependencia transitiva del paquete de Scalar, tiene un script de instalación que envía estadísticas de uso: no se ejecuta en la imagen (--ignore-scripts), pero sí en un npm install de desarrollo.
Sin probar (lo repito para que no haya malentendidos): la generación real del SBOM y la propia ejecución de la CI de GitHub (tampoco con los cambios del PR #8); el envío real de correo por SMTP; Turso; el despliegue en Coolify; y varias instancias a la vez contra la misma base (el rate limit en BD está pensado para eso, pero no lo he medido).
Conclusión
Después de instalarla, compilarla, construirla en Docker, pasarle sus pruebas (62 en main, 84 en la rama del PR #8), 95 escenarios de contrato, 29 peticiones de Bruno, dos baterías de ataques, un experimento de mutaciones y los ensayos de operación (rotación de la clave de MFA y copia de seguridad cifrada), y de añadirle un recurso nuevo con su prueba (69 con las mías, sobre 758a0ac), mi opinión es clara: es una plantilla seria. Las decisiones difíciles (sesiones con estado, rotación con detección de robo, bloqueo antes de la contraseña, fail closed en configuración, IP real detrás de un proxy, copias cifradas) están bien tomadas y demostradas con pruebas, no solo escritas en un README. Y donde no lo están, la propia suite y los ensayos me han dicho dónde mirar.
Lo que más me gusta: el modo AUTH_MODE que desmonta de verdad lo que no usas, la rotación de refresh con su suite de concurrencia, el contenedor endurecido que arranca y se para limpio (sale con código 0 al recibir SIGTERM), y que la propia plantilla te enseñe cómo se rompe (mensajes claros al arrancar, ensayos operativos). Lo que más le faltaba lo he corregido en el PR #8, a la espera de que se fusione: la auditoría de multer (de 4 avisos altos a 0, y Trivy a 0), las dependencias sobrantes, la versión de Node (imagen, CI y engines alineadas en 24), el orden «validar y después migrar», los colores en los logs, el aislamiento de las pruebas y la prueba del middleware que el experimento de mutaciones echó en falta. Lo que queda son sobre todo decisiones de diseño que he preferido dejarte a ti (el bloqueo de cuenta como palanca de denegación de servicio, la enumeración de usuarios en el registro y la cobertura del rate limit), los logs JSON, una prueba de concurrencia que distinga el código atómico en SQLite y los cambios de CI.
Frente a la de Hono, Nest gana en operaciones y seguridad «de fábrica» y pierde en tamaño, en pruebas unitarias y en el cliente tipado. Si no tienes preferencia de framework, empieza por la de Hono por su simplicidad; si tu equipo ya vive en Nest, esta es una base muy buena.
Enlaces
- Repositorio: Collanteslu/nestjs-prisma-production-starter
- Correcciones de este artículo: PR #8 (Nest, fusionado el 25 de octubre) y PR #23 (Hono, fusionado el 25 de octubre)
- La gemela en Hono: Mi plantilla Hono + Prisma 7 y Hono a fondo
- El framework: NestJS 12 a fondo
- El contexto: Express a fondo, Fastify a fondo y la comparativa de los cuatro
- Despliegue: Coolify, tu PaaS autoalojado, Cloudflare Tunnel a fondo y WAF y DDoS a fondo