Cloudflare AI Gateway a fondo: logs, caché y control para tus llamadas a modelos de IA
Qué es AI Gateway y cómo funciona: un proxy entre tu aplicación y los modelos (Workers AI, OpenAI, Anthropic, Google…) con logs, analíticas, caché, rate limiting, DLP y facturación unificada. Precios, límites, las tres formas de conectarse y un Worker con sus tests.
Contenido
En cuanto una aplicación con IA sale de la fase de prototipo aparecen las mismas preguntas: ¿cuánto me está costando?, ¿qué pregunta la gente?, ¿por qué esta respuesta tardó 20 segundos?, ¿cómo evito que un usuario me queme el presupuesto en una tarde?, ¿y si mañana quiero cambiar de proveedor? Responderlas a mano significa escribir logs, contadores y reintentos alrededor de cada llamada.
AI Gateway es un proxy que se pone entre tu aplicación y los modelos y lo hace por ti: guarda logs de cada petición (con tokens y coste), muestra analíticas, cachea respuestas idénticas, aplica límites de velocidad, reintenta y, si quieres, te deja pagar a OpenAI, Anthropic o Google desde tu cuenta de Cloudflare. Funciona con Workers AI y con proveedores externos como OpenAI, Anthropic, Google o xAI.
En este artículo vemos cómo funciona, las tres formas de conectarse, qué cuesta, sus límites y un Worker que pasa todas sus llamadas por un gateway, con sus tests.
getLog y patchLog) y pasa 4 tests con un doble de env.AI. Los curl del final están sacados de la documentación y no los he lanzado. Precios y límites comprobados en la documentación oficial ese mismo día.Cómo funciona
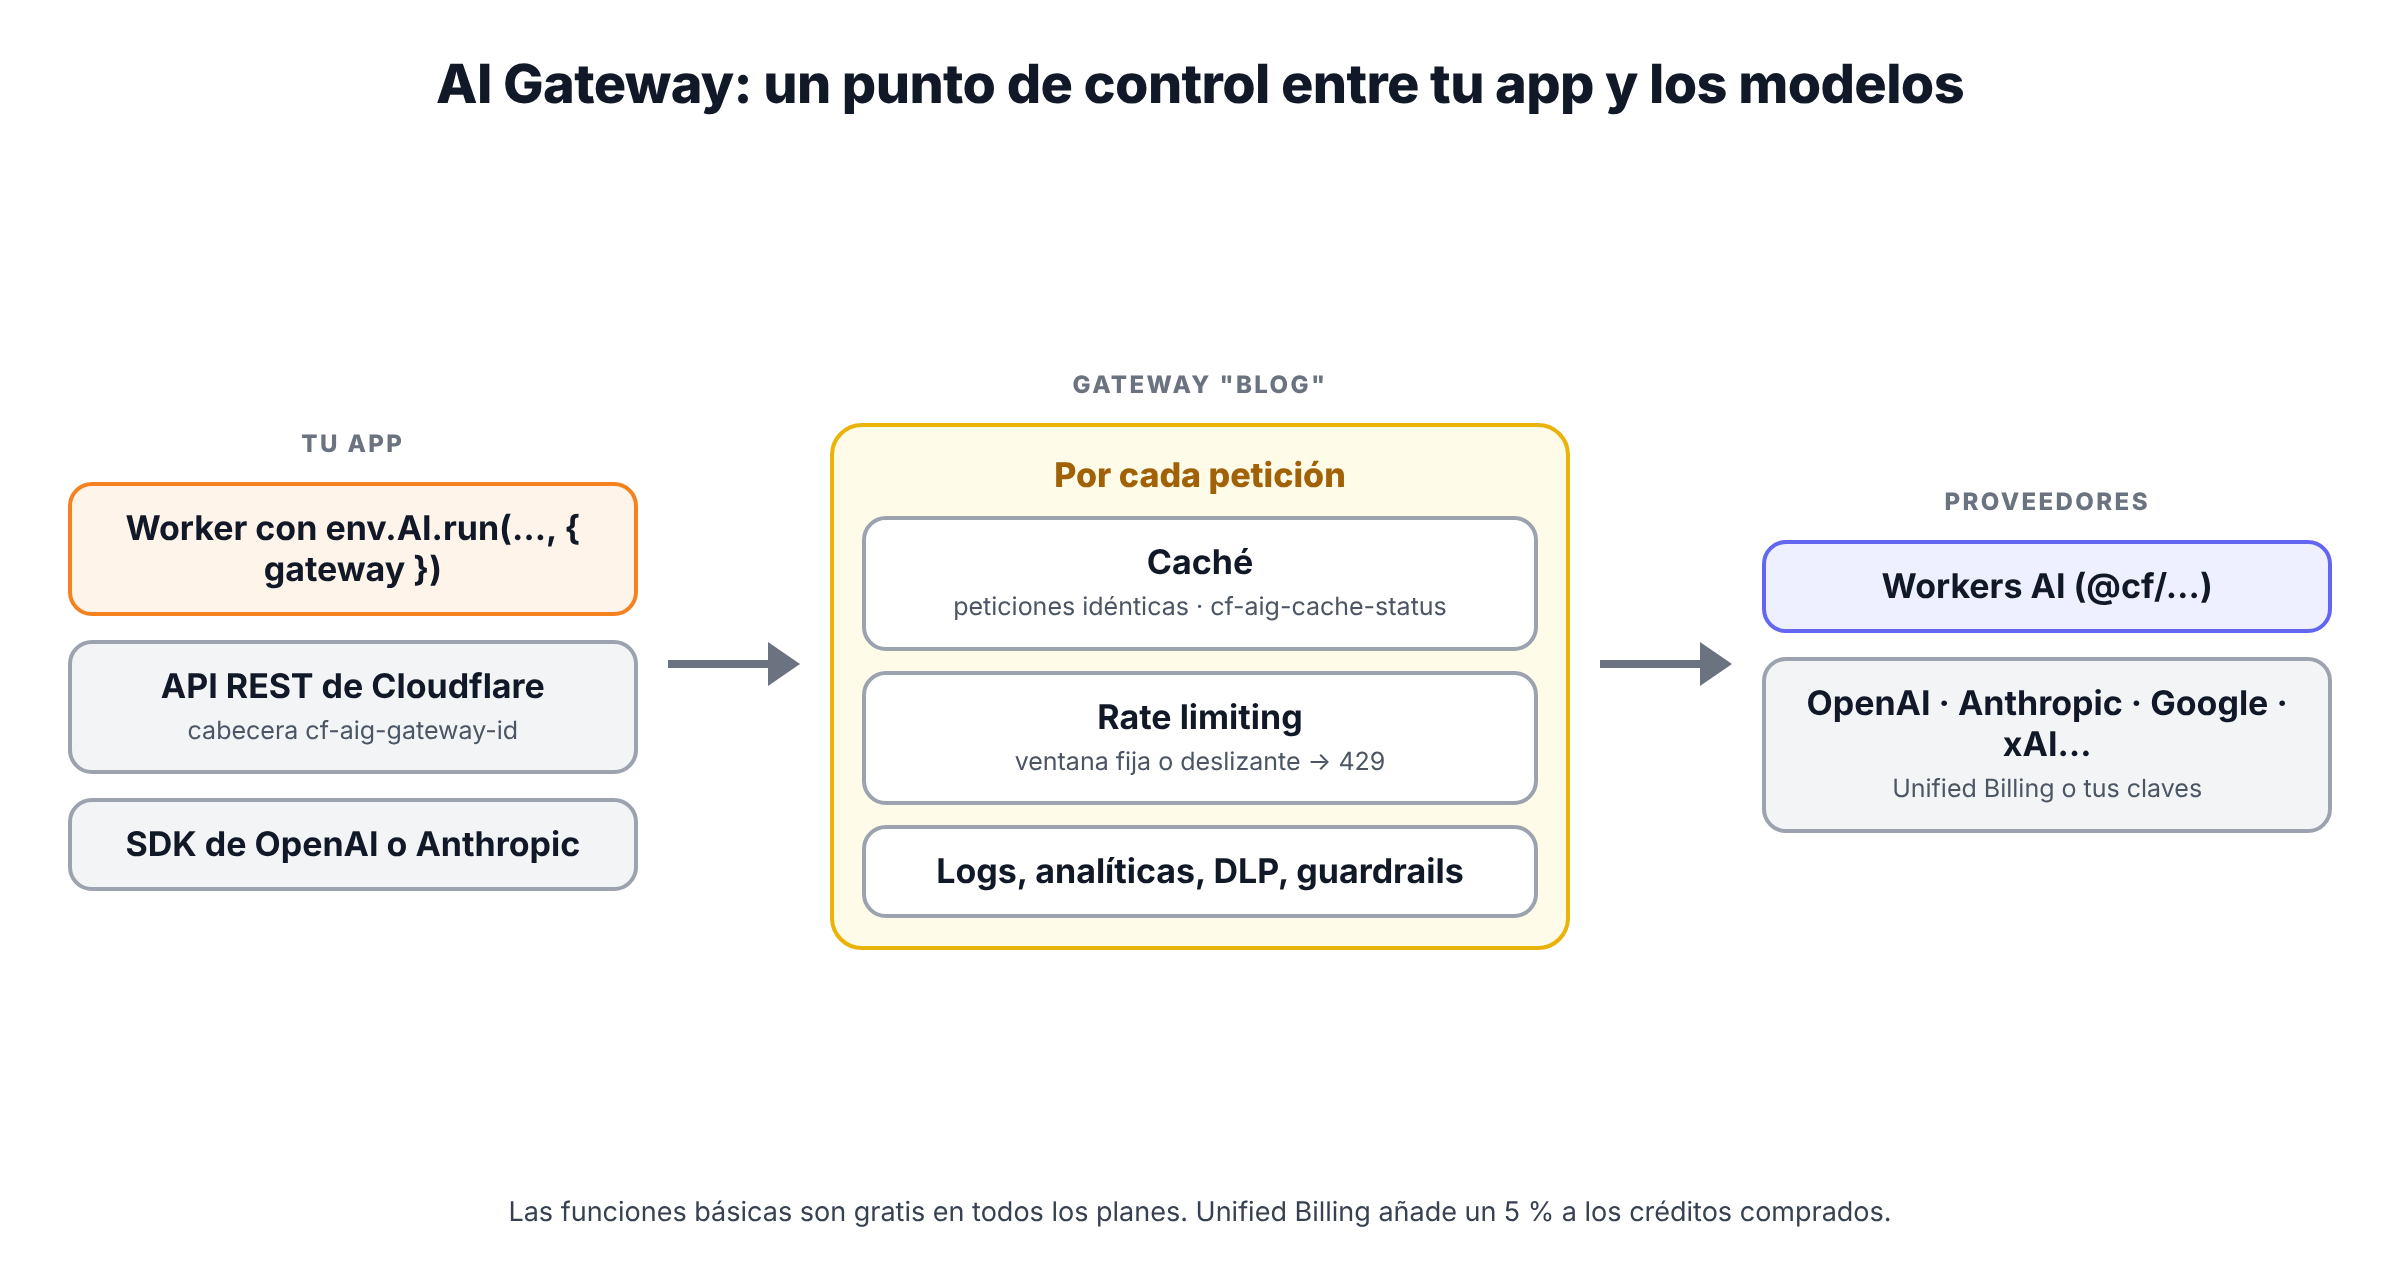
Un gateway es una configuración con nombre dentro de tu cuenta (por ejemplo, blog). Cada petición que pasa por él:
- Se puede servir desde la caché, si está activada y ya se hizo una petición idéntica. La cabecera de respuesta
cf-aig-cache-statusdiceHIToMISS. - Se cuenta para el rate limiting, si lo has configurado (por ejemplo, 100 peticiones cada 60 segundos, con ventana fija o deslizante). Al pasarte,
429 Too Many Requests. - Se reenvía al proveedor, con reintentos y tiempo máximo configurables.
- Se registra: modelo, tokens, coste estimado, duración, la petición y la respuesta. Puedes desactivar el log por petición (
cf-aig-collect-log) o guardar solo los datos sin el contenido (cf-aig-collect-log-payload).
Encima de eso hay funciones opcionales: DLP (detecta datos sensibles, como números de tarjeta, en preguntas y respuestas), guardrails (evalúa el contenido con Llama Guard), rutas dinámicas (reglas para mandar a cada usuario a un modelo, con presupuestos o pruebas A/B) y metadatos propios (hasta 5 por petición) para filtrar los logs por usuario o por función.
Tres formas de conectarse
| Desde | Cómo | Autenticación |
|---|---|---|
| Un Worker | env.AI.run(modelo, entrada, { gateway: { id } }) | El binding; nada más |
| Cualquier sitio, API de Cloudflare | https://api.cloudflare.com/client/v4/accounts/<cuenta>/ai/run o /ai/v1/chat/completions, /ai/v1/responses, /ai/v1/messages | Token de Cloudflare con permiso Workers AI; cabecera cf-aig-gateway-id |
| Cualquier sitio, URL del proveedor | https://gateway.ai.cloudflare.com/v1/<cuenta>/<gateway>/openai (o anthropic, google-ai-studio…) | La clave del proveedor y, si el gateway es autenticado, cf-aig-authorization |
La documentación recomienda la API REST para integraciones nuevas: un solo endpoint para todos los modelos, compatible con los SDK de OpenAI y Anthropic. La tercera vía, cambiar la baseURL del SDK del proveedor por la del gateway, sigue funcionando y es la forma más rápida de poner un gateway delante de una aplicación que ya existe.
Los modelos externos se nombran autor/modelo (openai/gpt-4.1, anthropic/claude-sonnet-4, google/gemini-3-flash) y los de Workers AI, @cf/autor/modelo. Si no indicas gateway, se usa uno llamado default, que se crea solo con la primera petición autenticada.
Precios y límites
Las funciones básicas (analíticas, caché, rate limiting, logs, reintentos) son gratis en todos los planes. Lo que se paga:
- Logs. Si creaste tu primer gateway a partir del 24 de septiembre de 2026, los logs siguen los precios y la retención de Workers Logs. Si es anterior, los Legacy Logs: 100.000 logs en total en Free y 10 millones por gateway en Paid.
- Logpush (enviar los logs a tu almacenamiento): solo en Workers Paid, 10 millones de peticiones al mes incluidas y 0,05 $ por millón adicional.
- Guardrails: se factura como uso de Workers AI (el modelo Llama Guard).
- Unified Billing: el 5 % sobre los créditos.
- DLP: gratis, con dos perfiles predefinidos (información financiera y números de identificación: seguridad social, seguros, documentos nacionales) si no tienes una suscripción Zero Trust que incluya DLP.
| Límite | Valor |
|---|---|
| Gateways por cuenta | 10 (Free) · 20 (Paid) |
| Tamaño de petición cacheable | 25 MB |
| TTL máximo de caché | 1 mes |
| Metadatos propios | 5 por petición |
| Ritmo de escritura de logs | 500 por segundo por gateway |
| Tamaño de un log guardado | 10 MB |
| Peticiones con Unified Billing | 200 por minuto por gateway |
cf-aig-cache-key (o cacheKey en el binding). Y está desactivada por defecto: actívala en el gateway o por petición.El código
Un Worker que manda todas sus llamadas por el gateway blog. Ofrece dos modelos (uno de Workers AI y uno de OpenAI a través de Unified Billing), cachea las respuestas 24 horas salvo que el cliente pida Cache-Control: no-cache, etiqueta cada petición con el usuario y deja valorar la respuesta, que queda guardada en el log:
// Un Worker que pasa todas sus llamadas a modelos por AI Gateway
export interface EntornoGateway {
  AI: Ai;
  GATEWAY_ID: string;
}

const MODELOS = {
  rapido: "@cf/meta/llama-3.2-3b-instruct", // Workers AI: se paga en neuronas
  externo: "openai/gpt-4.1-mini", // proveedor externo: Unified Billing (créditos)
} as const;

export default {
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);

    // GET /preguntar?q=…&modelo=rapido|externo
    if (url.pathname === "/preguntar") {
      const q = url.searchParams.get("q");
      if (!q) return Response.json({ error: "falta ?q=" }, { status: 400 });
      const clave = (url.searchParams.get("modelo") ?? "rapido") as keyof typeof MODELOS;
      const modelo = MODELOS[clave];
      if (!modelo) return Response.json({ error: "modelo desconocido" }, { status: 400 });

      const entrada = { messages: [{ role: "user" as const, content: q }], max_tokens: 200 };
      const opciones = {
        gateway: {
          id: env.GATEWAY_ID,
          cacheTtl: 86_400, // misma petición exacta durante 24 h → desde la caché
          skipCache: request.headers.get("cache-control") === "no-cache",
          metadata: { usuario: request.headers.get("x-usuario") ?? "anonimo", ruta: "preguntar" },
        },
      };
      // una llamada por rama: cada modelo tiene su propia firma en los tipos de run()
      const salida =
        modelo === MODELOS.externo
          ? await env.AI.run(MODELOS.externo, entrada, opciones)
          : await env.AI.run(MODELOS.rapido, entrada, opciones);
      const respuesta = typeof salida === "string" ? salida : "response" in salida ? salida.response : salida;
      // id del log en el gateway: sirve para valorar la respuesta después
      return Response.json({ respuesta, logId: env.AI.aiGatewayLogId });
    }

    // POST /valorar { logId, util: true|false } → feedback en el log del gateway
    if (url.pathname === "/valorar" && request.method === "POST") {
      const { logId, util } = (await request.json()) as { logId?: string; util?: boolean };
      if (!logId) return Response.json({ error: "falta logId" }, { status: 400 });
      await env.AI.gateway(env.GATEWAY_ID).patchLog(logId, { feedback: util ? 1 : -1 });
      return new Response(null, { status: 204 });
    }

    return new Response("GET /preguntar?q=… · POST /valorar\n", { status: 404 });
  },
} satisfies ExportedHandler<EntornoGateway>;gateway.ides el nombre del gateway.cacheTtlva en segundos;skipCache,cacheKey,metadataycollectLogson las mismas opciones que las cabecerascf-aig-*de la API REST.env.AI.aiGatewayLogIdes el id del log de la última llamada. Con él,env.AI.gateway(id).patchLog()añade una valoración (feedback1 o −1), una puntuación o metadatos al log, para revisar luego en el panel qué respuestas no gustaron.- Dos llamadas, una por rama. Los tipos de
run()tienen una firma distinta para cada modelo, y TypeScript no acepta una variable con la unión de dos nombres. Separarlo en dos llamadas es lo más limpio. - Lista cerrada de modelos. Nunca dejes que el cliente elija cualquier nombre de modelo: podría mandarte al más caro del catálogo.
Los tests
Con un doble de env.AI que guarda las opciones de cada llamada y simula aiGatewayLogId y patchLog:
 ✓ test/gateway.test.ts > worker con AI Gateway (con dobles) > manda el gateway, la caché y los metadatos en cada llamada
 ✓ test/gateway.test.ts > worker con AI Gateway (con dobles) > elige el modelo externo y salta la caché con Cache-Control: no-cache
 ✓ test/gateway.test.ts > worker con AI Gateway (con dobles) > rechaza modelos que no están en la lista
 ✓ test/gateway.test.ts > worker con AI Gateway (con dobles) > guarda la valoración en el log con patchLog
      Tests  4 passed (4)
Lo mismo sin Worker
Con la API REST y el formato de OpenAI, según la documentación (sin probar):
curl https://api.cloudflare.com/client/v4/accounts/$CLOUDFLARE_ACCOUNT_ID/ai/v1/chat/completions \
  --header "Authorization: Bearer $CLOUDFLARE_API_TOKEN" \
  --header "Content-Type: application/json" \
  --header "cf-aig-gateway-id: blog" \
  --header "cf-aig-cache-ttl: 86400" \
  --data '{"model": "@cf/meta/llama-3.2-3b-instruct", "messages": [{"role": "user", "content": "¿Qué es un Worker?"}]}'
O con el SDK de OpenAI, cambiando solo la URL base por https://gateway.ai.cloudflare.com/v1/<cuenta>/blog/openai y añadiendo cf-aig-authorization si el gateway es autenticado.
Errores comunes (y cómo evitarlos)
- Activar la caché y esperar milagros. Solo acierta con peticiones idénticas. Mira la proporción de
HITen las analíticas antes de contar con ella. - Cachear respuestas personalizadas. Si la pregunta incluye datos del usuario, una clave de caché mal elegida puede servir la respuesta de uno a otro. Con
cacheKey, incluye siempre lo que hace distinta la respuesta. - Gateways sin autenticar con la URL del proveedor. Cualquiera que conozca tu cuenta y el nombre del gateway puede usarlo con su propia clave y llenarte los logs. Activa el Authenticated Gateway.
- Guardar datos personales en los logs sin pensarlo. Los logs incluyen preguntas y respuestas. Usa
collectLog: false(ocf-aig-collect-log-payload: false) donde haga falta y revisa la retención. - Confundir el rate limiting del gateway con el de tu API. El del gateway es global para todas las peticiones que pasan por él, no por usuario. Para límites por usuario, combínalo con el rate limiting de Workers o con rutas dinámicas.
- Dejar que el cliente elija el modelo. Lista cerrada en el servidor.
Cuándo usar AI Gateway (y cuándo no)
Úsalo en cuanto una aplicación con IA tenga usuarios reales: para saber cuánto gastas y en qué, depurar respuestas, protegerte de picos, cachear lo repetido y poder cambiar de modelo o proveedor sin tocar el código. Si ya usas Workers AI, poner gateway: { id } en cada llamada no cuesta nada.
Puede sobrar en un script personal de pruebas o si ya tienes una plataforma de observabilidad de LLM que cubre todo esto. Y no sustituye a la seguridad de tu aplicación: la autenticación de tus usuarios y los límites por usuario siguen siendo cosa tuya.
Sigue leyendo
- Cloudflare a fondo: la visión general de la plataforma.
- Cloudflare Workers AI a fondo: los modelos de Cloudflare que pasan por el gateway.
- Cloudflare Vectorize a fondo: un RAG cuyas llamadas al modelo van por AI Gateway.
- Cloudflare WAF y protección DDoS a fondo: rate limiting por usuario delante de tu API.
- Cloudflare Zero Trust a fondo: DLP y control del uso de IA en tu organización.