Cloudflare Workers AI a fondo: modelos de IA a una llamada de tu Worker
Qué es Workers AI y cómo funciona: un catálogo de modelos abiertos (texto, embeddings, imagen, voz) en GPUs de Cloudflare, con un binding en tu Worker o por API REST. Cómo se factura en neuronas, límites por tipo de modelo, streaming y un Worker de chat con tests.
Contenido
Usar un modelo de lenguaje desde tu aplicación suele significar elegir entre dos males: pagar una API externa por token y mandarle tus datos, o montar tus propias GPUs. Workers AI es una tercera vía: un catálogo de modelos abiertos (Llama, Qwen, Mistral, gpt-oss, Gemma, Kimi y compañía, además de modelos de embeddings, imagen y voz) que Cloudflare ejecuta en GPUs de su red y que llamas con una línea desde un Worker.
No hay que desplegar nada, ni reservar máquinas, ni pagar por horas: pagas por uso, en una unidad propia llamada neurona, y tienes una cantidad gratis cada día incluso en el plan Free.
En este artículo vemos cómo funciona, cómo se factura (con cuentas reales), los límites, cómo hacer streaming y un Worker de chat con su manejo de errores.
wrangler dev, cada llamada va a tu cuenta de Cloudflare y gasta neuronas, y no he usado una cuenta para estas pruebas. Lo que sí está comprobado, el 3 de octubre de 2026, con Wrangler 4.147.0, TypeScript 7.0.2 y Vitest 5.0.3: el código compila contra los tipos oficiales que genera wrangler types y su lógica pasa tests con un doble de env.AI (un objeto falso que imita la forma de las respuestas). Las respuestas de los modelos que verás son de ese doble, no de un modelo. Precios y límites comprobados en la documentación oficial ese mismo día.Cómo funciona
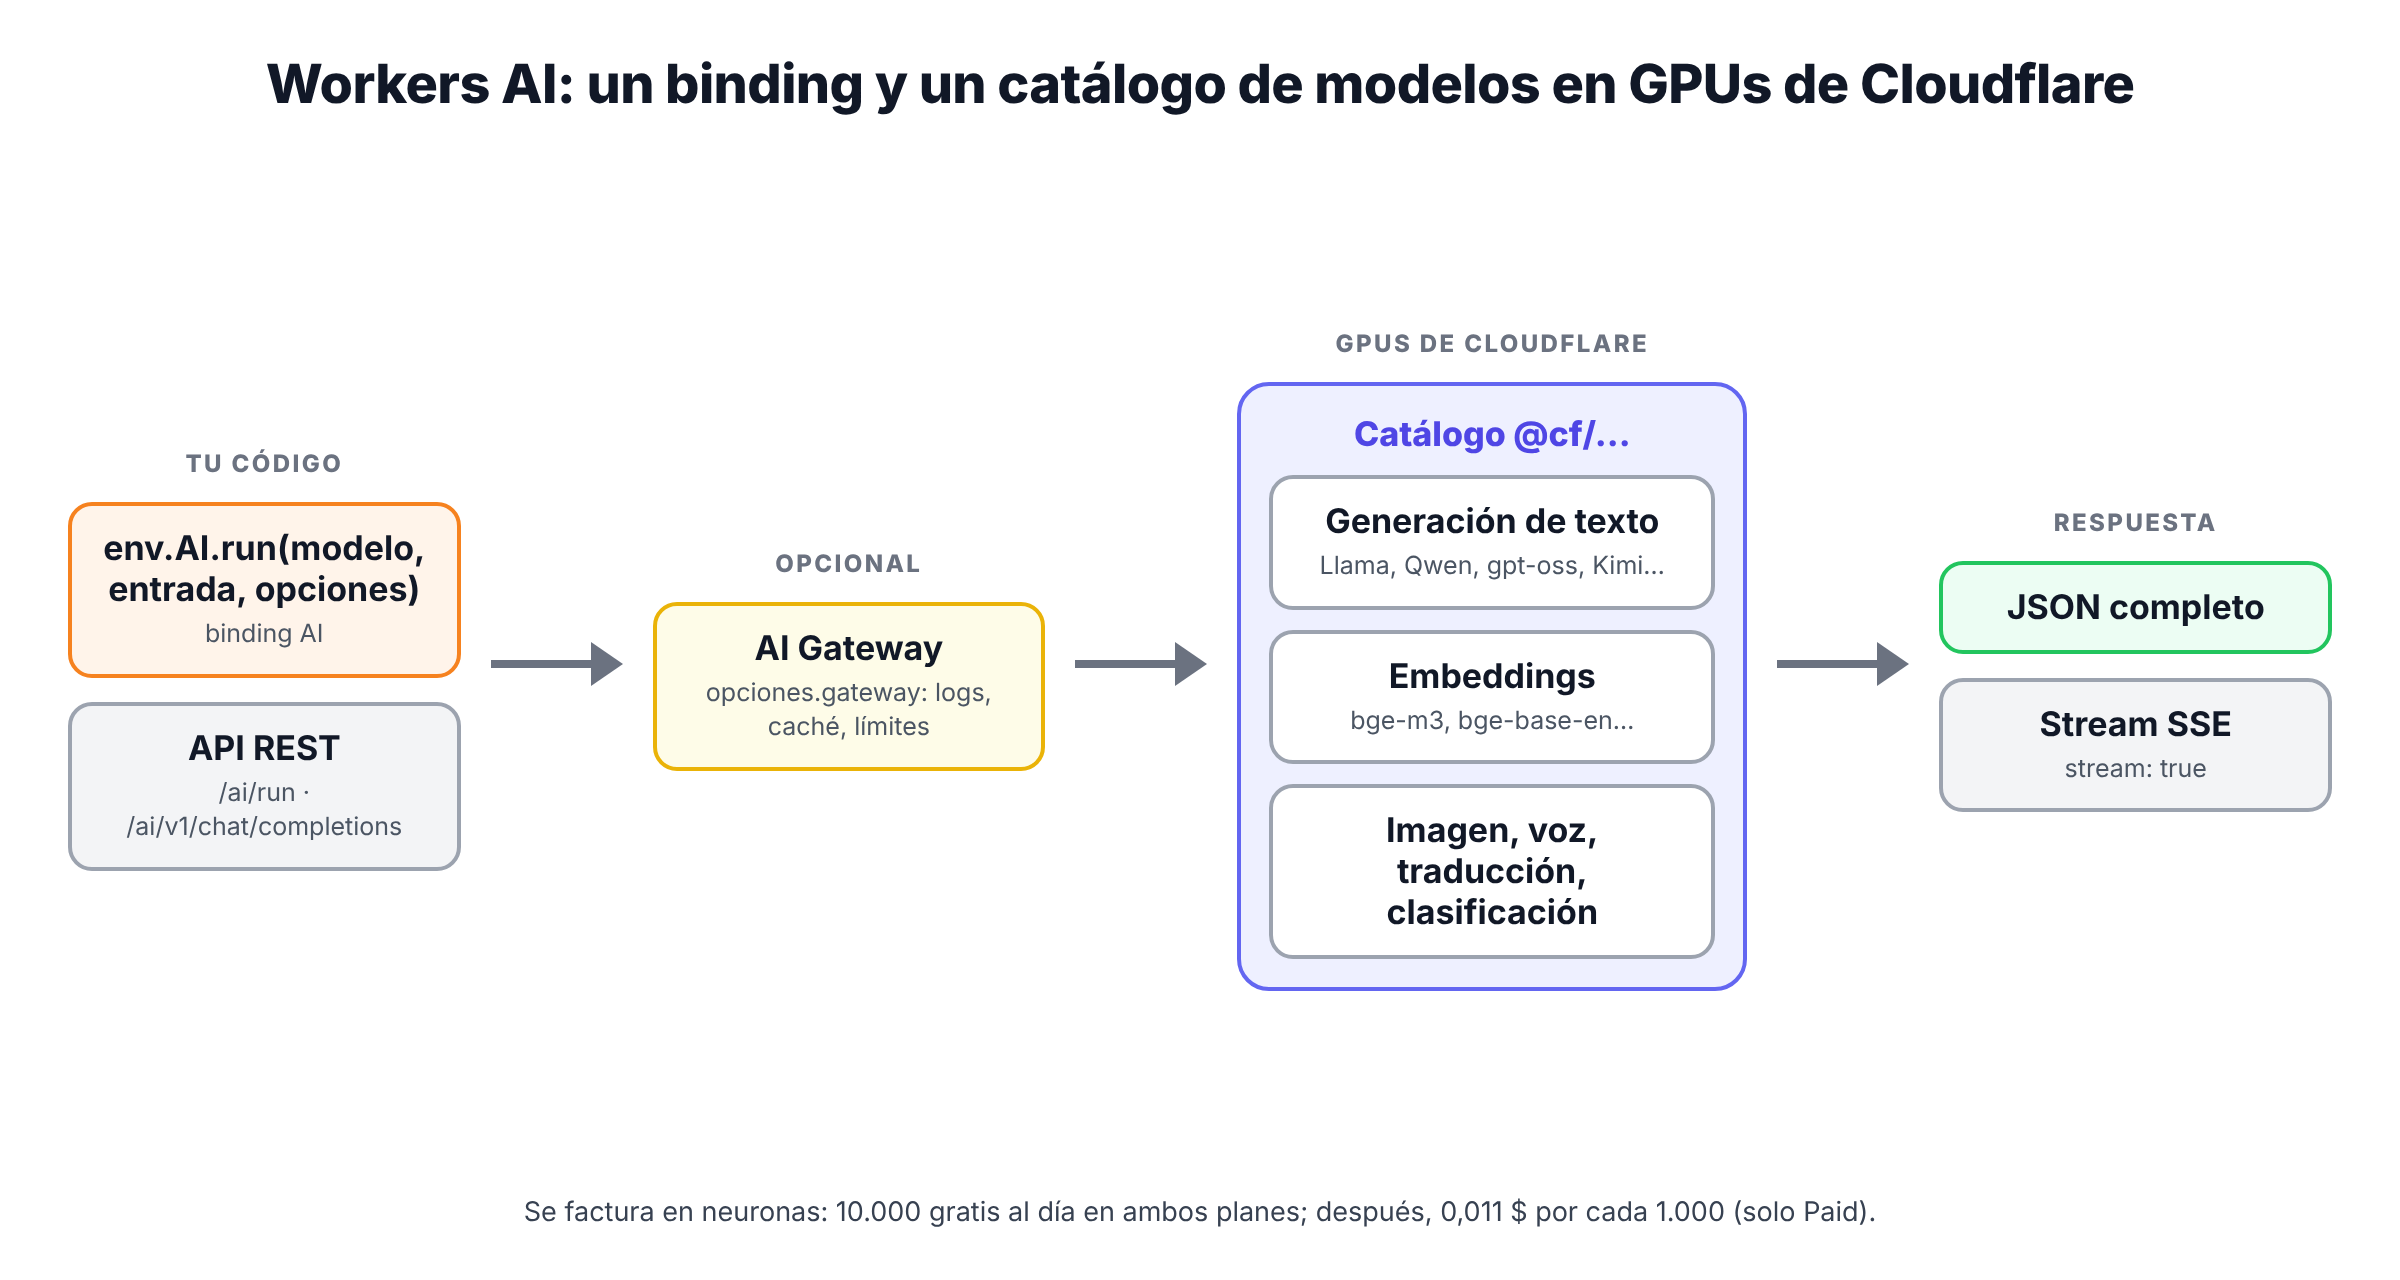
- Añades el binding
aia tu configuración. En el Worker apareceenv.AI. - Llamas a
env.AI.run(modelo, entrada, opciones). El modelo se identifica con un nombre del tipo@cf/<autor>/<modelo>, por ejemplo@cf/meta/llama-3.3-70b-instruct-fp8-fast. La entrada depende del tipo de modelo:messagesopromptpara generar texto,textpara embeddings, una imagen para clasificación… - Cloudflare ejecuta el modelo en una GPU de su red y te devuelve el resultado: un objeto JSON o, con
stream: true, un flujo de eventos SSE que puedes reenviar tal cual al navegador.
También se puede llamar sin Worker, por la API REST de Cloudflare (/accounts/<cuenta>/ai/run/... o el endpoint compatible con OpenAI /ai/v1/chat/completions), con un token de API que tenga permiso de Workers AI.
El catálogo
El catálogo de Workers AI tenía 69 modelos el día que escribí esto, de estos tipos:
| Tipo | Para qué | Ejemplos |
|---|---|---|
| Generación de texto | Chat, resúmenes, extracción, agentes | Llama 3.x, Qwen, gpt-oss, Mistral, Kimi |
| Embeddings | Búsqueda semántica y RAG | bge-m3 (multilingüe), bge-base-en-v1.5, qwen3-embedding-0.6b |
| Texto a imagen | Generar imágenes | FLUX, Stable Diffusion |
| Voz | Transcribir (ASR) y sintetizar (TTS) | Whisper, Deepgram |
| Clasificación, detección, traducción | Moderación, etiquetas, idiomas | Llama Guard, m2m100 |
Algunos modelos de texto admiten llamadas a funciones (function calling), LoRA (adaptadores ajustados por ti) o la API de lotes, que encola muchas peticiones y te devuelve un request_id para recoger los resultados después, sin errores por límite de velocidad. Cada ficha del catálogo indica qué admite el modelo, su ventana de contexto y su precio.
llama-3.1-8b-instruct, -awq, -fp8 y -fp8-fast son variantes cuantizadas u optimizadas del mismo modelo, con precios distintos. Mira la ficha de cada una antes de elegir, porque algunas aparecen en la tabla de precios y su página ya no existe.Precios: neuronas
Workers AI se factura en neuronas, una unidad que mide el cómputo en GPU. Cada modelo tiene un precio en neuronas por millón de tokens (o por imagen, por minuto de audio…), y la documentación muestra también su equivalencia en dólares.
| Plan | Gratis | Después |
|---|---|---|
| Workers Free | 10.000 neuronas al día | Nada: hay que pasar a Paid |
| Workers Paid | 10.000 neuronas al día | 0,011 $ por cada 1.000 neuronas |
El contador se pone a cero cada día a las 00:00 UTC (las 02:00 en la España peninsular en verano). Algunos modelos grandes exigen un método de pago aunque estés dentro de la cuota.
Para hacerse una idea, con los precios de la documentación y una pregunta típica de un RAG (1.500 tokens de entrada, con el contexto, y 300 de salida):
| Modelo | Neuronas por millón (entrada / salida) | Neuronas por pregunta | Preguntas gratis al día |
|---|---|---|---|
@cf/meta/llama-3.2-3b-instruct | 4.625 / 30.475 | ≈ 16 | ≈ 625 |
@cf/meta/llama-3.3-70b-instruct-fp8-fast | 26.668 / 204.805 | ≈ 101 | ≈ 99 |
@cf/baai/bge-m3 (embeddings) | 1.075 | ≈ 1,6 por 1.500 tokens | — |
Pasada la cuota, la pregunta al modelo de 70B sale por unos 0,0011 $ y la del de 3B, por unos 0,00018 $. Indexar un millón de tokens de texto con bge-m3 cuesta 1.075 neuronas, ni 2 céntimos. Los tokens de salida son lo caro: limita max_tokens.
Límites
Los límites de velocidad son por tipo de tarea (y algunos por modelo), por cuenta:
| Tipo | Peticiones por minuto |
|---|---|
| Generación de texto | 300 (los modelos que exigen Paid: 20, o 50 con créditos de AI Gateway) |
| Embeddings | 3.000 (bge-large-en-v1.5: 1.500) |
| Clasificación de texto | 2.000 |
| Resumen | 1.500 |
| Texto a imagen, voz a texto, imagen a texto, traducción | 720 |
| Clasificación de imágenes, detección de objetos | 3.000 |
wrangler dev van a tu cuenta, gastan neuronas y cuentan para los límites. No dejes un bucle de pruebas lanzando peticiones.El código
La configuración solo necesita el binding:
{
  "ai": { "binding": "AI" }
}
Y un Worker de chat que responde de una vez o en streaming. Uso un modelo pequeño, porque para respuestas cortas sobra, y le pongo una etiqueta (tags) para agrupar las peticiones en el panel:
// Worker mínimo de chat con Workers AI: respuesta en streaming (SSE) o de una vez
export interface EntornoChat {
  AI: Ai;
}

const MODELO = "@cf/meta/llama-3.2-3b-instruct"; // pequeño y barato: ~16 neuronas por pregunta típica

export default {
  async fetch(request, env): Promise<Response> {
    if (request.method !== "POST") return new Response("POST { pregunta, stream? }\n", { status: 405 });
    const { pregunta, stream = false } = (await request.json()) as { pregunta?: string; stream?: boolean };
    if (!pregunta) return Response.json({ error: "falta pregunta" }, { status: 400 });

    const messages = [
      { role: "system", content: "Responde en español de España, en tres frases como máximo." },
      { role: "user", content: pregunta },
    ];

    try {
      if (stream) {
        // con stream: true, run() devuelve un ReadableStream de eventos SSE
        const flujo = await env.AI.run(MODELO, { messages, stream: true, max_tokens: 256 }, { tags: ["chat"] });
        return new Response(flujo as ReadableStream, { headers: { "content-type": "text/event-stream" } });
      }
      const salida = await env.AI.run(MODELO, { messages, max_tokens: 256 }, { tags: ["chat"] });
      const texto = typeof salida === "string" ? salida : "response" in salida ? salida.response : null;
      return Response.json({ respuesta: texto, uso: typeof salida === "object" && "usage" in salida ? salida.usage : undefined });
    } catch (e) {
      // límite de neuronas agotado, rate limit, modelo inexistente…: no devuelvas el error crudo
      console.error("Workers AI:", e);
      return Response.json({ error: "el modelo no está disponible ahora" }, { status: 503 });
    }
  },
} satisfies ExportedHandler<EntornoChat>;
Tres detalles que salen de los tipos oficiales, no de la intuición:
- La salida de
run()es una unión. Para este modelo,wrangler typesla declara como objeto conresponse, comostringo como respuesta de lote asíncrono. Si accedes asalida.responsesin comprobarlo, TypeScript no compila. - Con
stream: truerecibes unReadableStreamde eventos SSE. Lo devuelves concontent-type: text/event-streamy el navegador lo lee conEventSourceofetch. - Captura los errores. Si se acaba la cuota diaria, se supera el límite de velocidad o el modelo no existe,
run()lanza una excepción. No devuelvas el mensaje tal cual al cliente.
Los tests
Como no hay simulación local, la lógica se prueba con un doble: un objeto con un método run que devuelve lo que devolvería el modelo. No dice nada de la calidad de las respuestas, pero comprueba que el Worker construye bien la petición, reenvía el stream y no filtra errores:
 ✓ test/chat.test.ts > chat > sin stream devuelve JSON con la respuesta y el uso
 ✓ test/chat.test.ts > chat > con stream reenvía el ReadableStream como text/event-stream
 ✓ test/chat.test.ts > chat > si el modelo falla responde 503 sin filtrar el error
Para probarlo de verdad: npx wrangler login, npx wrangler dev y un curl -X POST localhost:8787 -d '{"pregunta":"¿Qué es un Worker?"}'. Ese paso sí gasta neuronas.
Errores comunes (y cómo evitarlos)
- No limitar
max_tokens. La salida es lo más caro y lo más lento. Ponle un tope. - Elegir el modelo más grande por defecto. Un 3B o un 8B resuelve muchas tareas (clasificar, extraer, resumir textos cortos) por una fracción del precio. Sube solo si la calidad no llega.
- Usar un modelo de embeddings en inglés para textos en español.
bge-base-en-v1.5está pensado para inglés; para español,bge-m3u otro multilingüe. - Probar en local como si fuera gratis. Las llamadas en
wrangler devcuentan. - Suponer la forma de la respuesta. Cada modelo tiene su esquema de entrada y salida, documentado en su ficha. Genera los tipos con
wrangler typesy deja que el compilador te avise. - Lanzar miles de peticiones en paralelo. Para trabajos por lotes (indexar un archivo entero, resumir miles de textos), usa la API de lotes o una cola.
- No tener visibilidad. Sin logs no sabes qué preguntas se hacen ni cuánto cuestan. Pasa las peticiones por AI Gateway.
Cuándo usar Workers AI (y cuándo no)
Úsalo para añadir IA a una aplicación que ya vive en Cloudflare sin gestionar GPUs ni otra cuenta: chat y asistentes, resúmenes, clasificación y moderación, embeddings para búsqueda semántica con Vectorize, transcripción de audio o generación de imágenes. La cuota diaria gratuita da para prototipos y proyectos pequeños.
No es la mejor opción si necesitas el modelo más potente del mercado para una tarea difícil (los modelos cerrados de OpenAI, Anthropic o Google siguen por delante en muchas; puedes llamarlos igualmente a través de AI Gateway), si necesitas un modelo propio entero (no solo un LoRA) o si tienes GPUs propias infrautilizadas.
Sigue leyendo
- Cloudflare a fondo: la visión general de la plataforma.
- Cloudflare Vectorize a fondo: guarda los embeddings y monta un RAG.
- Cloudflare AI Gateway a fondo: logs, caché y límites para tus llamadas a modelos.
- Cloudflare Browser Run a fondo: convierte páginas web a Markdown para dárselas a un modelo.
- Planes de Cloudflare Workers: Free frente a Paid: qué cambia en cada plan.