Cloudflare Vectorize a fondo: base de datos vectorial para búsqueda semántica y RAG
Qué es Vectorize y cómo funciona: índices de vectores con dimensiones y métrica fijas, upsert asíncrono, consultas topK, metadatos, filtros y namespaces. Límites, precios por dimensiones y un RAG completo con Workers AI y tests que encontraron un bug.
Contenido
Un buscador normal encuentra palabras. Si alguien busca «cómo evito pagar por la salida de datos» en un blog que habla de egress, no encuentra nada. La búsqueda semántica busca por significado: convierte cada texto en un vector (una lista de números, el embedding) de forma que textos parecidos dan vectores cercanos, y luego busca los vectores más próximos al de la pregunta.
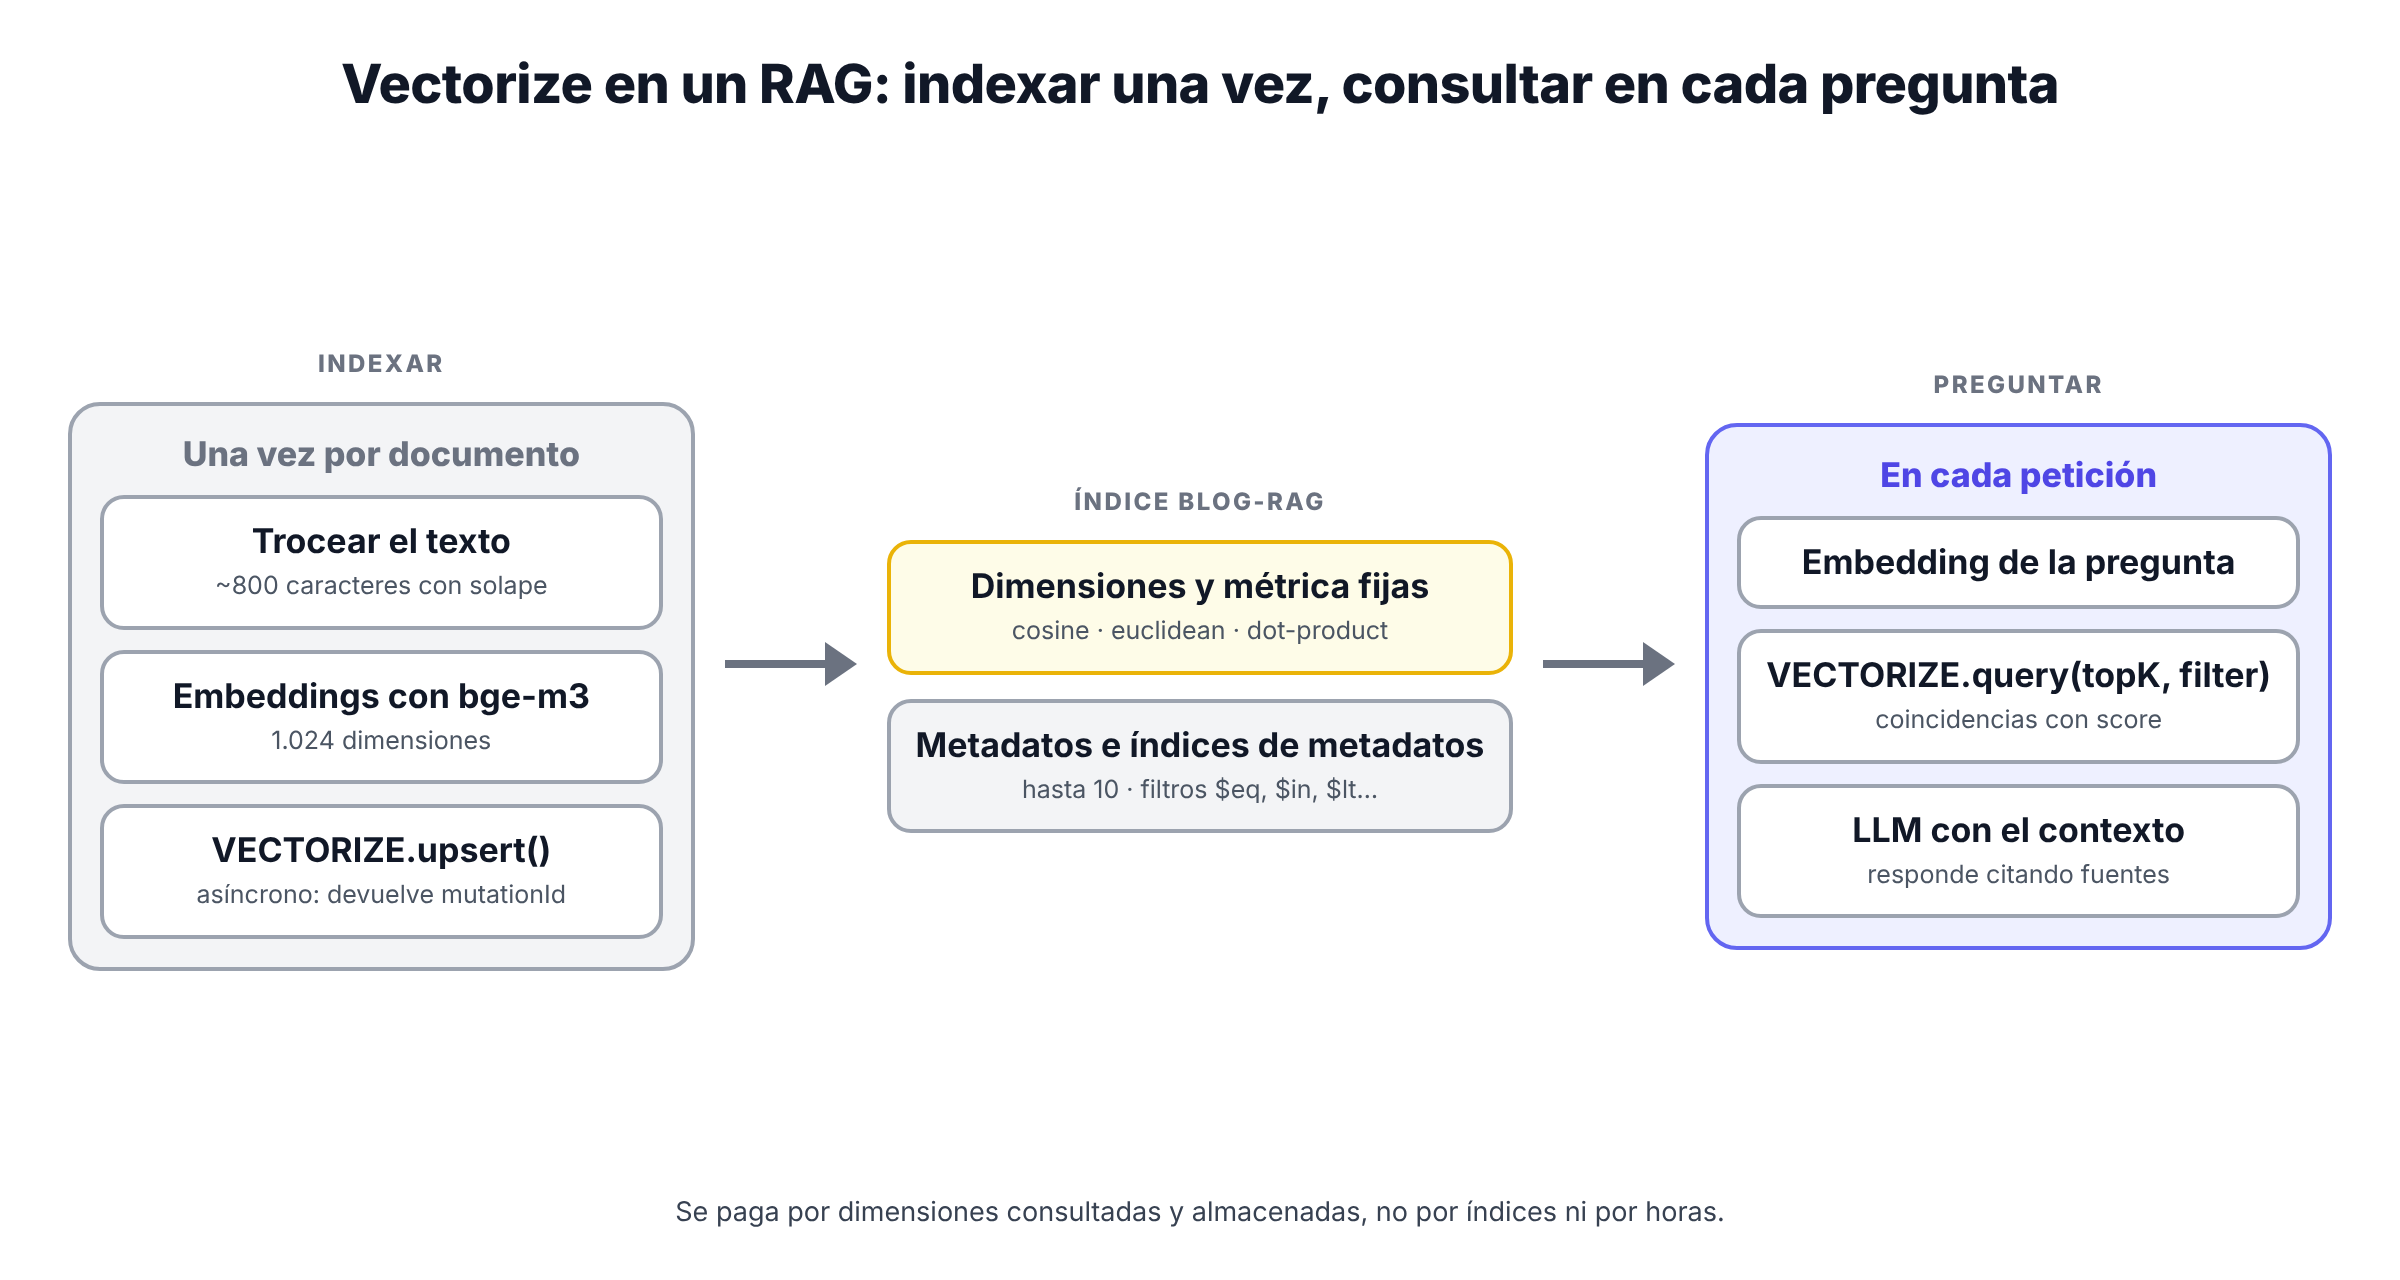
Para eso hace falta una base de datos vectorial, y Vectorize es la de Cloudflare: guardas vectores con sus metadatos y, en cada consulta, te devuelve los más parecidos. Con Workers AI para generar los embeddings y un modelo de lenguaje para redactar la respuesta, tienes un RAG (Retrieval-Augmented Generation): un asistente que responde con tus documentos, no con lo que se inventa.
En este artículo vemos cómo funciona Vectorize, sus límites y precios, y un RAG completo para preguntar a este blog, con sus tests.
wrangler dev, los bindings van a tu cuenta, y no he usado una cuenta para estas pruebas. Lo que sí está comprobado, el 3 de octubre de 2026, con Wrangler 4.147.0, TypeScript 7.0.2 y Vitest 5.0.3: el código compila contra los tipos oficiales y pasa 7 tests con dobles de env.AI y env.VECTORIZE (objetos falsos que imitan sus respuestas, con una similitud coseno de verdad). Los tests encontraron un error real en el troceado, que está corregido. Precios y límites comprobados en la documentación oficial ese mismo día.Cómo funciona
El índice
Un índice se crea con dos parámetros que no se pueden cambiar después:
- Dimensiones: la longitud de los vectores. Tiene que coincidir con la salida del modelo de embeddings: 768 para
bge-base-en-v1.5, 1.024 parabge-m3. Máximo, 1.536. - Métrica: cómo se mide la distancia.
cosine(la habitual con embeddings de texto; cuanto más cerca de 1, más parecido),euclidean(cuanto más cerca de 0, más parecido) odot-product.
npx wrangler vectorize create blog-rag --dimensions=1024 --metric=cosine
npx wrangler vectorize create-metadata-index blog-rag --property-name=tag --type=string
Para algunos modelos hay presets que fijan las dos cosas por ti (--preset @cf/baai/bge-base-en-v1.5), pero solo para bge-small-en, bge-base-en, bge-large-en y dos modelos externos; bge-m3 no está.
bge-m3. Las 1.024 salen de la ficha del modelo original de BAAI. Antes de crear el índice, compruébalo: la respuesta de env.AI.run("@cf/baai/bge-m3", …) incluye un campo shape con [número de textos, dimensiones].Vectores, metadatos y namespaces
Cada vector tiene un id (hasta 64 bytes), sus valores y, opcionalmente, metadatos (hasta 10 KiB: el texto original, el título, la URL…) y un namespace, que separa los vectores en grupos (por cliente, por idioma) y se puede usar para filtrar sin configurar nada.
Para filtrar por otro campo de los metadatos hace falta un índice de metadatos sobre ese campo (como mucho 10 por índice, de tipo string, number o boolean). Los filtros admiten $eq, $ne, $in, $nin, $lt, $lte, $gt y $gte.
upsert de todos. Y de un campo de texto solo se indexan los primeros 64 bytes.Escribir y consultar
insertañade vectores y falla con los ids que ya existen;upsertlos añade o sustituye entero el vector con el mismo id (no mezcla metadatos). Los dos son asíncronos: devuelven unmutationIdy los vectores tardan unos segundos en aparecer en las consultas.query(vector, opciones)devuelve lostopKmás parecidos (5 por defecto) con suscore. ConreturnMetadata: "all"trae también los metadatos, pero entoncestopKmáximo es 50 (100 sin valores ni metadatos).queryById,getByIds,deleteByIdsydescribecompletan la API. Para listar ids,wrangler vectorize list-vectorspagina de 1.000 en 1.000.
Límites y precios
| Límite | Valor |
|---|---|
| Índices por cuenta | 100 (Free) · 50.000 (Paid) |
| Vectores por índice | 20 millones |
| Dimensiones por vector | 1.536 (float32) |
| Metadatos por vector | 10 KiB |
topK máximo | 100 sin valores ni metadatos · 50 con ellos |
Vectores por upsert | 1.000 desde un Worker · 5.000 por la API HTTP |
| Namespaces por índice | 1.000 (Free) · 50.000 (Paid) |
| Índices de metadatos | 10 por índice |
Vectorize cobra por dimensiones, no por índices, ni por horas, ni por CPU:
| Workers Free | Workers Paid | |
|---|---|---|
| Dimensiones consultadas | 30 millones al mes | 50 millones incluidas, después 0,01 $ por millón |
| Dimensiones almacenadas | 5 millones | 10 millones incluidas, después 0,05 $ por cada 100 millones |
Según la documentación, las dimensiones consultadas de un mes son (consultas + vectores almacenados) × dimensiones, y las almacenadas, vectores × dimensiones. Para este blog: 30 artículos troceados en unos 600 trozos de 1.024 dimensiones son 614.400 dimensiones almacenadas, muy lejos de los 5 millones gratis. Con 3.000 preguntas al mes, (3.000 + 600) × 1.024 ≈ 3,7 millones de dimensiones consultadas, también dentro de lo gratuito. La documentación pone como ejemplo de producción 50.000 vectores de 768 dimensiones y 200.000 consultas al mes: 1,94 $.
El código: un RAG para el blog
La configuración tiene tres bindings: Workers AI, el índice de Vectorize y el nombre del gateway de AI Gateway por el que pasan las llamadas al modelo:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "rag-blog",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "ai": { "binding": "AI" },
  "vectorize": [{ "binding": "VECTORIZE", "index_name": "blog-rag" }],
  "vars": { "GATEWAY_ID": "blog" }
}
Trocear
Un artículo entero no cabe bien en un vector: el embedding de 2.000 palabras es una media borrosa de todo. Lo habitual es partirlo en trozos de unos cientos de caracteres, respetando párrafos y con un pequeño solape para no cortar una idea por la mitad:
/**
 * Parte un texto en trozos de como mucho `max` caracteres, respetando párrafos
 * cuando se puede y repitiendo `solape` caracteres entre trozos consecutivos
 * para no cortar una idea por la mitad.
 */
export function trocear(texto: string, max = 800, solape = 120): string[] {
  const parrafos = texto
    .split(/\n\s*\n/)
    .map((p) => p.replace(/\s+/g, " ").trim())
    .filter(Boolean);

  const trozos: string[] = [];
  let actual = "";

  const cerrar = () => {
    if (actual) trozos.push(actual);
    // el siguiente trozo empieza con la cola del anterior (solape)
    actual = actual.length > solape ? actual.slice(-solape) : "";
  };

  for (const p of parrafos) {
    // párrafos gigantes: piezas de `max - solape - 1` para que quepan tras el solape y el espacio
    const tope = max - solape - 1;
    const piezas = p.length > tope ? (p.match(new RegExp(`.{1,${tope}}`, "g")) ?? []) : [p];
    for (const pieza of piezas) {
      if (actual.length + pieza.length + 1 > max) cerrar();
      actual = actual ? `${actual} ${pieza}` : pieza;
    }
  }
  if (actual && actual !== trozos.at(-1)?.slice(-actual.length)) trozos.push(actual);
  return trozos;
}max - solape caracteres; al pegar el solape y un espacio delante, el trozo salía de 801 caracteres con un máximo de 800. El test «corta párrafos gigantes» falló, y la corrección es el - 1 de tope. Por cosas así merece la pena probar aunque no haya simulador.Indexar y preguntar
import { trocear } from "./trocear";

// Tipamos el entorno a mano: `wrangler types` (4.147) genera VectorizeIndex,
// que es el tipo de la beta (V1). Para índices V2 el tipo correcto es Vectorize.
export interface Entorno {
  AI: Ai;
  VECTORIZE: Vectorize;
  GATEWAY_ID: string;
}

export const MODELO_EMBEDDINGS = "@cf/baai/bge-m3"; // multilingüe, va bien en español
export const MODELO_LLM = "@cf/meta/llama-3.3-70b-instruct-fp8-fast";
export const UMBRAL = 0.5; // similitud coseno mínima: heurística, ajústala con tus datos

interface Documento {
  id: string;
  titulo: string;
  url: string;
  tag?: string;
  texto: string;
}

async function incrustar(env: Entorno, textos: string[]): Promise<number[][]> {
  const salida = await env.AI.run(
    MODELO_EMBEDDINGS,
    { text: textos },
    { gateway: { id: env.GATEWAY_ID } },
  );
  if (!("data" in salida) || !salida.data) throw new Error("respuesta de embeddings inesperada");
  return salida.data;
}

async function indexar(env: Entorno, doc: Documento): Promise<Response> {
  // el id de cada vector es "<doc>#<n>" y Vectorize admite como mucho 64 bytes
  if (new TextEncoder().encode(`${doc.id}#9999`).length > 64) {
    return Response.json({ error: "id demasiado largo (máx. 64 bytes con el sufijo)" }, { status: 400 });
  }
  const trozos = trocear(doc.texto);
  const mutaciones: string[] = [];

  // lotes de 50 trozos por llamada: prudente, no es un límite documentado
  for (let i = 0; i < trozos.length; i += 50) {
    const lote = trozos.slice(i, i + 50);
    const vectores = await incrustar(env, lote);
    const { mutationId } = await env.VECTORIZE.upsert(
      vectores.map((values, j) => ({
        id: `${doc.id}#${i + j}`,
        values,
        metadata: { doc: doc.id, titulo: doc.titulo, url: doc.url, tag: doc.tag ?? "", texto: lote[j] },
      })),
    );
    mutaciones.push(mutationId);
  }
  // upsert es asíncrono: los vectores tardan unos segundos en poder consultarse
  return Response.json({ trozos: trozos.length, mutaciones }, { status: 202 });
}

async function preguntar(env: Entorno, pregunta: string, tag: string | null): Promise<Response> {
  const [vector] = await incrustar(env, [pregunta]);
  const { matches } = await env.VECTORIZE.query(vector, {
    topK: 4,
    returnMetadata: "all",
    // filtrar por tag exige un metadata index sobre "tag" creado ANTES de insertar
    ...(tag ? { filter: { tag: { $eq: tag } } } : {}),
  });

  const utiles = matches.filter((m) => m.score >= UMBRAL);
  if (utiles.length === 0) {
    // sin contexto no llamamos al LLM: ni gastamos neuronas ni le dejamos inventar
    return Response.json({ respuesta: "No encuentro nada sobre eso en el blog.", fuentes: [] });
  }

  const contexto = utiles
    .map((m, i) => `[${i + 1}] ${m.metadata?.titulo}\n${m.metadata?.texto}`)
    .join("\n\n");

  const salida = await env.AI.run(
    MODELO_LLM,
    {
      messages: [
        {
          role: "system",
          content:
            "Eres el asistente del blog. Responde en español y SOLO con la información del contexto. " +
            "Cita las fuentes como [1], [2]… Si el contexto no basta, dilo.\n\nContexto:\n" + contexto,
        },
        { role: "user", content: pregunta },
      ],
      max_tokens: 400,
    },
    {
      gateway: {
        id: env.GATEWAY_ID,
        cacheTtl: 3600, // misma pregunta exacta → respuesta desde la caché del gateway
        metadata: { ruta: "preguntar" },
      },
    },
  );

  // el tipo de salida es una unión: objeto con `response`, string o respuesta de lote
  const respuesta =
    typeof salida === "string" ? salida : "response" in salida ? salida.response : null;
  return Response.json({
    respuesta,
    fuentes: utiles.map((m) => ({
      titulo: m.metadata?.titulo,
      url: m.metadata?.url,
      score: Number(m.score.toFixed(3)),
    })),
  });
}

export default {
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);

    if (request.method === "POST" && url.pathname === "/indexar") {
      const doc = (await request.json()) as Documento;
      if (!doc?.id || !doc.texto) return Response.json({ error: "faltan id o texto" }, { status: 400 });
      return indexar(env, doc);
    }

    if (request.method === "GET" && url.pathname === "/preguntar") {
      const q = url.searchParams.get("q")?.trim();
      if (!q) return Response.json({ error: "falta ?q=" }, { status: 400 });
      return preguntar(env, q, url.searchParams.get("tag"));
    }

    return new Response("POST /indexar · GET /preguntar?q=…\n", { status: 404 });
  },
} satisfies ExportedHandler<Entorno>;
Las decisiones importantes:
- El tipo del entorno está escrito a mano.
wrangler typesgeneraVECTORIZE: VectorizeIndex, que según sus propios comentarios es el tipo de la beta (índices V1, obsoletos). Para un índice actual, el tipo correcto esVectorize. - Ids
documento#n, comprobando antes que caben en los 64 bytes. - El texto del trozo va en los metadatos, para no tener que buscarlo en otra base de datos al responder.
- Umbral de similitud. Si ningún trozo pasa de 0,5, no se llama al modelo: no gasta neuronas y no le das ocasión de inventarse una respuesta. El 0,5 es una heurística; ajústalo con preguntas reales.
upsertes asíncrono. Si indexas y preguntas al momento, puede que no encuentre nada. Por eso/indexarresponde 202 con losmutationId.
Los tests
Los dobles imitan la forma de las respuestas: el de Workers AI convierte cada texto en un vector según qué palabras contiene, y el de Vectorize guarda los vectores en memoria y ordena por similitud coseno. No sustituyen a una prueba real (ni la calidad de bge-m3 ni la de Llama están aquí), pero comprueban toda la lógica del Worker:
 ✓ test/rag.test.ts > trocear > respeta el máximo, solapa y no deja trozos vacíos
 ✓ test/rag.test.ts > trocear > corta párrafos gigantes
 ✓ test/rag.test.ts > worker RAG (con dobles) > indexa: un vector por trozo, id doc#n y metadatos
 ✓ test/rag.test.ts > worker RAG (con dobles) > rechaza ids que no caben en 64 bytes
 ✓ test/rag.test.ts > worker RAG (con dobles) > pregunta: recupera, pasa el contexto al LLM por el gateway y devuelve fuentes
 ✓ test/rag.test.ts > worker RAG (con dobles) > sin coincidencias por encima del umbral no llama al LLM
 ✓ test/rag.test.ts > worker RAG (con dobles) > filtra por tag
      Tests  7 passed (7)
Para usarlo de verdad: crear el índice y el índice de metadatos (los comandos de arriba), npx wrangler deploy, mandar cada artículo a /indexar y preguntar con /preguntar?q=…&tag=Cloudflare. Cada paso gasta de tu cuota.
Errores comunes (y cómo evitarlos)
- Dimensiones que no coinciden con el modelo. Un índice de 768 con embeddings de 1.024 falla al insertar. Y no se puede cambiar: hay que crear otro índice.
- Cambiar de modelo de embeddings sin reindexar. Los vectores de modelos distintos no son comparables, aunque tengan las mismas dimensiones.
- Crear el índice de metadatos después de insertar. Los filtros no verán los vectores antiguos.
- Preguntar justo después de insertar. Las escrituras son asíncronas.
- Trozos demasiado grandes o demasiado pequeños. Grandes: el vector no representa nada concreto. Pequeños: el modelo recibe frases sueltas sin contexto. Entre 500 y 1.000 caracteres con solape es un buen punto de partida.
- Pedir
returnMetadata: "all"contopK100. El máximo con metadatos es 50. - No guardar el texto. Si en los metadatos solo hay un id, tendrás que consultar otra base de datos para cada trozo antes de llamar al modelo.
Cuándo usar Vectorize (y cuándo no)
Úsalo para búsqueda semántica, RAG sobre tus documentos, recomendaciones («artículos parecidos») o detección de duplicados, sobre todo si ya usas Workers y Workers AI: todo queda en la misma cuenta, sin servidores y con una cuota gratuita generosa.
No lo necesitas si tu búsqueda es por palabras exactas (el índice de texto completo de D1, con FTS5, es más simple) o si tienes pocos cientos de vectores y ya usas PostgreSQL con pgvector a través de Hyperdrive.
Sigue leyendo
- Cloudflare a fondo: la visión general de la plataforma.
- Cloudflare Workers AI a fondo: los modelos de embeddings y de lenguaje del RAG.
- Cloudflare AI Gateway a fondo: caché y logs para las llamadas al modelo.
- Cloudflare Workflows a fondo: para indexar archivos grandes paso a paso, con reintentos.
- Cloudflare D1 a fondo: cuando basta con buscar palabras.