Cloudflare Hyperdrive a fondo: tu PostgreSQL o MySQL de siempre, rápido desde Workers
Qué es Hyperdrive y cómo acelera una base de datos PostgreSQL o MySQL existente desde Workers: conexión en el borde, pool en modo transacción y caché de lecturas, límites y precios, y un Worker con pg probado en local contra PostgreSQL 17.
Contenido
D1 está muy bien si empiezas de cero, pero la mayoría de proyectos reales ya tienen una base de datos: un PostgreSQL en RDS, un Supabase, un MySQL en un VPS. Conectarse a ella desde un Worker tiene dos problemas. El primero es la latencia: abrir una conexión TLS con autenticación son varios viajes de ida y vuelta, y si tu Worker está en Madrid y la base de datos en Virginia, cada uno cuesta lo suyo. El segundo es el número de conexiones: los Workers no tienen estado entre peticiones, así que cada petición abriría una conexión nueva y una base de datos normal se queda sin conexiones enseguida.
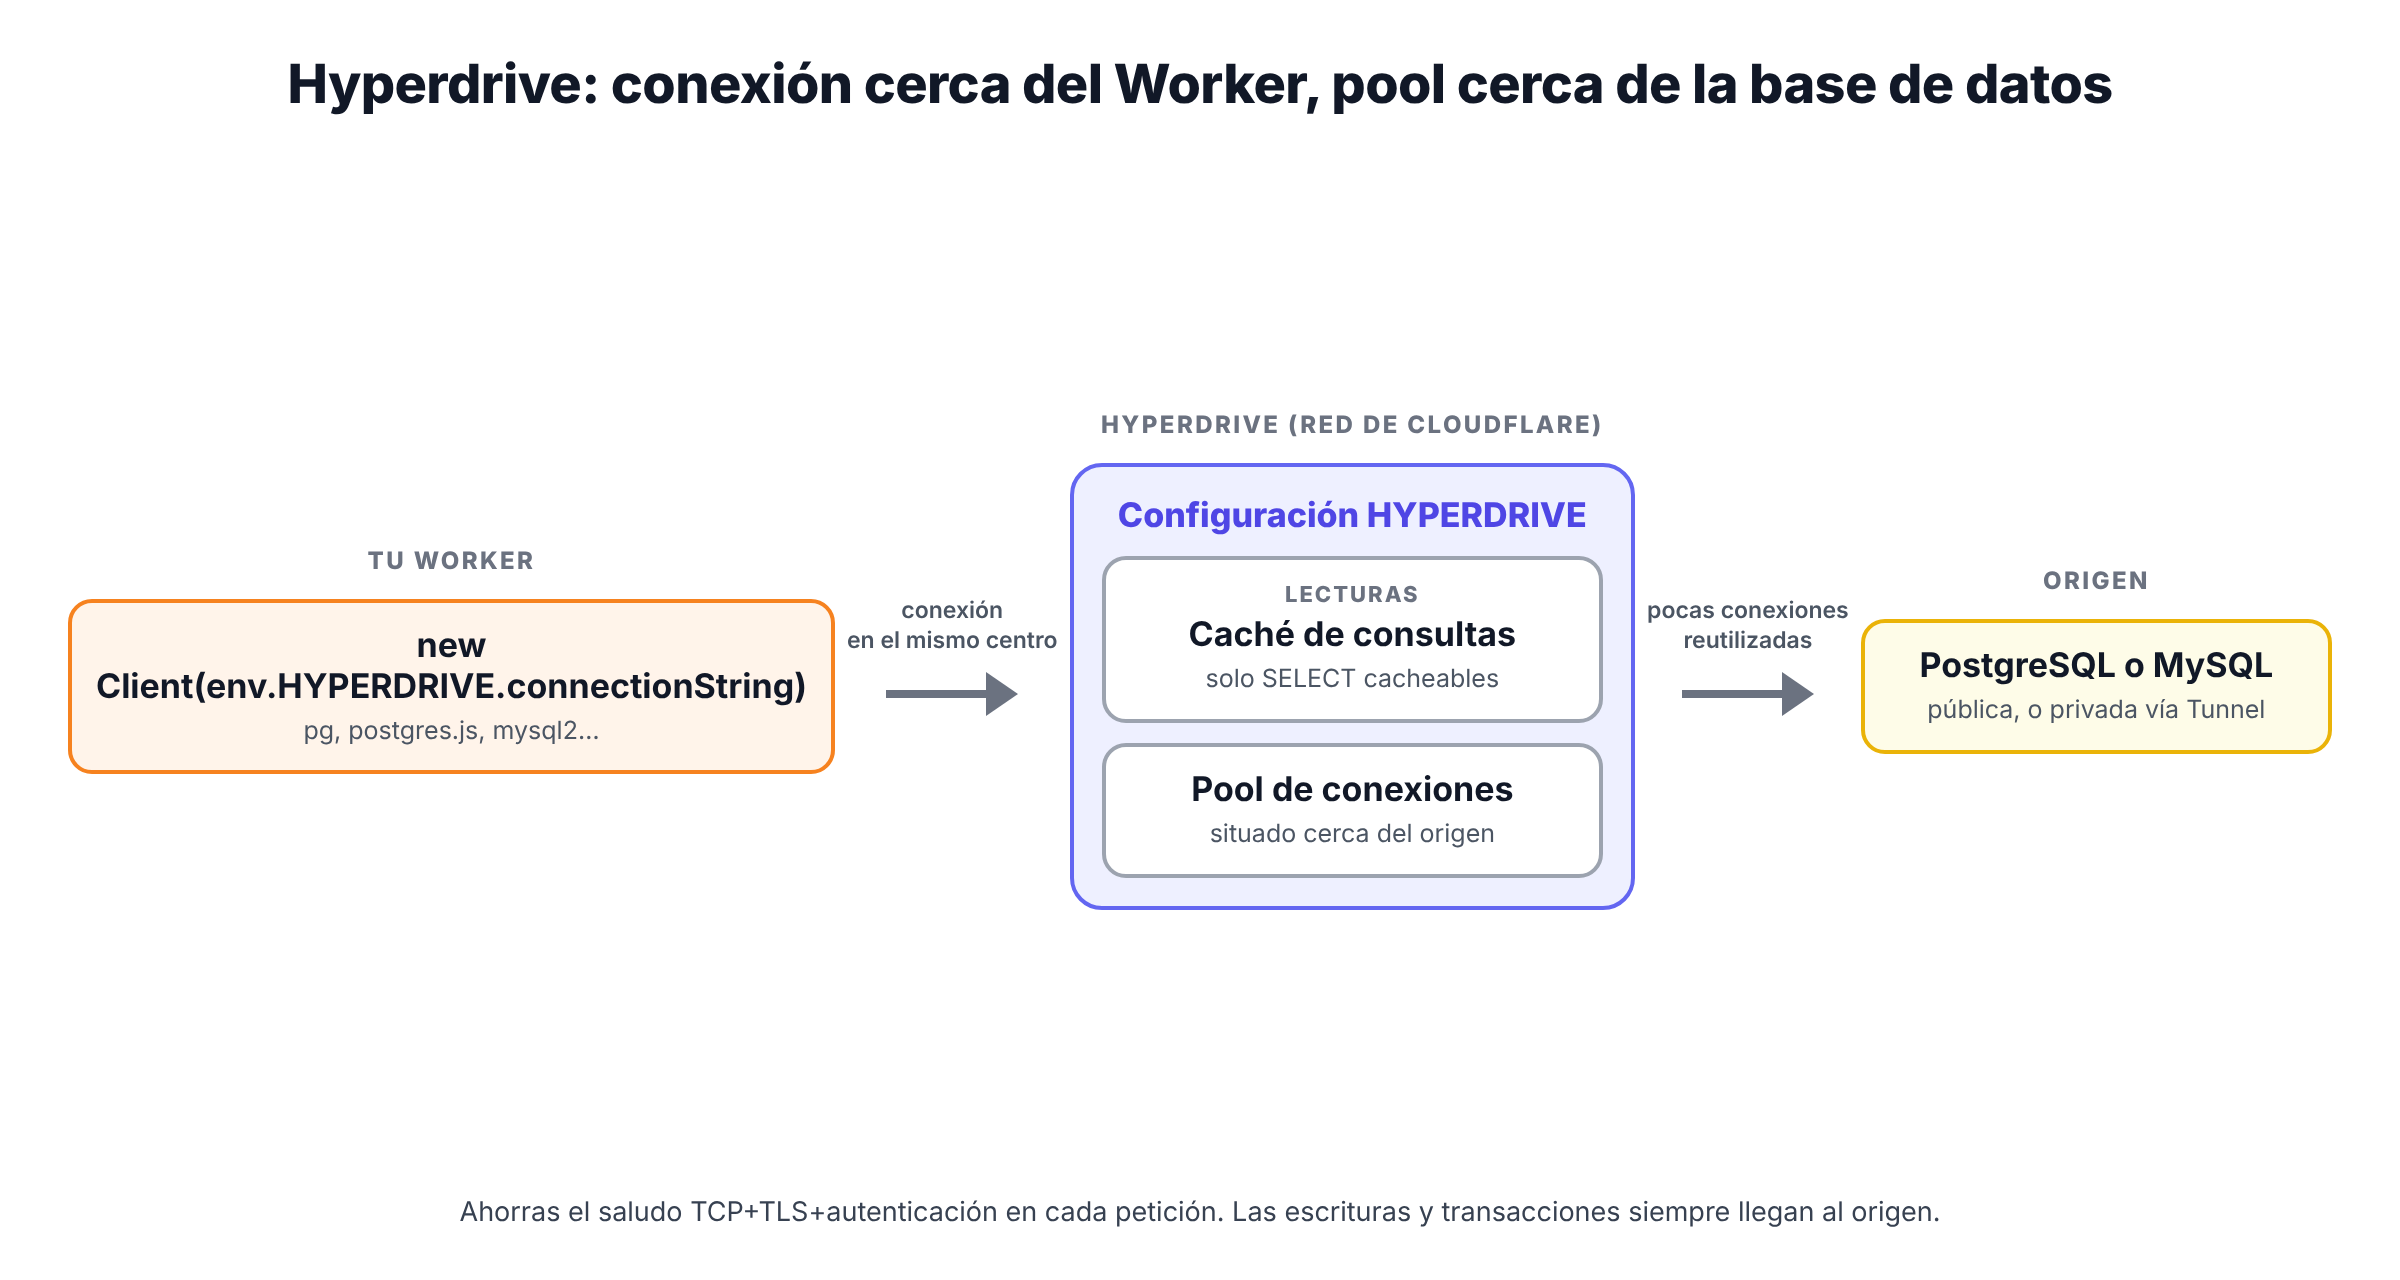
Hyperdrive resuelve las dos cosas. Es un servicio que se coloca entre tu Worker y tu base de datos y hace tres trabajos: establece la conexión cerca del Worker, mantiene un pool de conexiones cerca de la base de datos y cachea las consultas de lectura. Tu código sigue usando el driver de siempre (pg, postgres.js, mysql2) y SQL normal.
En este artículo vemos cómo funciona, qué se cachea y qué no, sus límites y precios, y un Worker con pg que lee, escribe y hace una transacción, ejecutado en local contra un PostgreSQL 17 real.
Cómo funciona
Sin Hyperdrive, un Worker que habla con PostgreSQL hace todo el saludo (TCP, TLS, autenticación) contra un servidor que puede estar a cientos de milisegundos, y lo repite en cada petición. Con Hyperdrive, el recorrido cambia en tres puntos:
- Conexión en el borde. El driver de tu Worker hace el saludo con Hyperdrive en el mismo centro de datos, así que es casi instantáneo.
- Pool cerca del origen. Hyperdrive mantiene conexiones abiertas con tu base de datos desde una región próxima a ella y las reutiliza entre peticiones e incluso entre Workers.
- Caché de lecturas. Si la consulta es de solo lectura y cacheable, Hyperdrive puede responder sin llegar a la base de datos.
El pool trabaja en modo transacción
Hyperdrive asigna una conexión real a tu cliente durante una transacción y la devuelve al pool al terminar. Tiene consecuencias prácticas:
- Un
SETsolo dura lo que dura la transacción o la consulta en la que va. No sirve para configurar la sesión una vez y olvidarse. - Las transacciones con
BEGIN/COMMITfuncionan y usan una única conexión de principio a fin. - Los prepared statements con nombre están soportados tal como los implementan
node-postgresypostgres.js. Con otros drivers pueden ir peor o no funcionar.
Qué se cachea
Hyperdrive analiza el protocolo de la base de datos y distingue las consultas que escriben de las que solo leen. Se cachean las lecturas; nunca se cachean:
- las escrituras (
INSERT,UPDATE,DELETE,CREATE TABLE…); - las consultas que usan funciones
volatileostablede PostgreSQL, comoNOW(),CURRENT_DATE,RANDOM()oLASTVAL().
La caché viene activada por defecto con max_age de 60 segundos y stale_while_revalidate de 15 segundos. Puedes subir max_age hasta 1 hora o desactivar la caché en la configuración.
INSERT y justo después el mismo SELECT, puedes recibir el resultado antiguo hasta que venza max_age. Si necesitas leer lo que acabas de escribir, usa una configuración de Hyperdrive sin caché para esas consultas o baja max_age.Un truco que recomienda la propia documentación: si filtras por fecha, pasa la fecha como parámetro en vez de usar CURRENT_DATE. Así la consulta deja de ser stable y se puede cachear.
Límites y precios
Hyperdrive está incluido en los dos planes de Workers. El pool y la caché no cuestan nada aparte, y tampoco hay cargo por transferencia de datos.
| Concepto | Free | Paid |
|---|---|---|
| Consultas a la base de datos | 100 000 al día | Ilimitadas |
| Configuraciones por cuenta | 10 | 25 |
| Conexiones al origen por configuración | ~20 | ~100 |
| Duración máxima de una consulta | 60 s | 60 s |
| Respuesta máxima cacheable | 50 MB | 50 MB |
| Tiempo de espera para conectar | 15 s | 15 s |
| Conexión inactiva en el pool | 10 min | 10 min |
Las consultas cuentan todas, se respondan de caché o no, y sean lecturas, escrituras o cambios de esquema. El cupo del plan Free se reinicia a las 00:00 UTC (las 2:00 en España en horario de verano). El límite de conexiones al origen es aproximado: como el sistema es distribuido, a veces se crea un pool nuevo y el total puede pasarse un poco. Las respuestas de más de 50 MB se devuelven, pero no se cachean.
Configuración
Creas la configuración con la cadena de conexión de tu base de datos y Wrangler te devuelve un id:
npx wrangler hyperdrive create tienda \
  --connection-string="postgres://usuario:contraseñ[email protected]:5432/tienda"
Ese id va en el binding de wrangler.jsonc:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "hyperdrive-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "hyperdrive": [
    {
      "binding": "HYPERDRIVE",
      // id de la configuración creada con `wrangler hyperdrive create`
      "id": "00000000000000000000000000000000"
      // en local, la cadena sale de la variable de entorno
      // CLOUDFLARE_HYPERDRIVE_LOCAL_CONNECTION_STRING_HYPERDRIVE
    }
  ]
}
Con compatibility_date igual o posterior al 4 de agosto de 2026, la compatibilidad con Node.js (nodejs_compat) viene activada por defecto, que es lo que necesita pg. Con fechas anteriores tienes que añadir el flag a mano.
Desarrollo en local
En local no hay Hyperdrive de verdad: el binding conecta directamente con la base de datos que le digas, sin pool ni caché. La forma recomendada es una variable de entorno con el nombre del binding al final, para no subir credenciales al repositorio:
export CLOUDFLARE_HYPERDRIVE_LOCAL_CONNECTION_STRING_HYPERDRIVE="postgres://lab:lab@localhost:5432/tienda"
npx wrangler dev
También existe el campo localConnectionString en el binding; si están los dos, gana la variable de entorno. Con wrangler dev --remote el Worker se ejecuta en Cloudflare con tu configuración real, pool y caché incluidos (eso no lo he probado).
El código
La tabla de ejemplo:
CREATE TABLE IF NOT EXISTS productos (
  id     serial PRIMARY KEY,
  nombre text NOT NULL,
  precio numeric(10,2) NOT NULL,
  stock  int NOT NULL DEFAULT 0
);
TRUNCATE productos RESTART IDENTITY;
INSERT INTO productos (nombre, precio, stock) VALUES
  ('Teclado mecánico', 89.90, 12),
  ('Ratón inalámbrico', 34.50, 40),
  ('Monitor 27"', 279.00, 5);
Y el Worker, con una lectura con parámetro, una escritura, una transacción y una consulta con now() que nunca se cachearía:
import { Client } from "pg";

export default {
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);

    // Un cliente nuevo por petición: Hyperdrive mantiene el pool de verdad.
    // Nunca lo crees en el ámbito global del módulo.
    const sql = new Client({ connectionString: env.HYPERDRIVE.connectionString });
    await sql.connect();

    try {
      if (url.pathname === "/productos" && request.method === "GET") {
        // Lectura sin funciones volátiles: Hyperdrive puede cachearla
        const max = Number(url.searchParams.get("max") ?? 1000);
        const { rows } = await sql.query(
          "SELECT id, nombre, precio, stock FROM productos WHERE precio <= $1 ORDER BY id",
          [max],
        );
        return Response.json(rows);
      }

      if (url.pathname === "/productos" && request.method === "POST") {
        const { nombre, precio } = await request.json<{ nombre: string; precio: number }>();
        // Escritura: nunca se cachea
        const { rows } = await sql.query(
          "INSERT INTO productos (nombre, precio) VALUES ($1, $2) RETURNING id",
          [nombre, precio],
        );
        return Response.json({ id: rows[0].id }, { status: 201 });
      }

      if (url.pathname === "/comprar" && request.method === "POST") {
        const { id } = await request.json<{ id: number }>();
        // Transacción: en modo transacción el pool te da UNA conexión hasta COMMIT
        await sql.query("BEGIN");
        const { rows } = await sql.query(
          "UPDATE productos SET stock = stock - 1 WHERE id = $1 AND stock > 0 RETURNING stock",
          [id],
        );
        if (rows.length === 0) {
          await sql.query("ROLLBACK");
          return Response.json({ error: "sin stock" }, { status: 409 });
        }
        await sql.query("COMMIT");
        return Response.json({ id, stock: rows[0].stock });
      }

      if (url.pathname === "/info") {
        // NOW() es STABLE: esta consulta no se cachea nunca
        const { rows } = await sql.query("SELECT version(), now() AS ahora");
        return Response.json(rows[0]);
      }

      return new Response("No encontrado", { status: 404 });
    } catch (e) {
      console.error(e);
      return Response.json({ error: (e as Error).message }, { status: 500 });
    }
    // No hace falta sql.end(): la conexión Worker→Hyperdrive se limpia sola
    // al acabar la invocación.
  },
} satisfies ExportedHandler<Env>;
Dos detalles que marca la documentación. El cliente se crea dentro del handler, nunca en el ámbito global: los Workers no permiten reutilizar E/S entre peticiones y el pool ya lo pone Hyperdrive. Y no hace falta llamar a sql.end(): la conexión entre el Worker e Hyperdrive se cierra sola al acabar la invocación, mientras la conexión con la base de datos sigue abierta en el pool.
Ejecución en local
Con wrangler dev levantado en el puerto 8802 y el PostgreSQL local cargado con seed.sql:
$ curl -s "localhost:8802/productos?max=100"
[{"id":1,"nombre":"Teclado mecánico","precio":"89.90","stock":12},{"id":2,"nombre":"Ratón inalámbrico","precio":"34.50","stock":40}]
$ curl -s -X POST localhost:8802/productos -d '{"nombre":"Webcam HD","precio":49.99}'
{"id":4} (HTTP 201)
$ curl -s -X POST localhost:8802/comprar -d '{"id":3}'
{"id":3,"stock":4} (HTTP 200)
$ curl -s -X POST localhost:8802/comprar -d '{"id":3}'
{"id":3,"stock":3} (HTTP 200)
$ curl -s -X POST localhost:8802/comprar -d '{"id":3}'
{"id":3,"stock":2} (HTTP 200)
$ curl -s -X POST localhost:8802/comprar -d '{"id":3}'
{"id":3,"stock":1} (HTTP 200)
$ curl -s -X POST localhost:8802/comprar -d '{"id":3}'
{"id":3,"stock":0} (HTTP 200)
$ curl -s -X POST localhost:8802/comprar -d '{"id":3}'
{"error":"sin stock"} (HTTP 409)
$ curl -s localhost:8802/info
{"version":"PostgreSQL 17.11 (Debian 17.11-0+deb13u1) on x86_64-pc-linux-gnu, compiled by gcc (Debian 14.2.0-19) 14.2.0, 64-bit","ahora":"2026-10-02T22:34:47.115Z"}
Wrangler detecta la variable y lo dice al arrancar: «Found a non-empty CLOUDFLARE_HYPERDRIVE_LOCAL_CONNECTION_STRING_HYPERDRIVE variable for binding». Fíjate en dos cosas de la salida. El precio llega como texto ("89.90"): pg devuelve los numeric como cadena para no perder precisión, así que conviértelo tú si lo necesitas como número. Y la sexta compra devuelve 409 porque el UPDATE … WHERE stock > 0 no encuentra filas y la transacción hace ROLLBACK.
Bases de datos privadas
Si tu base de datos no está expuesta a internet (lo normal), Hyperdrive puede llegar a ella de dos formas:
- Workers VPC, que la documentación marca como la opción recomendada y no necesita configurar Access.
- Cloudflare Tunnel + Access:
cloudflaredcorre en tu red, abre una conexión saliente hacia Cloudflare y una aplicación de Access con un token de servicio garantiza que solo tu configuración de Hyperdrive puede usar ese túnel. Necesitas un dominio en Cloudflare. Lo cuento en el artículo sobre Cloudflare Tunnel.
Errores comunes (y cómo evitarlos)
- Crear el cliente o un pool en el ámbito global. Falla entre peticiones. Crea un
Clientpor petición; Hyperdrive ya hace el pool. - Montar tu propio pool encima. Un
new Pool({ max: 20 })del driver no aporta nada y puede acaparar conexiones. - Esperar leer lo que acabas de escribir. La caché no se invalida al escribir. Separa las consultas que necesitan datos frescos.
- Usar
NOW()en consultas que podrían cachearse. Pasa la fecha como parámetro. - Transacciones largas. Mientras dura una transacción, esa conexión no vuelve al pool. Con ~20 conexiones en Free, unas pocas transacciones lentas producen «Failed to acquire a connection from the pool».
- Confiar en
SETde sesión. En modo transacción, unSETfuera de una transacción no persiste. - Olvidar
sslmodeen local con una base de datos remota. ConlocalConnectionStringhacia un servidor remoto tienes que indicar el modo TLS (sslmode=requireen PostgreSQL,sslMode=REQUIREDen MySQL). - Probar el rendimiento en local. En
wrangler devno hay pool ni caché; las cifras no se parecen a producción.
Cuándo usar Hyperdrive (y cuándo no)
Úsalo cuando ya tienes PostgreSQL o MySQL y quieres usarlo desde Workers sin reescribir nada, cuando necesitas todo lo que da una base de datos completa (extensiones, joins complejos, PostGIS) o cuando tus datos tienen que estar en una región concreta.
No lo necesitas si empiezas un proyecto pequeño desde cero (D1 es más sencillo y no necesitas servidor), si lo que guardas es configuración o caché clave-valor (KV) o si necesitas estado por usuario o por sala con coordinación (Durable Objects). Y si tu Worker hace muchas consultas seguidas por petición, combina Hyperdrive con Placement para que el Worker se ejecute cerca de la base de datos: cada viaje pasa de 20-30 ms a 1-3 ms, según la documentación.
Sigue leyendo
- Cloudflare a fondo: la visión general de la plataforma.
- Cloudflare D1 a fondo: la base de datos SQL propia de Cloudflare.
- Cloudflare Workers a fondo: el runtime desde el que conectas.
- Cloudflare Tunnel a fondo: cómo llegar a una base de datos privada.
- Planes de Cloudflare Workers: Free frente a Paid: qué cambia en cada plan.