Cloudflare Workers a fondo: código en el borde de la red, explicado por dentro y con código probado
Isolates de V8, el ciclo de vida de una petición, wrangler.jsonc, bindings, variables y secretos, ficheros estáticos, Cache API, cron, desarrollo local con Miniflare, pruebas con Vitest, despliegues graduales y límites reales de Workers, con todo el código probado.
Contenido
Durante años, "desplegar un backend" significaba elegir una región, levantar un servidor (o un contenedor, o una función Lambda) y rezar para que el usuario no estuviera en la otra punta del mundo. Cloudflare Workers le da la vuelta a esa idea: tu código no vive en una región, sino en todos los centros de datos de la red de Cloudflare a la vez, y se ejecuta en el que esté más cerca de quien hace la petición.
Lo interesante no es solo dónde se ejecuta, sino cómo. Un Worker no es un contenedor ni una máquina virtual: es un isolate de V8, el mismo mecanismo que usa Chrome para separar las pestañas. Arranca en milisegundos, comparte proceso con miles de Workers de otros clientes y cobra por el tiempo de CPU que de verdad usas, no por el tiempo que pasas esperando a una base de datos.
En este artículo vamos a verlo a fondo: qué es, cómo funciona por dentro, cómo se instala con Wrangler, cómo se configura con wrangler.jsonc, cómo se conecta con el resto de la plataforma mediante bindings, y después mucho código: rutas, variables y secretos, ficheros estáticos, la Cache API, tareas programadas con cron, desarrollo local, pruebas con Vitest y despliegue. Es el artículo central de la serie; el resto (R2, D1, KV, Durable Objects, Queues, Pages y los planes) se apoya en lo que veremos aquí.
wrangler deploy, wrangler secret put, despliegues graduales); lo marco donde aparece.Qué es Cloudflare Workers
Workers es la plataforma de computación serverless de Cloudflare. Escribes una función (en JavaScript, TypeScript, Python o cualquier lenguaje que compile a WebAssembly), la despliegas con un comando y Cloudflare la ejecuta en su red global cada vez que llega una petición. No hay servidores que mantener, ni regiones que elegir, ni escalado que configurar.
Un Worker moderno es un módulo ES que exporta un objeto con manejadores: fetch para peticiones HTTP, scheduled para tareas programadas, queue para consumir colas, email para correo entrante... El más importante es fetch, que recibe un Request estándar y devuelve un Response estándar, los mismos objetos que usas con fetch() en el navegador.
export default {
  async fetch(request, env, ctx): Promise<Response> {
    return new Response("¡Hola desde el borde!");
  },
} satisfies ExportedHandler<Env>;
Los tres parámetros son la clave de todo lo demás:
request: la petición entrante, con una propiedad extra,request.cf, donde Cloudflare te cuenta el país, la ciudad, el centro de datos (colo), el protocolo y bastante más.env: los bindings. Variables de entorno, secretos, y las conexiones a KV, R2, D1, colas, Durable Objects u otros Workers. No hayprocess.envni cadenas de conexión: Cloudflare te inyecta objetos ya listos para usar.ctx: el contexto de ejecución. Su método estrella esctx.waitUntil(promesa), que permite seguir trabajando después de haber respondido al cliente.
Lo que lo hace distinto
- Sin arranques en frío apreciables. Un isolate de V8 se crea en milisegundos dentro de un proceso que ya está en marcha; no hay que arrancar un contenedor ni un sistema operativo.
- Pagas CPU, no espera. El límite y la factura se miden en tiempo de CPU. Mientras esperas a un
fetch()o a una consulta, el reloj de CPU no corre. - Estándares web.
fetch,Request,Response,URL,crypto.subtle,ReadableStream,WebSocket,Cache... Si sabes escribir JavaScript para el navegador, ya sabes escribir un Worker. Con el flagnodejs_compattienes además buena parte de la API de Node. - Toda la plataforma a un binding de distancia. Almacenamiento de objetos (R2), base de datos SQL (D1), clave-valor global (KV), estado coordinado (Durable Objects), colas, IA... todo se conecta con dos líneas de configuración.
- Una capa gratuita generosa. 100.000 peticiones al día sin pagar nada; el plan de pago empieza en 5 dólares al mes. Lo detallo en el artículo de los planes.
Cómo funciona por dentro
Isolates de V8 en lugar de contenedores
La mayoría de plataformas serverless ejecutan cada función en su propio contenedor o microVM con su propio runtime de Node o Python. Eso tiene un coste fijo por instancia: memoria, arranque, un proceso entero.
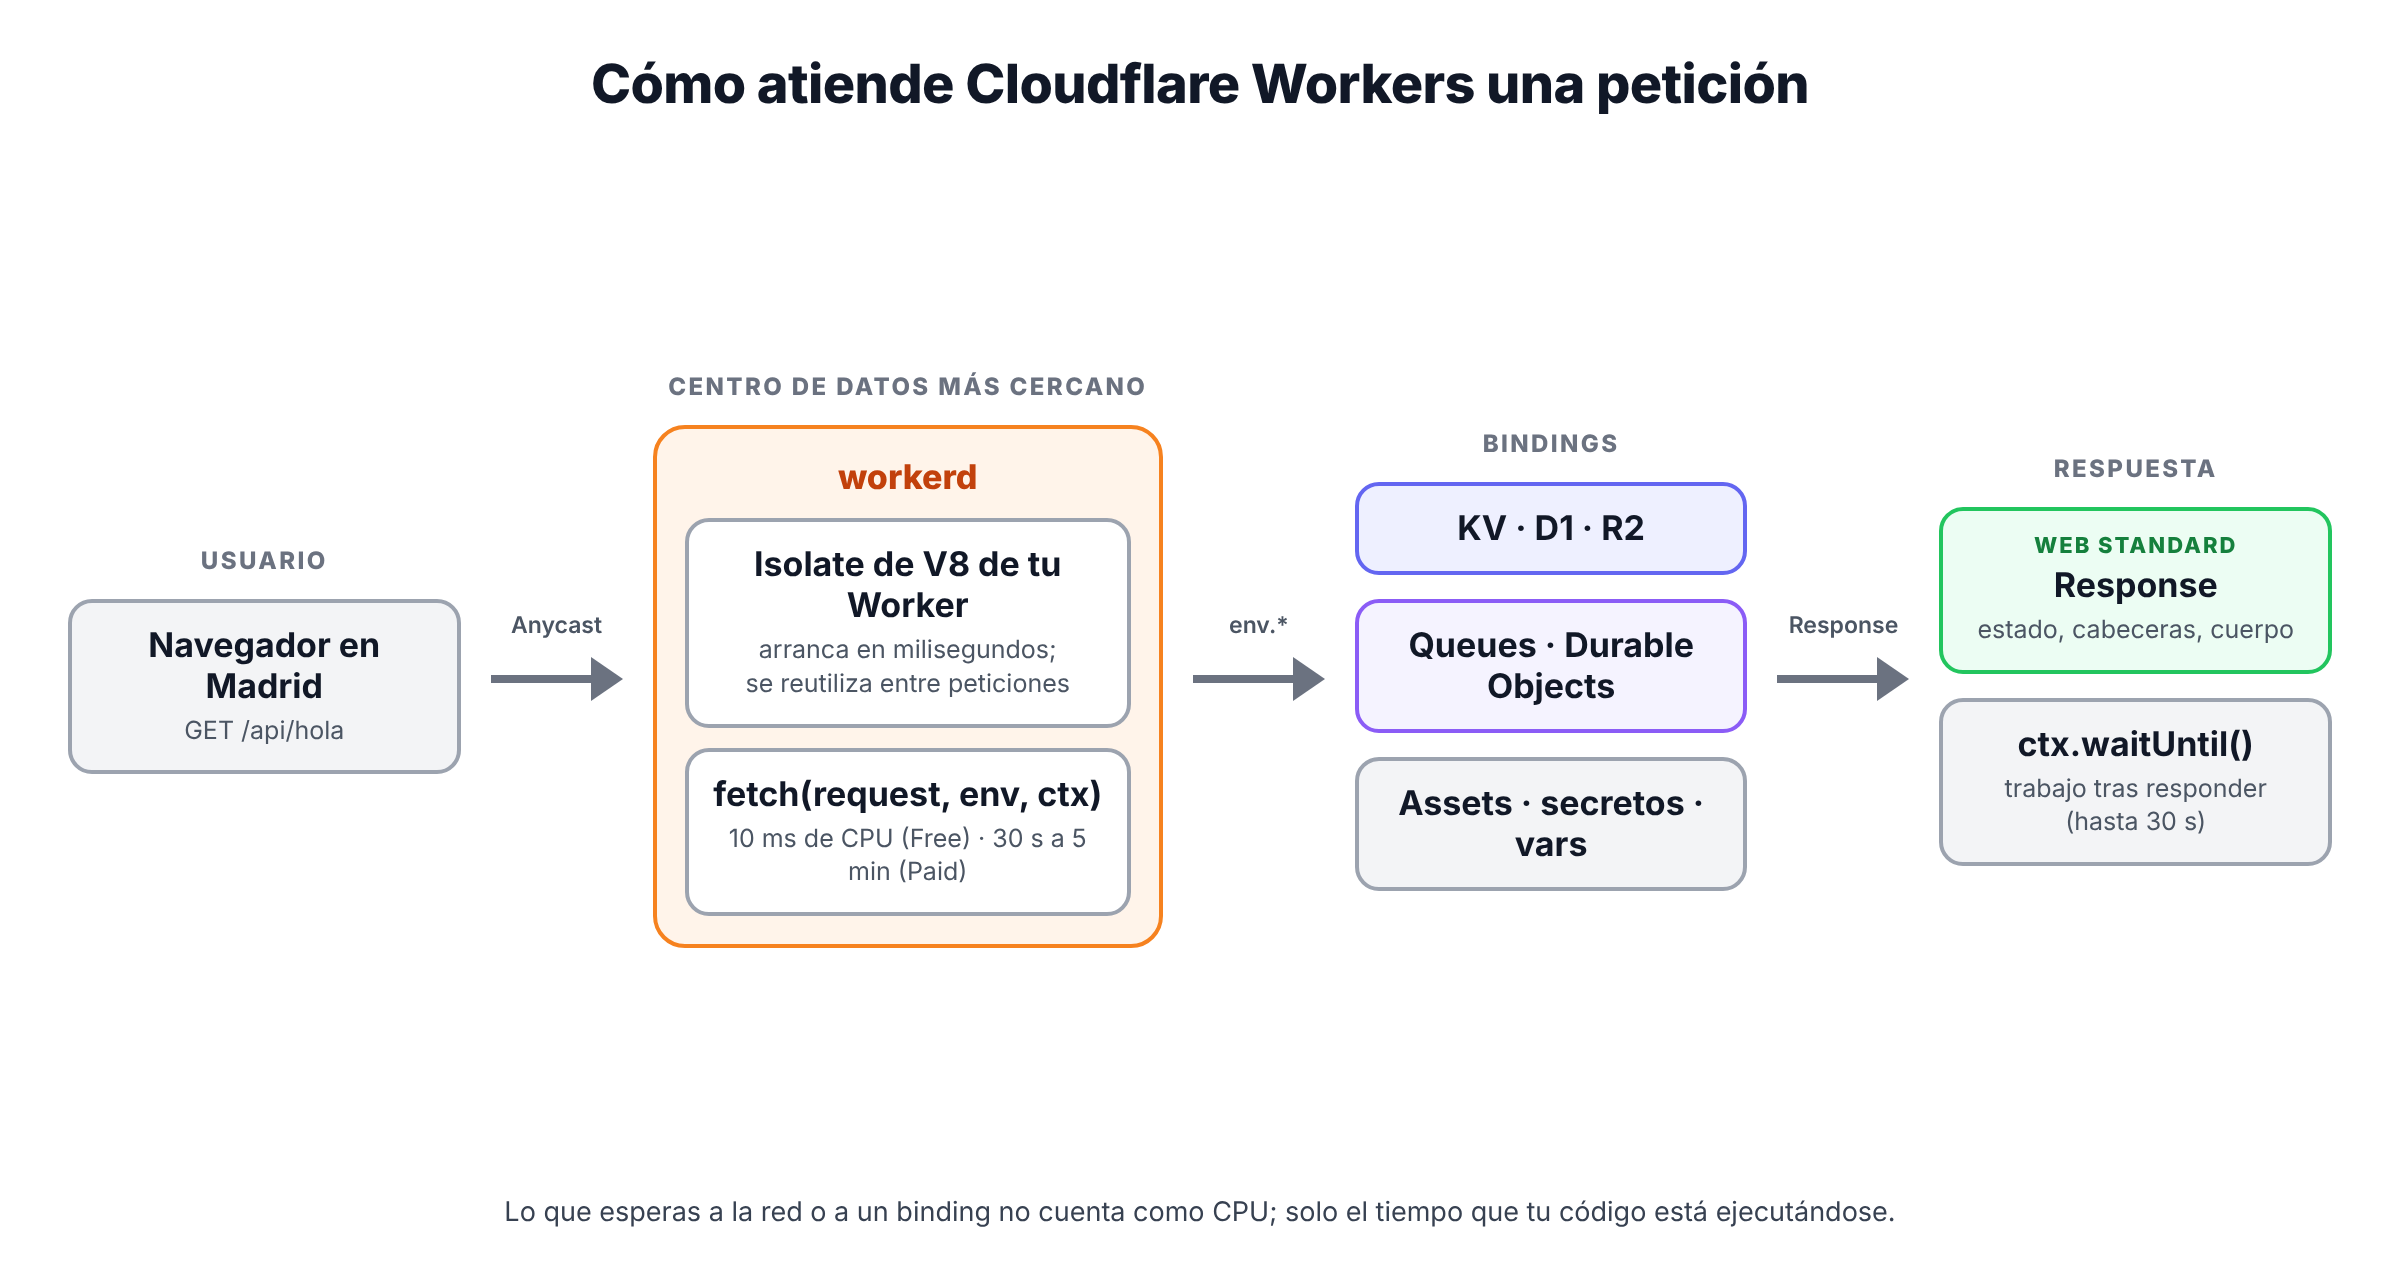
Workers paga ese coste una sola vez por máquina. Cada servidor de Cloudflare ejecuta un proceso del runtime (workerd, que es código abierto) y dentro de él crea un isolate de V8 por Worker. Un isolate es un contexto aislado de memoria: tu código no puede ver la memoria de otro isolate, pero comparten proceso, así que crear uno cuesta muy poco. Según la documentación, un isolate arranca unas cien veces más rápido que un proceso de Node en un contenedor.
Una petición, un evento
Cuando llega una petición a tu dominio (o a tu subdominio *.workers.dev), el centro de datos que la recibe busca tu Worker, reutiliza un isolate si ya hay uno caliente o crea uno nuevo, y llama a fetch(request, env, ctx). Lo que devuelvas es la respuesta.
Un mismo isolate puede atender varias peticiones a la vez en un único hilo con su bucle de eventos, igual que Node. Mientras una petición espera a un fetch, otra puede avanzar.
CPU frente a tiempo de reloj
Esta distinción es la más importante para entender los límites y la factura:
- Tiempo de CPU: lo que tu código pasa calculando de verdad. Es lo que se limita (10 ms en el plan Free; 30 segundos por defecto y hasta 5 minutos en el de pago) y lo que se cobra en el plan de pago.
- Tiempo de reloj (wall time): lo que dura la petición de principio a fin, esperas incluidas. Para peticiones HTTP no hay límite mientras el cliente siga conectado.
Según la propia documentación, un Worker medio usa unos 2,2 ms de CPU por petición. Validar un JWT, renderizar una plantilla o parsear un JSON grande sube a 10-20 ms; esperar 800 ms a una API externa no suma nada.
Estado global: no te fíes
Como un isolate puede atender muchas peticiones y Cloudflare puede crearlo y destruirlo cuando quiera, las variables globales no son un almacenamiento. Sirven como caché en memoria (por ejemplo, para no reconstruir algo caro en cada petición), pero dos peticiones del mismo usuario pueden caer en isolates distintos, en centros de datos distintos. Para estado de verdad tienes KV, D1, R2 y, sobre todo, Durable Objects.
Descarga e instalación
No hay nada que instalar en el sistema más allá de Node.js: todo se hace con Wrangler, la CLI oficial, que se instala como dependencia de desarrollo de cada proyecto.
| Recurso | Enlace |
|---|---|
| Documentación | developers.cloudflare.com/workers |
| Wrangler | npmjs.com/package/wrangler · comandos |
| Runtime (workerd) | github.com/cloudflare/workerd |
| Wrangler, C3, Miniflare y Vitest | github.com/cloudflare/workers-sdk |
| Límites y precios | límites · precios |
Crear un proyecto con C3
La forma recomendada es C3 (create-cloudflare), que genera el proyecto con TypeScript, Vitest y la configuración ya preparada:
# Interactivo: te pregunta plantilla, lenguaje, git y si quieres desplegar
npm create cloudflare@latest mi-worker

# Sin preguntas: "hola mundo" en TypeScript, sin git y sin desplegar
npm create cloudflare@latest mi-worker -- --type=hello-world --lang=ts --no-git --no-deploy

cd mi-worker
npm run dev # wrangler dev -> http://localhost:8787create-cloudflare 2.73 se niega a arrancar con "create-cloudflare requires at least Node.js v22.0.0". Lo descubrí en la primera línea de este artículo; instalé Node 24 LTS y listo.Las plantillas que ofrece --type incluyen hello-world, hello-world-with-assets (API + ficheros estáticos), hello-world-assets-only, hello-world-durable-object, hello-world-workflows, scheduled (cron), queues y openapi, además de plantillas para frameworks (--framework=react, astro, next, hono...).
Lo que genera la plantilla hello-world es esto:
{
  "name": "hola-worker",
  "scripts": {
    "deploy": "wrangler deploy",
    "dev": "wrangler dev",
    "start": "wrangler dev",
    "test": "vitest",
    "cf-typegen": "wrangler types"
  },
  "devDependencies": {
    "@cloudflare/vitest-plugin": "^1.0.0",
    "@types/node": "^26.6.4",
    "typescript": "^5.5.2",
    "vitest": "~4.1.0",
    "wrangler": "^4.147.0"
  }
}
Añadir Wrangler a un proyecto existente
npm install -D wrangler
npx wrangler --version     # 4.147.0
npx wrangler login         # abre el navegador para autorizar tu cuenta (solo para desplegar)
Para desarrollar en local y pasar las pruebas no necesitas cuenta ni wrangler login: todo lo que verás en este artículo funciona en tu máquina gracias a Miniflare, que ejecuta el mismo runtime workerd que producción.
La configuración: wrangler.jsonc
Cada Worker tiene un fichero de configuración. Wrangler acepta TOML (wrangler.toml) y JSON con comentarios (wrangler.jsonc); Cloudflare recomienda wrangler.jsonc para proyectos nuevos y avisa de que algunas funciones nuevas solo estarán disponibles con JSON. Es lo que uso en toda la serie.
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "hola-worker",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "observability": { "enabled": true },
  "upload_source_maps": true
}name: el nombre del Worker en tu cuenta (y del subdominionombre.tu-cuenta.workers.dev).main: el punto de entrada. Wrangler lo empaqueta con esbuild; no necesitas configurar ningún bundler.compatibility_date: la fecha cuyo comportamiento del runtime quieres. Cloudflare nunca rompe un Worker existente: los cambios incompatibles se activan solo para fechas posteriores. Pon la de hoy al crear el proyecto y súbela a conciencia.compatibility_flags: activa comportamientos sueltos. El más común esnodejs_compat, que habilita módulos de Node (node:buffer,node:crypto,node:stream,process.env...).observability: activa Workers Logs, los registros persistentes que ves en el panel.
El $schema no es decorativo: con él, VS Code te autocompleta y valida cada opción.
Un Worker de verdad
Vamos con un ejemplo que toca casi todo lo que usarás a diario: rutas, variables, un secreto, la información de request.cf, la Cache API con waitUntil, una tarea programada que escribe en KV y ficheros estáticos. Esta es la configuración completa:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "workers-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "compatibility_flags": ["nodejs_compat"],
  "observability": { "enabled": true },

  // Variables de texto (no secretas): visibles en el panel y en el código
  "vars": { "SALUDO": "Hola desde el borde", "ENTORNO": "desarrollo" },

  // Un KV para guardar la última ejecución del cron
  "kv_namespaces": [{ "binding": "ESTADO", "id": "00000000000000000000000000000000" }],

  // Ficheros estáticos: se sirven sin ejecutar el Worker (y sin cobrar)
  "assets": {
    "directory": "./public",
    "binding": "ASSETS",
    "not_found_handling": "single-page-application",
    "run_worker_first": ["/api/*"]
  },

  // Cron: cada 15 minutos (hora UTC)
  "triggers": { "crons": ["*/15 * * * *"] }
}
Los secretos nunca van en wrangler.jsonc. En local se leen de un fichero .dev.vars (que debe estar en .gitignore) y en producción se suben con wrangler secret put:
# .dev.vars (solo en tu máquina)
API_TOKEN="token-de-desarrollo-123"

# En producción (necesita cuenta): te pide el valor por la terminal
npx wrangler secret put API_TOKEN
Y el código:
// Un Worker en módulos ES: un objeto con un manejador por tipo de evento
export default {
  async fetch(request, env, ctx): Promise<Response> {
    const url = new URL(request.url);

    // GET /api/hola?nombre=Luis
    if (url.pathname === "/api/hola") {
      const nombre = url.searchParams.get("nombre") ?? "mundo";
      return Response.json({ mensaje: `${env.SALUDO}, ${nombre}`, entorno: env.ENTORNO });
    }

    // GET /api/cf: lo que Cloudflare sabe de la petición (país, colo, protocolo...)
    if (url.pathname === "/api/cf") {
      const cf = request.cf;
      return Response.json({ pais: cf?.country, ciudad: cf?.city, colo: cf?.colo, http: cf?.httpProtocol });
    }

    // GET /api/privado: un secreto que llega por env, nunca en el código
    if (url.pathname === "/api/privado") {
      const auth = request.headers.get("Authorization");
      if (auth !== `Bearer ${env.API_TOKEN}`) {
        return Response.json({ error: "No autorizado" }, { status: 401 });
      }
      return Response.json({ ok: true });
    }

    // GET /api/caro: algo costoso que guardamos en la Cache API del centro de datos
    if (url.pathname === "/api/caro") {
      const cache = caches.default;
      const clave = new Request(url.toString(), request);
      const enCache = await cache.match(clave);
      if (enCache) return enCache;

      const resultado = { calculadoEn: new Date().toISOString(), primos: primosHasta(50_000).length };
      const respuesta = Response.json(resultado, {
        headers: { "Cache-Control": "public, max-age=60", "X-Generado": "worker" },
      });
      // Guardar en caché sin retrasar la respuesta al cliente
      ctx.waitUntil(cache.put(clave, respuesta.clone()));
      return respuesta;
    }

    // GET /api/estado: lo que dejó escrito el último cron
    if (url.pathname === "/api/estado") {
      const ultima = await env.ESTADO.get("ultima-ejecucion");
      return Response.json({ ultimaEjecucion: ultima });
    }

    if (url.pathname.startsWith("/api/")) {
      return Response.json({ error: "No existe" }, { status: 404 });
    }

    // Todo lo demás: a los ficheros estáticos
    return env.ASSETS.fetch(request);
  },

  // Se ejecuta según "triggers.crons"
  async scheduled(controller, env, ctx): Promise<void> {
    const cuando = new Date(controller.scheduledTime).toISOString();
    await env.ESTADO.put("ultima-ejecucion", `${cuando} (${controller.cron})`);
    console.log(`Cron ${controller.cron} ejecutado a las ${cuando}`);
  },
} satisfies ExportedHandler<Env>;

function primosHasta(n: number): number[] {
  const criba = new Uint8Array(n + 1);
  const primos: number[] = [];
  for (let i = 2; i <= n; i++) {
    if (!criba[i]) {
      primos.push(i);
      for (let j = i * i; j <= n; j += i) criba[j] = 1;
    }
  }
  return primos;
}
Antes de arrancarlo, genera los tipos. wrangler types lee tu configuración y escribe worker-configuration.d.ts con la interfaz Env exacta y los tipos del runtime para tu compatibility_date:
$ npx wrangler types
✨ Types written to worker-configuration.d.ts
// worker-configuration.d.ts (extracto, generado)
interface __BaseEnv_Env {
ESTADO: KVNamespace;
ASSETS: Fetcher;
SALUDO: "Hola desde el borde";
ENTORNO: "desarrollo";
API_TOKEN: string;
}Fíjate en que SALUDO sale tipado con su valor literal y que API_TOKEN aparece aunque no esté en el JSON: Wrangler lo ha leído de .dev.vars. Ahora sí:
$ npx wrangler dev --test-scheduled
Using secrets defined in .dev.vars
Your Worker has access to the following bindings:
Binding                                               Resource                  Mode
env.ESTADO (00000000000000000000000000000000)         KV Namespace              local
env.ASSETS                                            Assets                    local
env.SALUDO ("Hola desde el borde")                    Environment Variable      local
env.ENTORNO ("desarrollo")                            Environment Variable      local
env.API_TOKEN ("(hidden)")                            Environment Variable      local

⎔ Starting local server...
[wrangler:info] Ready on http://localhost:8787
$ curl localhost:8787/
<!doctype html><html lang="es"><meta charset="utf-8"><title>workers-lab</title><h1>Hola desde los assets estáticos</h1></html>
$ curl "localhost:8787/api/hola?nombre=Luis"
{"mensaje":"Hola desde el borde, Luis","entorno":"desarrollo"}
$ curl localhost:8787/api/cf
{"pais":"US","ciudad":"Indianapolis","colo":"ORD","http":"HTTP/1.1"}
$ curl -i localhost:8787/api/privado
HTTP/1.1 401 Unauthorized
$ curl -H "Authorization: Bearer token-de-desarrollo-123" localhost:8787/api/privado
{"ok":true}
$ curl -i localhost:8787/api/caro # primera vez: lo calcula el Worker
HTTP/1.1 200 OK
Cache-Control: public, max-age=60
X-Generado: worker
{"calculadoEn":"2026-10-02T18:01:03.120Z","primos":5133}
$ curl -i localhost:8787/api/caro # segunda vez: sale de la caché
HTTP/1.1 200 OK
Age: 0
CF-Cache-Status: HIT
{"calculadoEn":"2026-10-02T18:01:03.120Z","primos":5133}
$ curl localhost:8787/cualquier/ruta/spa # no existe: devuelve index.html (modo SPA)
<!doctype html><html lang="es">...Dos detalles de esta salida. El primero: en local, request.cf trae datos simulados (Indianápolis, centro de datos ORD); en producción verás los reales del visitante. El segundo: la segunda llamada a /api/caro devuelve la misma marca de tiempo y CF-Cache-Status: HIT, es decir, la Cache API funciona igual en local.
const cf = request.cf ?? {} para no tener que comprobar undefined. TypeScript lo rechaza con "Property 'country' does not exist on type '{}'": el objeto vacío "contamina" el tipo. La solución es dejar request.cf como está y usar encadenamiento opcional (cf?.country).waitUntil: trabajar después de responder
En /api/caro, la respuesta se envía al cliente y después se guarda en caché. Eso lo hace ctx.waitUntil(promesa): el runtime mantiene vivo el Worker hasta que la promesa termina, con un máximo de 30 segundos tras enviar la respuesta. Es perfecto para guardar métricas, escribir en caché o mandar un mensaje a una cola sin hacer esperar al usuario. Si un error ocurre dentro, nadie lo verá salvo en los logs, así que úsalo para trabajo que pueda fallar sin consecuencias.
La Cache API
caches.default es la caché HTTP del centro de datos donde se ejecuta el Worker. No es global: cada centro de datos tiene la suya. cache.match() busca, cache.put() guarda (respetando Cache-Control) y cache.delete() borra. Es la herramienta perfecta para respuestas caras que no cambian en cada petición.
"cache": { "enabled": true } en wrangler.jsonc para que Cloudflare sirva desde caché las respuestas de tu Worker sin ejecutarlo, respetando el Cache-Control que devuelvas. Ojo con el precio: con esta opción, todas las peticiones (incluidas las de estáticos, que normalmente son gratis) se cobran como peticiones de Worker; solo te ahorras la CPU de los aciertos. No lo he probado en local; está explicado en la documentación de Workers Cache.Bindings: cómo habla el Worker con todo lo demás
Un binding es una conexión declarada en la configuración que aparece como propiedad de env. No hay credenciales en el código ni cadenas de conexión: el runtime te inyecta un objeto con métodos.
| Binding | Clave en wrangler.jsonc | En el código | Artículo |
|---|---|---|---|
| Variables de texto | vars | env.SALUDO (string) | este |
| Secretos | wrangler secret put / .dev.vars | env.API_TOKEN (string) | este |
| Workers KV | kv_namespaces | env.X.get(), .put(), .list() | KV |
| R2 | r2_buckets | env.X.get(), .put(), .list() | R2 |
| D1 | d1_databases | env.X.prepare(sql).bind().run() | D1 |
| Durable Objects | durable_objects + migrations | env.X.getByName("id").metodo() | Durable Objects |
| Colas | queues.producers / queues.consumers | env.X.send(msg) | Queues |
| Otro Worker | services | env.X.fetch() o RPC | este |
| Ficheros estáticos | assets | env.ASSETS.fetch(request) | este y Pages |
| Workers AI | ai | env.AI.run(modelo, entrada) | la visión general |
| Hyperdrive | hyperdrive | env.X.connectionString | la visión general |
Dos cosas útiles sobre los bindings:
Aprovisionamiento automático. Si declaras un binding de KV, R2, D1 o Queues sin id (por ejemplo "kv_namespaces": [{ "binding": "CACHE" }]), wrangler dev crea un recurso local y wrangler deploy crea el real y escribe el id en tu configuración. Lo he comprobado con wrangler deploy --dry-run: la configuración sin ids es válida y lista los tres bindings.
Service bindings. Un Worker puede llamar a otro de tu cuenta sin pasar por Internet, ni con fetch ni con métodos RPC (class MiApi extends WorkerEntrypoint). Esas llamadas no se cobran como peticiones nuevas: pagas una petición (la del primer Worker) y la CPU de ambos.
Ficheros estáticos: Workers Static Assets
Desde 2024, un Worker puede servir un sitio estático completo además de su código. Es lo que antes hacía Cloudflare Pages y es, de hecho, lo que Cloudflare recomienda ahora para proyectos nuevos (lo cuento en el artículo de Pages).
"assets": {
  "directory": "./public",
  "binding": "ASSETS",
  "not_found_handling": "single-page-application",
  "run_worker_first": ["/api/*"]
}- Por defecto, si la ruta coincide con un fichero, se sirve el fichero sin ejecutar tu Worker. Esas peticiones son gratis e ilimitadas en ambos planes.
not_found_handling: "single-page-application"devuelveindex.htmlpara rutas que no existen (ideal para React, Vue o Svelte con enrutado en el cliente). La otra opción es"404-page", que busca el404.htmlmás cercano.run_worker_firstinvierte el orden para ciertas rutas: con["/api/*"], todo lo que empiece por/api/va primero al Worker. En el plan Free, cuidado: si te quedas sin peticiones del día, esas rutas devuelven 429 en lugar de servir el estático.- El binding
ASSETSte deja servir un fichero desde código:env.ASSETS.fetch(request).
Los límites: 20.000 ficheros por versión en Free y 100.000 en Paid, con un máximo de 25 MiB por fichero.
Tareas programadas: Cron Triggers
Un Worker puede ejecutarse solo, sin peticiones, con expresiones cron en triggers.crons (en hora UTC). El manejador es scheduled(controller, env, ctx), y controller.cron te dice cuál de tus expresiones lo ha disparado, por si tienes varias.
En local, wrangler dev --test-scheduled expone un endpoint para dispararlo a mano:
$ curl "localhost:8787/cdn-cgi/handler/scheduled?cron=*/15+*+*+*+*"
ok
$ curl localhost:8787/api/estado
{"ultimaEjecucion":"2026-10-02T18:01:04.200Z (*/15 * * * *)"}/__scheduled no llega a tu Worker. La ayuda de Wrangler sigue diciendo que visites /__scheduled, pero en mi Worker con assets y modo SPA esa ruta devolvía el index.html: los estáticos se sirven antes que el Worker y /__scheduled no está en run_worker_first. La ruta /cdn-cgi/handler/scheduled sí funciona siempre.Límites del cron: 5 por cuenta en Free y 250 en Paid. En Free cada ejecución tiene 10 ms de CPU; en Paid, 30 segundos si el intervalo es menor de una hora y 15 minutos si es de una hora o más, con un máximo de 15 minutos de reloj por ejecución.
Desarrollo local
wrangler dev arranca tu Worker en workerd en tu máquina, con recarga automática al guardar. Por defecto todos los bindings son simulaciones locales que se guardan en .wrangler/state/v3/ (hay carpetas kv, r2, d1, cache...) y persisten entre arranques. Puedes leer y escribir esos datos locales con la CLI añadiendo --local:
npx wrangler kv key put "config:modo" "mantenimiento" --binding ESTADO --local
npx wrangler d1 execute mi-db --local --command "SELECT count(*) FROM usuarios"
npx wrangler r2 object get mi-bucket/foto.jpg --local --file foto.jpg
Cuando quieras probar contra datos reales sin desplegar, marca un binding concreto con "remote": true: tu código sigue ejecutándose en local, pero ese binding habla con el recurso de verdad. Útil para depurar con datos de staging; peligroso con los de producción (usa entornos separados). Workers AI siempre es remoto, y los Durable Objects siempre son locales.
Pruebas con Vitest
La integración oficial ejecuta tus tests dentro del runtime de Workers, con bindings reales (simulados por Miniflare) y almacenamiento aislado por fichero de test. La plantilla de C3 ya la trae configurada:
import { cloudflareTest } from "@cloudflare/vitest-plugin";
import { defineConfig } from "vitest/config";

export default defineConfig({
	plugins: [
		cloudflareTest({
			wrangler: { configPath: "./wrangler.jsonc" },
		}),
	],
});@cloudflare/vitest-pool-workers, defineWorkersConfig y SELF.fetch(). Eso es la integración antigua. La actual es @cloudflare/vitest-plugin (necesita Vitest 4.1 o superior), se configura con el plugin cloudflareTest() y las pruebas de integración usan exports.default.fetch() importado de cloudflare:workers. Hay una guía de migración.Las pruebas del Worker anterior, incluida la del cron:
import { env, exports } from "cloudflare:workers";
import { createExecutionContext, createScheduledController, waitOnExecutionContext } from "cloudflare:test";
import { describe, it, expect } from "vitest";
import worker from "../src/index";

describe("workers-lab", () => {
  it("saluda con la variable de wrangler.jsonc", async () => {
    const res = await exports.default.fetch("https://ejemplo.com/api/hola?nombre=Luis");
    expect(await res.json()).toEqual({ mensaje: "Hola desde el borde, Luis", entorno: "desarrollo" });
  });

  it("rechaza /api/privado sin token", async () => {
    const res = await exports.default.fetch("https://ejemplo.com/api/privado");
    expect(res.status).toBe(401);
  });

  it("acepta el token de .dev.vars", async () => {
    const res = await exports.default.fetch("https://ejemplo.com/api/privado", {
      headers: { Authorization: "Bearer token-de-desarrollo-123" },
    });
    expect(res.status).toBe(200);
  });

  it("el cron deja su marca en KV", async () => {
    const controller = createScheduledController({ scheduledTime: new Date("2026-10-02T08:15:00Z"), cron: "*/15 * * * *" });
    const ctx = createExecutionContext();
    await worker.scheduled(controller, env, ctx);
    await waitOnExecutionContext(ctx);
    expect(await env.ESTADO.get("ultima-ejecucion")).toBe("2026-10-02T08:15:00.000Z (*/15 * * * *)");
  });
});
$ npx vitest run
RUN v4.1.11 /home/yo/workers-lab
Using secrets defined in .dev.vars
Test Files 1 passed (1)
Tests 4 passed (4)
Duration 1.11s (transform 28ms, setup 0ms, import 44ms, tests 22ms, environment 0ms)env(decloudflare:workers) te da los bindings de verdad: puedes sembrar datos en KV o D1 antes del test y comprobar lo que quedó después.exports.default.fetch()llama a tu Worker como si fuera una petición real.createScheduledController(),createExecutionContext()ywaitOnExecutionContext()sirven para probar manejadores que no son HTTP y para esperar a todo lo que hayas mandado awaitUntil.
Para que TypeScript conozca cloudflare:test, la carpeta test/ lleva su propio tsconfig.json con "types": ["@cloudflare/vitest-plugin/types"]; C3 ya lo deja hecho.
Desplegar
Esta parte necesita cuenta, así que aquí no hay salidas reales mías salvo la de la prueba en seco:
npx wrangler login                    # una vez por máquina
npx wrangler deploy                   # empaqueta, sube y publica al 100 %

# Comprobar qué se va a subir, sin subir nada (este sí lo he ejecutado)
$ npx wrangler deploy --dry-run --outdir dist
✨ Read 1 file from the assets directory /home/yo/workers-lab/public
Total Upload: 2.41 KiB / gzip: 1.06 KiB
Your Worker has access to the following bindings:
Binding                                             Resource
env.ESTADO (00000000000000000000000000000000)       KV Namespace
env.ASSETS                                          Assets
env.SALUDO ("Hola desde el borde")                  Environment Variable
env.ENTORNO ("desarrollo")                          Environment Variable
--dry-run: exiting now.
El límite de tamaño es de 64 MiB sin comprimir en ambos planes (el valor Total Upload, no el comprimido), y el código global debe ejecutarse en menos de 1 segundo al arrancar; si no, el despliegue falla con el error 10021 y wrangler check startup te genera un perfil de CPU para ver qué tarda.
Versiones, despliegues graduales y vuelta atrás
Cada wrangler deploy crea una versión y la publica al 100 %. Si quieres más control, separa los dos pasos:
npx wrangler versions upload                         # sube una versión nueva sin publicarla
npx wrangler versions deploy <nueva>@10% <actual>@90%  # el 10 % del tráfico a la nueva
npx wrangler versions deploy <nueva>@100%            # cuando estés tranquilo
npx wrangler rollback                                # volver a la versión anterior
npx wrangler tail                                    # ver los logs en directo
Dónde se publica
- En
https://<nombre>.<tu-subdominio>.workers.dev, por defecto. - En un dominio propio (
custom_domain: trueenroutes), si el dominio está en Cloudflare. Cloudflare crea el DNS y el certificado. - En rutas (
routes: [{ "pattern": "midominio.com/api/*", "zone_name": "midominio.com" }]), cuando el Worker debe ejecutarse solo en parte de un sitio que ya existe.
Límites que conviene conocer
| Límite | Workers Free | Workers Paid |
|---|---|---|
| Peticiones | 100.000 al día | Sin límite (10 M/mes incluidas) |
| CPU por petición | 10 ms | 30 s por defecto, hasta 5 min |
| Memoria por isolate | 128 MB | 128 MB |
| Subpeticiones por invocación | 50 | 10.000 (configurable hasta 10 M) |
| Conexiones esperando cabeceras a la vez | 6 | 6 |
| Variables y secretos por Worker | 64 | 128 |
| Tamaño del Worker (sin comprimir) | 64 MiB | 64 MiB |
| Arranque del código global | 1 s | 1 s |
| Workers por cuenta | 100 | 500 |
| Cron Triggers por cuenta | 5 | 250 |
| Tamaño del cuerpo de la petición | Según el plan de la zona: 100 MB en Free y Pro, 200 MB en Business | Igual |
Cuando un Worker supera la CPU o la memoria, el cliente recibe el error 1102 (Worker exceeded resource limits). Si en el plan Free se acaban las 100.000 peticiones diarias, verás el error 1027, salvo que la ruta esté en modo fail open, en cuyo caso la petición pasa como si no hubiera Worker. Los contadores diarios se reinician a medianoche UTC (las 02:00 en España en verano).
Lo que cuesta
En dos líneas: el plan Free cuesta 0 € y da 100.000 peticiones al día con 10 ms de CPU cada una; el plan Paid cuesta 5 dólares al mes e incluye 10 millones de peticiones y 30 millones de milisegundos de CPU al mes, y después cobra 0,30 dólares por millón de peticiones y 0,02 dólares por millón de milisegundos de CPU. Las peticiones a estáticos son gratis siempre y no se cobra el tráfico de salida. Todo el detalle, con ejemplos de facturas, está en el artículo de los planes.
Errores comunes (y cómo evitarlos)
- Guardar estado en variables globales. Funciona en tu máquina y falla en producción en cuanto llegan peticiones a isolates distintos. Usa KV, D1 o Durable Objects.
- Hacer trabajo pesado en el ámbito global. Leer un esquema enorme o construir un objeto gigante fuera del manejador cuenta para el límite de arranque de 1 segundo.
- Olvidar
awaitowaitUntil. Una promesa que no esperas ni pasas actx.waitUntil()puede cortarse en cuanto respondes. - Leer el cuerpo de una respuesta dos veces. Si vas a guardar una respuesta en caché y devolverla, usa
respuesta.clone(), como en el ejemplo. - Secretos en
vars. Todo lo que está envarsaparece en el panel y en el repositorio. Los secretos van en.dev.varsy enwrangler secret put. - Confiar en
/__scheduledcon assets. Usa/cdn-cgi/handler/scheduled. - No subir la
compatibility_date. No rompe nada, pero te quedas sin mejoras y correcciones del runtime. Revísala de vez en cuando y prueba. - Usar
process.envsinnodejs_compat. En Workers la forma natural esenv. Si necesitasprocess.envo módulos de Node, activa el flag. - No limitar la CPU en el plan de pago. Por defecto una petición puede consumir hasta 30 segundos de CPU. Si tu Worker nunca debería pasar de 50 ms, ponlo en
limits.cpu_msy evitarás sustos en la factura.
Cuándo usar Workers (y cuándo no)
Workers encaja muy bien en APIs y backends de aplicaciones web, middleware delante de otro servidor (autenticación, redirecciones, A/B testing, cabeceras), sitios estáticos o renderizados en servidor con frameworks modernos, webhooks, tareas programadas pequeñas, y cualquier cosa que deba responder rápido desde cualquier parte del mundo. Combinado con D1, R2, KV y Durable Objects puedes construir una aplicación completa sin un solo servidor.
Piénsatelo dos veces si necesitas procesos de larga duración con mucho cálculo continuo, binarios nativos o librerías que dependen del sistema de ficheros, o mucha memoria (el límite es 128 MB por isolate). Para eso Cloudflare tiene ahora Containers, o puedes seguir con tu servidor de siempre, por ejemplo con Coolify. Y si tu base de datos está en una sola región lejana, cada consulta cruzará medio mundo: mira Smart Placement ("placement": { "mode": "smart" }) o Hyperdrive.
Si escribes APIs con TypeScript, mi recomendación es usar Hono encima de Workers: nació precisamente aquí, y te da rutas, validación y middleware sin perder nada de lo que has visto en este artículo (c.env son los mismos bindings).
Sigue leyendo
Este artículo forma parte de la serie sobre la plataforma de desarrollo de Cloudflare:
- Cloudflare a fondo: la visión general, con todos los servicios y cuándo usar cada uno.
- Cloudflare R2 a fondo: almacenamiento de objetos compatible con S3 y sin coste de salida.
- Cloudflare D1 a fondo: SQLite gestionado, migraciones y réplicas de lectura.
- Workers KV a fondo: el almacén clave-valor global para lecturas rápidas.
- Durable Objects a fondo: estado coordinado, WebSockets y alarmas.
- Cloudflare Queues a fondo: trabajo en segundo plano con reintentos y cola de fallidos.
- Cloudflare Pages a fondo: sitios estáticos y funciones, y cuándo pasarse a Workers.
- Planes de Cloudflare Workers: Free frente a Paid: qué incluye cada uno y cuánto pagarás de verdad.
- Cloudflare Workflows a fondo: procesos largos por pasos sobre Workers.
- Cloudflare WAF y protección DDoS a fondo: incluye el binding de rate limiting para tu Worker.
- Cloudflare CDN y caché a fondo: la caché delante de tu Worker y la Cache API.
- Cloudflare Browser Run a fondo: un Chrome controlado desde tu Worker.
- Cloudflare Workers AI a fondo: modelos de IA con un binding.
- Cloudflare Containers a fondo: para lo que no cabe en un Worker.