Cloudflare D1 a fondo: SQLite serverless con migraciones, réplicas de lectura y código probado
Qué es D1 y cómo funciona por dentro, el precio por filas leídas y escritas, migraciones con Wrangler, consultas preparadas, batch como transacción, índices con EXPLAIN, réplicas con la API de sesiones, Time Travel, tests y límites, con código probado.
Contenido
Casi todas las aplicaciones acaban necesitando una base de datos relacional. En el mundo serverless eso siempre ha sido incómodo: o pagas una base de datos gestionada que está encendida aunque nadie la use, o te peleas con pools de conexiones desde funciones que se crean y destruyen a cada momento.
D1 es la base de datos SQL de Cloudflare: SQLite gestionado, accesible desde un Worker con un binding, sin conexiones que abrir, sin servidor que dimensionar y sin pagar por tenerla parada. Se cobra por filas leídas y escritas y por el almacenamiento, y la capa gratuita es generosa: 5 millones de filas leídas al día.
En este artículo vamos a construir una API de artículos con etiquetas sobre D1, con migraciones, índices comprobados con EXPLAIN, transacciones con batch(), la API de sesiones para réplicas de lectura y tests que aplican las migraciones solos, todo ejecutado en local.
Qué es D1 y cómo funciona por dentro
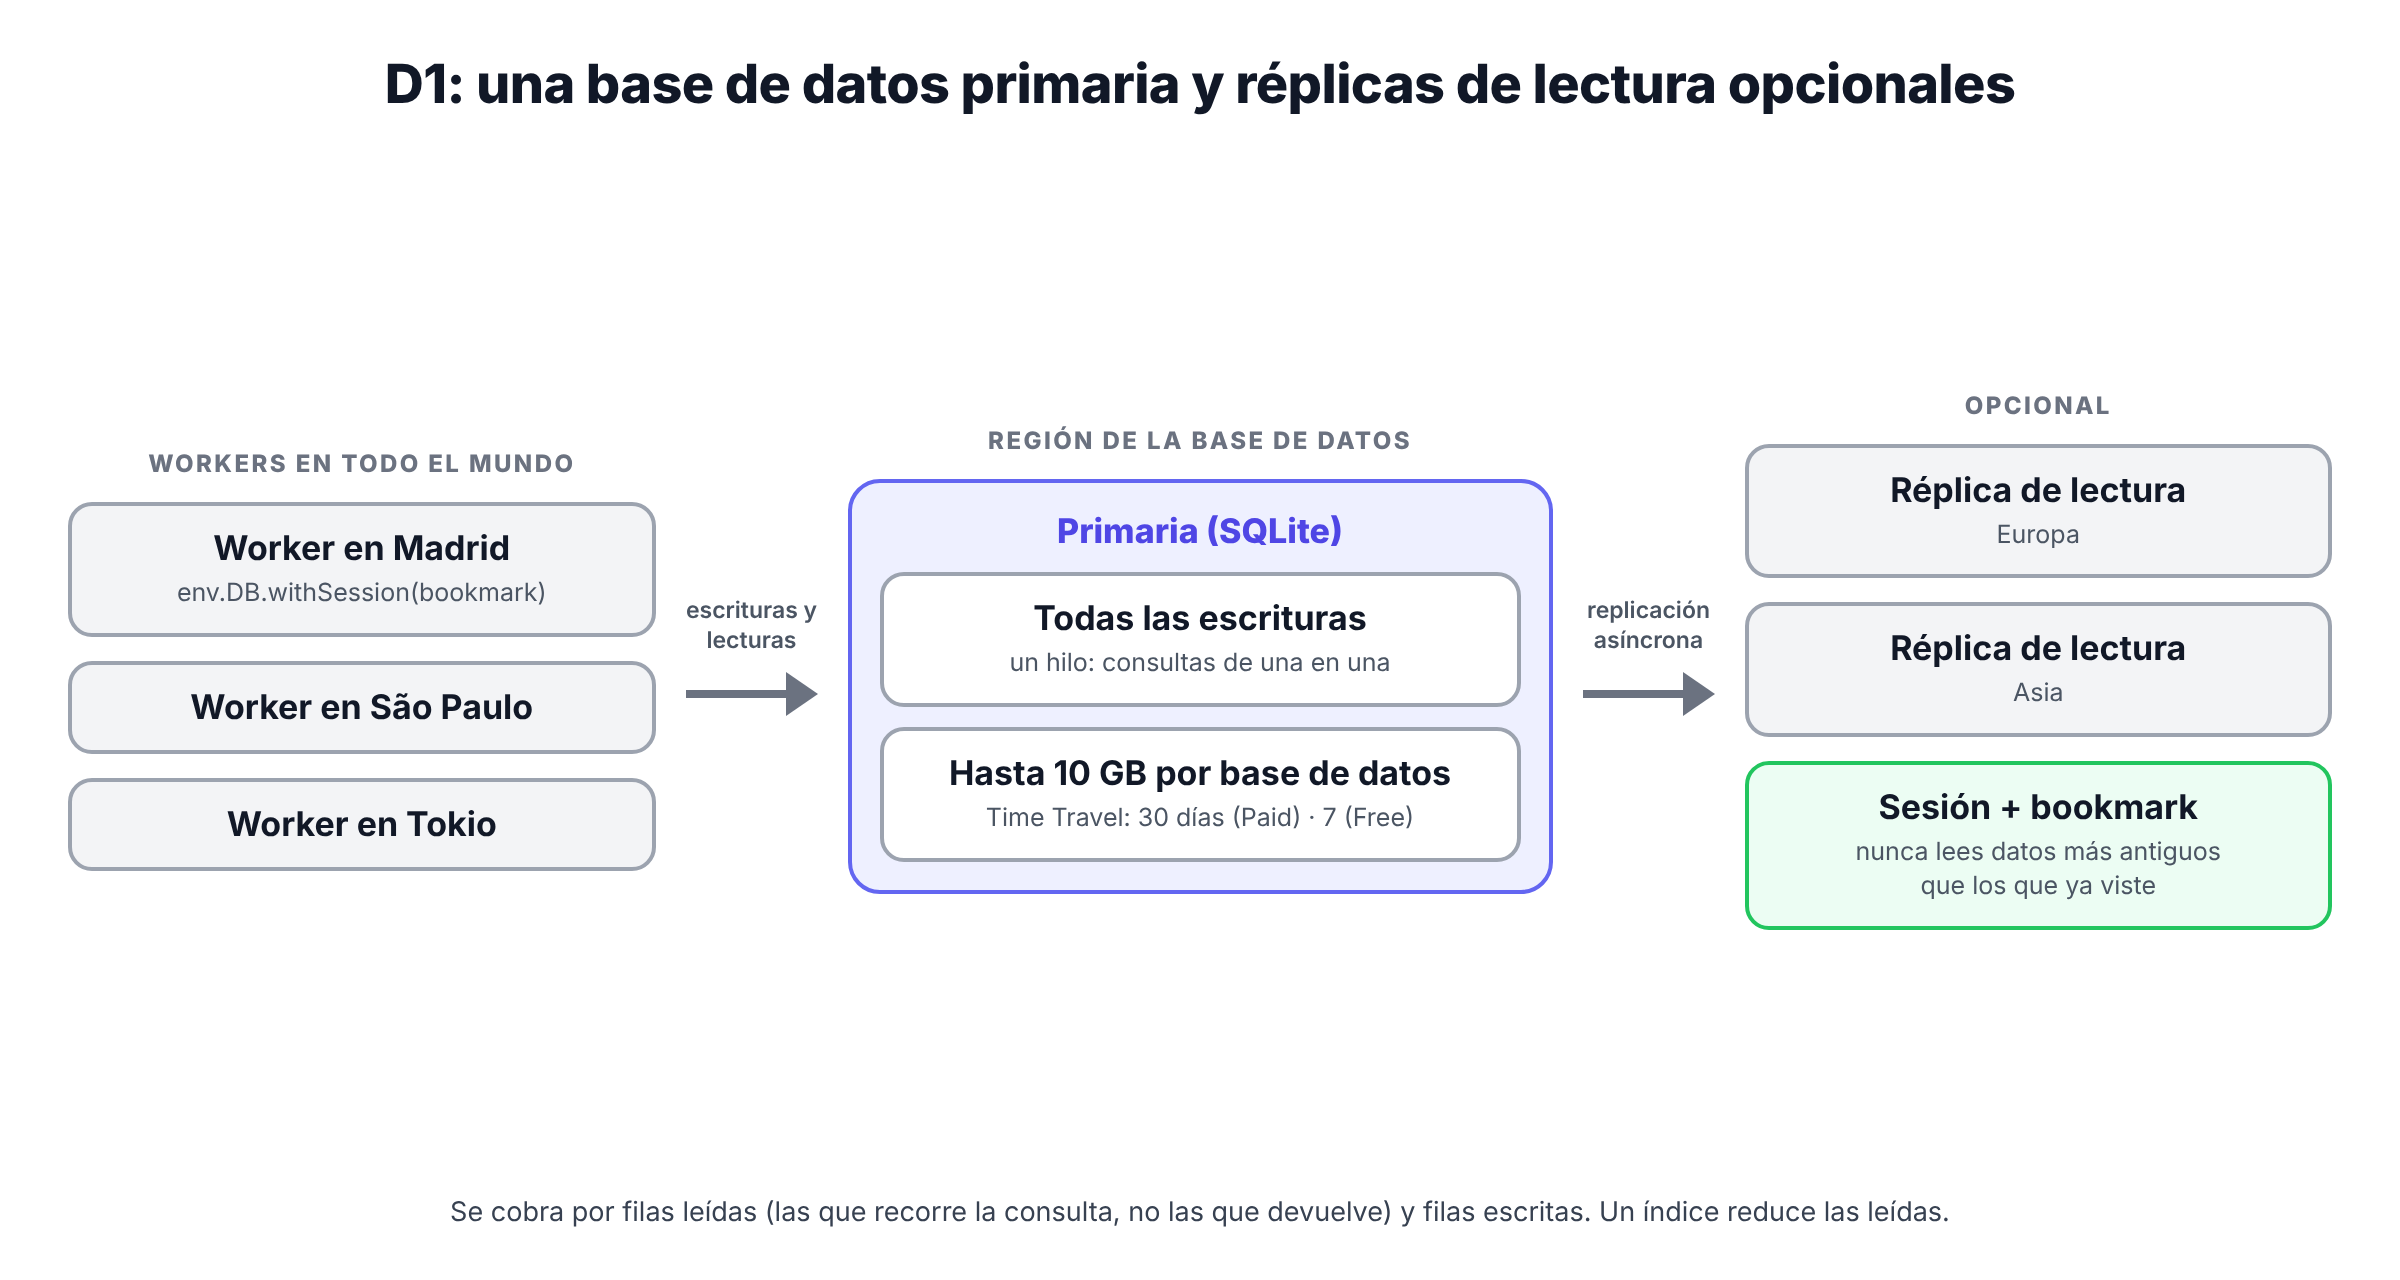
Una base de datos D1 es una base de datos SQLite que vive en un servidor de Cloudflare, en una ubicación concreta (la más cercana a quien la crea, o la que pidas con --location). Tu Worker se conecta a ella a través de un binding y le envía consultas SQL; D1 las ejecuta y devuelve las filas.
Dos consecuencias directas de que sea SQLite:
- Es SQL de verdad:
JOIN, índices,RETURNING, claves foráneas, JSON, búsqueda de texto completo con FTS5... Lo que sabes de SQLite vale aquí. - Cada base de datos ejecuta las consultas de una en una. Un solo hilo. Con consultas de 1 ms puede atender unas mil por segundo; con consultas de 100 ms, diez. El rendimiento depende mucho más de lo eficientes que sean tus consultas que de cualquier configuración.
Y una consecuencia de su diseño: una base de datos tiene un máximo de 10 GB (500 MB en el plan gratuito) y ese límite no se puede ampliar. D1 está pensado para escalar horizontalmente: muchas bases de datos pequeñas (una por cliente, por usuario o por tenant) en lugar de una gigante. En el plan de pago puedes tener 50.000.
Réplicas de lectura
Por defecto, todas las consultas viajan hasta la región de la base de datos. Si tus usuarios están repartidos por el mundo, puedes activar la replicación de lectura: D1 mantiene copias de solo lectura en otras regiones y envía las lecturas a la más cercana. Como una réplica puede ir ligeramente por detrás de la primaria, para usarla hay que pasar por la API de sesiones, que garantiza que dentro de una sesión siempre lees al menos lo que ya has escrito (consistencia secuencial). Lo veremos con código más abajo.
Lo que cuesta
D1 cobra por filas leídas, filas escritas y almacenamiento. No se cobra por consulta ni por tiempo de ejecución, y no hay coste de transferencia.
| Workers Free | Workers Paid | |
|---|---|---|
| Filas leídas | 5 millones al día | 25.000 millones al mes incluidas, luego 0,001 $ por millón |
| Filas escritas | 100.000 al día | 50 millones al mes incluidas, luego 1,00 $ por millón |
| Almacenamiento | 5 GB en total | 5 GB incluidos, luego 0,75 $ por GB-mes |
Los límites diarios del plan gratuito se reinician a las 00:00 UTC (las 02:00 en la España peninsular en horario de verano). Si los superas, las consultas devuelven error hasta el reinicio.
Lo importante es entender qué es una "fila leída": las filas que la consulta recorre, no las que devuelve. Un SELECT * FROM articulos WHERE autor = 'luis' sin índice en autor recorre la tabla entera: si tiene 100.000 filas, son 100.000 filas leídas aunque devuelva tres. Con un índice serían tres (más las del índice). Los índices tienen un coste en el otro lado: cada escritura que toca una columna indexada cuenta una fila escrita más.
meta de cualquier consulta trae rows_read y rows_written. Devuélvelos en desarrollo o regístralos en los logs y verás enseguida qué consulta necesita un índice.Crear la base de datos
# Con cuenta: crea la base de datos y añade el binding a wrangler.jsonc
npx wrangler d1 create blog-db --location weur

# Crear una migración (genera migrations/0001_crear_tablas.sql vacío)
npx wrangler d1 migrations create blog-db crear_tablas
La configuración del binding:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "d1-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "d1_databases": [
    {
      "binding": "DB",
      "database_name": "blog-db",
      "database_id": "00000000-0000-0000-0000-000000000000",
      "migrations_dir": "migrations"
    }
  ]
}
El database_id lo devuelve wrangler d1 create. Para trabajar solo en local, cualquier UUID sirve: aquí uso ceros. Como en el resto de bindings, puedes omitir el id y Wrangler creará la base de datos en el primer deploy.
Migraciones
Las migraciones son ficheros SQL numerados en migrations/. Wrangler registra en una tabla interna (d1_migrations) cuáles se han aplicado, así que solo aplica las nuevas. Las de este proyecto:
-- Migration number: 0001 	 Artículos y etiquetas
CREATE TABLE articulos (
  id         INTEGER PRIMARY KEY AUTOINCREMENT,
  slug       TEXT NOT NULL UNIQUE,
  titulo     TEXT NOT NULL,
  cuerpo     TEXT NOT NULL DEFAULT '',
  visitas    INTEGER NOT NULL DEFAULT 0,
  creado_en  TEXT NOT NULL DEFAULT (datetime('now'))
);

CREATE TABLE etiquetas (
  articulo_id INTEGER NOT NULL REFERENCES articulos(id) ON DELETE CASCADE,
  etiqueta    TEXT NOT NULL,
  PRIMARY KEY (articulo_id, etiqueta)
);
-- Migration number: 0002 Buscar artículos por etiqueta sin recorrer la tabla entera
CREATE INDEX idx_etiquetas_etiqueta ON etiquetas (etiqueta);Se aplican con migrations apply, en local con --local y en producción con --remote:
$ npx wrangler d1 migrations apply blog-db --local
Migrations to be applied:
┌──────────────────────────────┐
│ name                         │
├──────────────────────────────┤
│ 0001_crear_tablas.sql        │
├──────────────────────────────┤
│ 0002_indice_por_etiqueta.sql │
└──────────────────────────────┘
? About to apply 2 migration(s)
Your database may not be available to serve requests during the migration, continue?
🤖 Using fallback value in non-interactive context: yes
🌀 Executing on local database blog-db (00000000-0000-0000-0000-000000000000) from .wrangler/state/v3/d1:
🚣 3 commands executed successfully.
...
┌──────────────────────────────┬────────┐
│ name                         │ status │
├──────────────────────────────┼────────┤
│ 0001_crear_tablas.sql        │ ✅     │
├──────────────────────────────┼────────┤
│ 0002_indice_por_etiqueta.sql │ ✅     │
└──────────────────────────────┴────────┘

$ npx wrangler d1 execute blog-db --local --file seed.sql
🚣 2 commands executed successfully.
Si una migración falla, se deshace y las anteriores siguen aplicadas. Fíjate también en el aviso: durante una migración la base de datos puede no atender peticiones, así que en producción conviene que las migraciones sean pequeñas.
wrangler d1 execute sin --local ni --remote usa la local. Es lo correcto, pero acostúmbrate a escribir siempre el que quieres. Un DROP TABLE lanzado con --remote por error no tiene "deshacer"... salvo Time Travel, que veremos al final.La API del binding
El binding env.DB es un D1Database. Lo normal es preparar una sentencia, enlazar los parámetros y ejecutarla:
| Método | Devuelve | Úsalo para |
|---|---|---|
prepare(sql).bind(...).run() | { results, success, meta } | Cualquier consulta; results trae las filas |
.first() / .first("columna") | La primera fila (o un valor), o null | Buscar por clave, RETURNING id, count(*) |
.raw() | Arrays de valores en lugar de objetos | Respuestas grandes, menos memoria |
DB.batch([s1, s2, ...]) | Un resultado por sentencia | Varias sentencias en un viaje y en una transacción |
DB.exec(sql) | Solo count y duration | Scripts de mantenimiento; nunca con datos del usuario |
DB.withSession(...) | Una sesión con prepare y getBookmark() | Réplicas de lectura |
Usa siempre parámetros (?1, ?2 o ?) en lugar de concatenar valores en el SQL: evitas la inyección de SQL y D1 puede reutilizar la sentencia. Los tipos se convierten así: null a NULL, number a INTEGER o REAL, string a TEXT, boolean a INTEGER (0 o 1) y ArrayBuffer a BLOB. undefined no se admite y lanza un error. Al leer, los booleanos vuelven como 0 o 1 y los BLOB como arrays de números; la documentación recomienda tablas STRICT para que SQLite no guarde un tipo distinto del que declaras.
Una API de artículos con etiquetas
type Articulo = { id: number; slug: string; titulo: string; visitas: number; creado_en: string };

export default {
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);
    const partes = url.pathname.split("/").filter(Boolean); // ["articulos", "mi-slug"]

    // GET /articulos?etiqueta=cloudflare
    if (request.method === "GET" && url.pathname === "/articulos") {
      const etiqueta = url.searchParams.get("etiqueta");
      const stmt = etiqueta
        ? env.DB.prepare(
            `SELECT a.id, a.slug, a.titulo, a.visitas, a.creado_en
               FROM articulos a JOIN etiquetas e ON e.articulo_id = a.id
              WHERE e.etiqueta = ?1
              ORDER BY a.id DESC`,
          ).bind(etiqueta)
        : env.DB.prepare("SELECT id, slug, titulo, visitas, creado_en FROM articulos ORDER BY id DESC LIMIT 50");

      const { results, meta } = await stmt.run<Articulo>();
      return Response.json({ articulos: results, filasLeidas: meta.rows_read, ms: meta.duration });
    }

    // POST /articulos  { slug, titulo, cuerpo, etiquetas: [] }
    if (request.method === "POST" && url.pathname === "/articulos") {
      const datos = await request.json<{ slug: string; titulo: string; cuerpo?: string; etiquetas?: string[] }>();
      if (!datos.slug || !datos.titulo) return Response.json({ error: "slug y titulo son obligatorios" }, { status: 400 });

      try {
        // RETURNING nos da el id sin una segunda consulta
        const creado = await env.DB.prepare(
          "INSERT INTO articulos (slug, titulo, cuerpo) VALUES (?1, ?2, ?3) RETURNING id",
        )
          .bind(datos.slug, datos.titulo, datos.cuerpo ?? "")
          .first<{ id: number }>();

        // batch(): varias sentencias en un único viaje y en una transacción
        const etiquetas = datos.etiquetas ?? [];
        if (etiquetas.length) {
          const insertar = env.DB.prepare("INSERT INTO etiquetas (articulo_id, etiqueta) VALUES (?1, ?2)");
          await env.DB.batch(etiquetas.map((e) => insertar.bind(creado!.id, e)));
        }
        return Response.json({ id: creado!.id }, { status: 201 });
      } catch (err) {
        if (String(err).includes("UNIQUE constraint failed")) {
          return Response.json({ error: "Ese slug ya existe" }, { status: 409 });
        }
        throw err;
      }
    }

    // GET /articulos/:slug  (y suma una visita)
    if (request.method === "GET" && partes[0] === "articulos" && partes[1]) {
      const [visita, articulo] = await env.DB.batch([
        env.DB.prepare("UPDATE articulos SET visitas = visitas + 1 WHERE slug = ?1").bind(partes[1]),
        env.DB.prepare("SELECT id, slug, titulo, visitas, creado_en FROM articulos WHERE slug = ?1").bind(partes[1]),
      ]);
      const fila = (articulo.results as Articulo[])[0];
      if (!fila) return Response.json({ error: "No encontrado" }, { status: 404 });
      return Response.json({ ...fila, filasEscritas: visita.meta.rows_written });
    }

    return new Response("No existe", { status: 404 });
  },
} satisfies ExportedHandler<Env>;
Tres técnicas que merecen un comentario:
RETURNING idcon.first()devuelve el id del artículo recién creado en la misma consulta, sin unSELECT last_insert_rowid()aparte.batch()envía todas las inserciones de etiquetas en un solo viaje a la base de datos. Además, el lote es una transacción: si una sentencia falla, se deshacen todas. Es la forma de hacer transacciones en D1 desde un Worker.- La visita y la lectura en un lote: el
UPDATEque suma la visita y elSELECTque devuelve el artículo van juntos, así que el contador que ves ya incluye tu visita.
Con npx wrangler dev --port 8789:
$ curl "localhost:8789/articulos?etiqueta=backend"
{"articulos":[{"id":2,"slug":"express-a-fondo","titulo":"Express a fondo","visitas":0,"creado_en":"2026-10-02 18:23:53"},
              {"id":1,"slug":"hono-a-fondo","titulo":"Hono a fondo","visitas":0,"creado_en":"2026-10-02 18:23:53"}],
 "filasLeidas":7,"ms":0}

$ curl -X POST localhost:8789/articulos -H "Content-Type: application/json" \
    -d '{"slug":"cloudflare-d1-a-fondo","titulo":"Cloudflare D1 a fondo","etiquetas":["cloudflare","sql"]}' -w " %{http_code}\n"
{"id":3} 201

$ curl -X POST localhost:8789/articulos -H "Content-Type: application/json" \
    -d '{"slug":"cloudflare-d1-a-fondo","titulo":"Otra vez"}' -w " %{http_code}\n"
{"error":"Ese slug ya existe"} 409

$ curl -X POST localhost:8789/articulos -H "Content-Type: application/json" -d '{"slug":"x"}' -w " %{http_code}\n"
{"error":"slug y titulo son obligatorios"} 400

$ curl localhost:8789/articulos/hono-a-fondo
{"id":1,"slug":"hono-a-fondo","titulo":"Hono a fondo","visitas":1,"creado_en":"2026-10-02 18:23:53","filasEscritas":1}
$ curl localhost:8789/articulos/hono-a-fondo
{"id":1,"slug":"hono-a-fondo","titulo":"Hono a fondo","visitas":2,"creado_en":"2026-10-02 18:23:53","filasEscritas":1}

$ curl localhost:8789/articulos/no-existe -w " %{http_code}\n"
{"error":"No encontrado"} 404datetime('now') está en UTC. Las filas se crearon a las 20:23 en Madrid y creado_en dice 18:23:53. SQLite no sabe nada de zonas horarias: guarda en UTC (añadiendo la Z si la vas a mandar a un navegador, o como número con unixepoch()) y convierte al mostrar.Comprobar que el índice se usa
La segunda migración crea un índice sobre etiquetas(etiqueta). EXPLAIN QUERY PLAN confirma que la consulta de filtrado lo usa en lugar de recorrer la tabla:
$ npx wrangler d1 execute blog-db --local --command "EXPLAIN QUERY PLAN SELECT a.slug FROM articulos a
    JOIN etiquetas e ON e.articulo_id = a.id WHERE e.etiqueta = 'backend'"
[
  {
    "results": [
      { "id": 4, "parent": 0, "notused": 63, "detail": "SEARCH e USING INDEX idx_etiquetas_etiqueta (etiqueta=?)" },
      { "id": 9, "parent": 0, "notused": 45, "detail": "SEARCH a USING INTEGER PRIMARY KEY (rowid=?)" }
    ],
    "success": true,
    "meta": { "duration": 0 }
  }
]
SEARCH ... USING INDEX es lo que quieres ver. Si ves SCAN articulos, la consulta recorre la tabla entera y pagarás cada fila. Hazlo con todas las consultas que se ejecuten en cada petición.
Réplicas de lectura y la API de sesiones
La replicación se activa por base de datos desde el panel (o con la API REST, poniendo read_replication.mode a auto). En el código, en lugar de env.DB.prepare(...) se abre una sesión:
export default {
  async fetch(request, env): Promise<Response> {
    // Si el cliente nos devuelve el bookmark de su última petición, seguimos desde ahí;
    // si no, la primera consulta puede ir a cualquier réplica.
    const bookmark = request.headers.get("x-d1-bookmark") ?? "first-unconstrained";
    const sesion = env.DB.withSession(bookmark);

    const { results } = await sesion.prepare("SELECT slug, titulo FROM articulos ORDER BY id DESC LIMIT 20").run();

    const respuesta = Response.json(results);
    // El bookmark marca hasta dónde ha leído esta sesión
    respuesta.headers.set("x-d1-bookmark", sesion.getBookmark() ?? "");
    return respuesta;
  },
} satisfies ExportedHandler<Env>;
Las opciones de withSession() son "first-unconstrained" (la primera consulta va a donde sea más rápido; es la predeterminada), "first-primary" (la primera va a la primaria, para leer lo último) o un bookmark devuelto antes. Si el cliente reenvía el bookmark en cada petición, nunca verá datos más antiguos que los que ya vio, aunque cada petición vaya a una réplica distinta.
getBookmark() devuelve un texto), pero el enrutado real a réplicas solo se ve con una base de datos remota con la replicación activada.Pruebas con las migraciones aplicadas
El plugin de Vitest lee las migraciones y un fichero de configuración las aplica antes de los tests:
import path from "node:path";
import { cloudflareTest, readD1Migrations } from "@cloudflare/vitest-plugin";
import { defineConfig } from "vitest/config";

export default defineConfig(async () => {
  // Lee las migraciones de ./migrations para aplicarlas en cada ejecución de tests
  const migraciones = await readD1Migrations(path.join(import.meta.dirname, "migrations"));
  return {
    plugins: [
      cloudflareTest({
        wrangler: { configPath: "./wrangler.jsonc" },
        miniflare: { bindings: { TEST_MIGRATIONS: migraciones } },
      }),
    ],
    test: { setupFiles: ["./test/aplicar-migraciones.ts"] },
  };
});
import { applyD1Migrations } from "cloudflare:test";
import { env } from "cloudflare:workers";
// Solo aplica las que falten, así que es seguro ejecutarlo varias veces
await applyD1Migrations(env.DB, env.TEST_MIGRATIONS);Para que TypeScript conozca env.TEST_MIGRATIONS, se amplía el tipo Env en test/env.d.ts:
declare namespace Cloudflare {
  interface Env {
    TEST_MIGRATIONS: import("cloudflare:test").D1Migration[];
  }
}
Y los tests:
import { env, exports } from "cloudflare:workers";
import { describe, it, expect } from "vitest";

const crear = (cuerpo: object) =>
  exports.default.fetch("https://x/articulos", {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify(cuerpo),
  });

describe("API de artículos sobre D1", () => {
  it("crea un artículo con etiquetas y lo filtra", async () => {
    const res = await crear({ slug: "d1", titulo: "D1 a fondo", etiquetas: ["cloudflare", "sql"] });
    expect(res.status).toBe(201);

    const lista = await exports.default.fetch("https://x/articulos?etiqueta=sql");
    const datos = await lista.json<{ articulos: { slug: string }[] }>();
    expect(datos.articulos.map((a) => a.slug)).toEqual(["d1"]);
  });

  it("devuelve 409 si el slug se repite", async () => {
    await crear({ slug: "repe", titulo: "Uno" });
    const res = await crear({ slug: "repe", titulo: "Dos" });
    expect(res.status).toBe(409);
  });

  it("el almacenamiento se aísla por fichero, no por test", async () => {
    // Los artículos de los tests anteriores de ESTE fichero siguen ahí
    const { total } = (await env.DB.prepare("SELECT count(*) AS total FROM articulos").first<{ total: number }>())!;
    expect(total).toBe(2); // "d1" y "repe" (el segundo "repe" falló)
  });

  it("una sesión devuelve un bookmark", async () => {
    const sesion = env.DB.withSession("first-primary");
    await sesion.prepare("INSERT INTO articulos (slug, titulo) VALUES ('s', 'Sesión')").run();
    const fila = await sesion.prepare("SELECT titulo FROM articulos WHERE slug = 's'").first<{ titulo: string }>();
    expect(fila?.titulo).toBe("Sesión");
    expect(typeof sesion.getBookmark()).toBe("string");
  });
});
$ npx vitest run
Test Files 1 passed (1)
Tests 4 passed (4)
Duration 582ms (transform 31ms, setup 53ms, import 10ms, tests 31ms, environment 0ms)it() empezaba con la base de datos vacía, y no: los datos de un test siguen ahí en el siguiente del mismo fichero. El tercer test lo demuestra contando las filas. Si necesitas tests independientes, usa datos distintos en cada uno (slugs únicos) o sepáralos en ficheros.Copias de seguridad: Time Travel y export
D1 guarda un historial de cambios que permite restaurar la base de datos a cualquier minuto de los últimos 30 días (7 en el plan gratuito). No hay que activarlo:
npx wrangler d1 time-travel info blog-db                       # bookmark actual
npx wrangler d1 time-travel restore blog-db --timestamp=2026-10-02T18:00:00Z
npx wrangler d1 export blog-db --remote --output=copia.sql     # volcado SQL completo
La restauración sobrescribe la base de datos actual (Wrangler te devuelve un bookmark para deshacerla). Para tener una copia fuera de Cloudflare, d1 export genera un .sql que puedes subir a R2 desde un cron.
Límites que importan
| Límite | Workers Paid | Workers Free |
|---|---|---|
| Tamaño máximo de una base de datos | 10 GB | 500 MB |
| Almacenamiento por cuenta | 1 TB | 5 GB |
| Bases de datos por cuenta | 50.000 | 10 |
| Consultas por invocación del Worker | 1.000 | 50 |
| Time Travel | 30 días | 7 días |
| Duración máxima de una consulta | 30 segundos | 30 segundos |
| Parámetros por consulta | 100 | 100 |
| Columnas por tabla | 100 | 100 |
| Tamaño de una fila, cadena o BLOB | 2 MB | 2 MB |
| Longitud de una sentencia SQL | 100 KB | 100 KB |
El de 100 parámetros sorprende a menudo: un INSERT de 50 filas con 3 columnas son 150 parámetros y falla. Divide en lotes o usa batch() con una sentencia por fila, como hace el ejemplo con las etiquetas.
Errores comunes (y cómo evitarlos)
- Consultas sin índice en cada petición. Funcionan perfectamente en desarrollo y te cuestan una fortuna en filas leídas en producción.
EXPLAIN QUERY PLANymeta.rows_readson tus amigos. - Pasar
undefinedabind(). Lanza un error. Usa?? nullen los campos opcionales. - Pensar en una base de datos enorme. El límite de 10 GB es duro. Si tu modelo encaja en "una base de datos por cliente", D1 brilla; si necesitas una única base de datos de 200 GB, mira Hyperdrive con tu PostgreSQL.
- Muchas consultas pequeñas en serie. Cada una es un viaje a la región de la base de datos. Agrúpalas con
batch()o con unJOIN. - Concatenar SQL. Además del riesgo de inyección, es más lento. Parámetros siempre.
- Olvidar
--remoteal migrar producción (o, peor, usarlo sin querer). Mete la migración remota en tu pipeline de despliegue y no la lances a mano. - Fechas en hora local.
datetime('now')es UTC; trátalo así de principio a fin.
Cuándo usar D1 (y cuándo no)
Usa D1 para el modelo de datos relacional de una aplicación en Workers: usuarios, contenidos, pedidos, configuración. Brilla con muchas bases de datos pequeñas (una por cliente) y con cargas de lectura, y su capa gratuita cubre de sobra un proyecto personal.
No es lo adecuado si necesitas una base de datos de más de 10 GB, muchas escrituras concurrentes sobre los mismos datos (un único hilo por base de datos) o PostgreSQL y sus extensiones: para eso, Hyperdrive delante de tu base de datos. Y para datos clave-valor que se leen muchísimo y cambian poco, KV es más rápido y sencillo.
Sigue leyendo
- Cloudflare a fondo: la visión general, con Hyperdrive para usar tu propio PostgreSQL.
- Cloudflare Workers a fondo: el runtime desde el que se usa D1.
- Cloudflare Workers KV a fondo: cuándo un clave-valor es mejor que SQL.
- Cloudflare Durable Objects a fondo: SQLite dentro de cada objeto, para estado con coordinación.
- Planes de Cloudflare Workers: Free frente a Paid: qué pasa con D1 al cambiar de plan.
- Cloudflare Hyperdrive a fondo: cuando necesitas PostgreSQL o MySQL en lugar de D1.
- Cloudflare Vectorize a fondo: búsqueda por significado en lugar de por palabras.