Cloudflare Browser Run a fondo: Chrome sin servidor para capturas, PDF y scraping
Qué es Browser Run (antes Browser Rendering): Chrome sin cabeza en la red de Cloudflare, con Quick Actions por API o control total con Puppeteer desde un Worker. Límites, precios por horas de navegador y un servicio de capturas con caché en KV probado en local.
Contenido
Hay tareas que solo se pueden hacer con un navegador de verdad: sacar una captura de una página para la vista previa de un enlace, generar un PDF de una factura a partir de HTML, leer el contenido de una web que se pinta con JavaScript o comprobar que tu aplicación carga bien. Montar Chrome en un servidor propio funciona, pero consume memoria, hay que actualizarlo y escala mal.
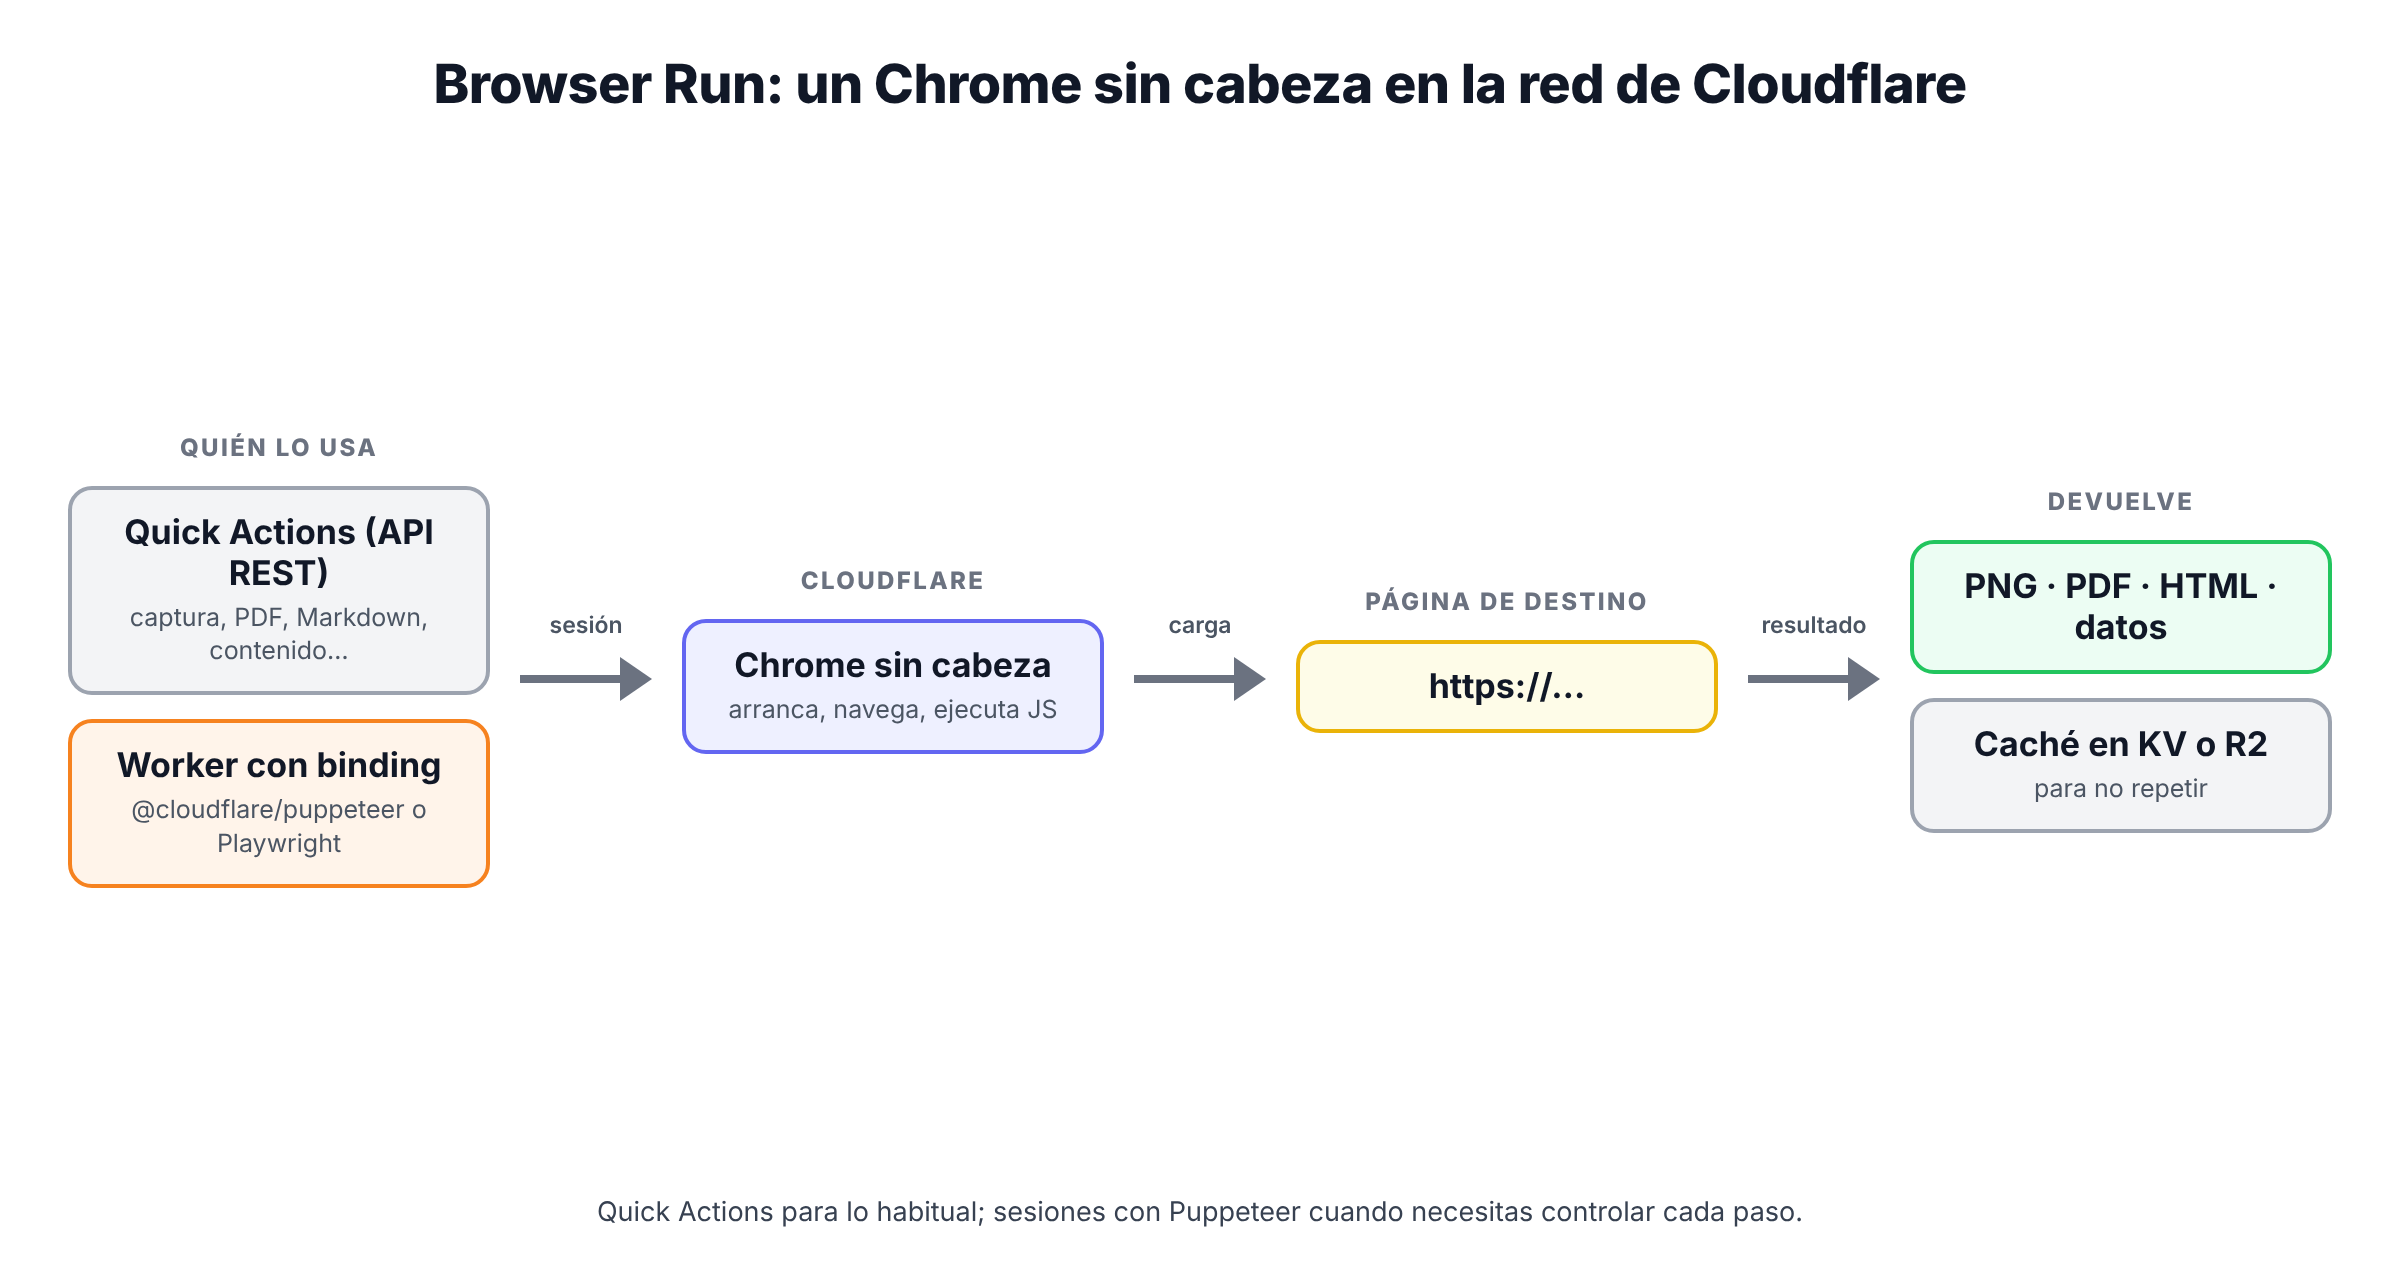
Browser Run (hasta hace poco Browser Rendering) te da Chrome sin cabeza (headless) en la red de Cloudflare, sin servidor. Se puede usar de dos maneras: con Quick Actions, endpoints listos para capturas, PDF, Markdown o scraping, y con sesiones de navegador, en las que controlas Chrome desde un Worker con Puppeteer, Playwright o el protocolo CDP.
En este artículo vemos cómo funciona, sus límites y precios, y un Worker que hace capturas y extrae metadatos de páginas, con caché en KV, ejecutado en local con el Chrome que descarga Wrangler.
Cómo funciona
Quick Actions
Son endpoints de la API de Cloudflare (/accounts/<id>/browser-run/<acción>) que reciben una URL o HTML y devuelven el resultado. No escribes código de navegador:
| Endpoint | Devuelve |
|---|---|
/screenshot | Captura de pantalla |
/pdf | PDF de la página |
/content | HTML ya renderizado |
/markdown | La página convertida a Markdown |
/snapshot | Varios formatos a la vez |
/scrape | Elementos concretos según selectores |
/links | Los enlaces de la página |
/json | Datos estructurados extraídos con IA |
/accessibilityTree | El árbol de accesibilidad |
/crawl | Rastreo de varias páginas de un sitio |
Se pueden llamar con un token de API desde cualquier sitio, o desde un Worker mediante el binding sin token.
Sesiones de navegador
Si necesitas hacer clic, rellenar formularios, esperar a un elemento o encadenar páginas, abres una sesión y controlas Chrome con Puppeteer (la versión adaptada @cloudflare/puppeteer), Playwright o CDP directamente. Una sesión se cierra tras 60 segundos de inactividad por defecto; con la opción keep_alive puedes alargarlo hasta 10 minutos, y puedes reconectarte a una sesión abierta para reutilizarla en otra petición.
Límites y precios
Browser Run está disponible en Free y Paid. Se paga por horas de navegador (las de Quick Actions y las de sesiones se suman) y, solo en sesiones, por navegadores concurrentes:
| Concepto | Workers Free | Workers Paid |
|---|---|---|
| Horas de navegador | 10 minutos al día | 10 horas al mes, después 0,09 $/hora |
| Navegadores concurrentes (sesiones) | 3 | 10 incluidos (media mensual), después 2 $ por navegador |
| Máximo de navegadores concurrentes | 3 por cuenta | 200 por cuenta |
| Navegadores nuevos | 1 cada 20 segundos | 3 por segundo |
| Peticiones a Quick Actions | 1 cada 10 segundos | 30 por segundo |
Rastreos (/crawl) | 5 al día, 100 páginas cada uno | Sin estos límites adicionales |
| Inactividad antes de cerrar | 60 s (ampliable a 10 min) | 60 s (ampliable a 10 min) |
Los navegadores concurrentes se calculan como media mensual. El ejemplo oficial: 10 navegadores durante 15 días y 20 durante otros 15 dan una media de 15; menos los 10 incluidos, son 5 × 2 $ = 10 $ al mes.
Browser time limit exceeded for today (código 429). Cierra siempre el navegador y cachea los resultados.El código
La configuración necesita el binding browser y, en este ejemplo, un namespace de KV para guardar las capturas:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "browser-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "browser": { "binding": "NAVEGADOR" },
  "kv_namespaces": [{ "binding": "CAPTURAS", "id": "66666666666666666666666666666666" }]
}
El Worker tiene dos rutas: /captura devuelve un PNG de la página (y lo guarda un día en KV) y /meta abre la página y lee del DOM el título, la descripción, los h1 y el número de enlaces:
import puppeteer from "@cloudflare/puppeteer";

// `document` solo existe dentro del navegador (en page.evaluate), no en el Worker
declare const document: any;

// Solo dejamos capturar páginas públicas por HTTPS (evita usar el Worker como proxy)
function urlPermitida(texto: string | null): URL | null {
  try {
    const u = new URL(texto ?? "");
    return u.protocol === "https:" ? u : null;
  } catch {
    return null;
  }
}

export default {
  async fetch(request, env): Promise<Response> {
    const { pathname, searchParams } = new URL(request.url);
    const destino = urlPermitida(searchParams.get("url"));
    if (!destino) return new Response("Parámetro url no válido (solo https)", { status: 400 });

    if (pathname === "/captura") {
      const clave = `png:${destino.href}`;
      const guardada = await env.CAPTURAS.get(clave, "arrayBuffer");
      if (guardada) {
        return new Response(guardada, { headers: { "content-type": "image/png", "x-cache": "HIT" } });
      }

      const browser = await puppeteer.launch(env.NAVEGADOR);
      try {
        const page = await browser.newPage();
        await page.setViewport({ width: 1200, height: 630 });
        await page.goto(destino.href, { waitUntil: "networkidle0", timeout: 20_000 });
        const png = await page.screenshot({ type: "png" });
        // Una captura por URL y día: ahorra horas de navegador
        await env.CAPTURAS.put(clave, png, { expirationTtl: 86_400 });
        return new Response(png, { headers: { "content-type": "image/png", "x-cache": "MISS" } });
      } finally {
        // Sin close() la sesión sigue abierta (y facturando) hasta que caduca
        await browser.close();
      }
    }

    if (pathname === "/meta") {
      const browser = await puppeteer.launch(env.NAVEGADOR);
      try {
        const page = await browser.newPage();
        await page.goto(destino.href, { waitUntil: "domcontentloaded" });
        // page.evaluate se ejecuta DENTRO del navegador, sobre el DOM ya renderizado
        const datos = await page.evaluate(() => ({
          titulo: document.title,
          descripcion: document.querySelector('meta[name="description"]')?.getAttribute("content") ?? null,
          h1: [...document.querySelectorAll("h1")].map((h: any) => h.textContent?.trim()),
          enlaces: document.querySelectorAll("a[href]").length,
        }));
        return Response.json(datos);
      } finally {
        await browser.close();
      }
    }

    return new Response("Rutas: /captura?url=… y /meta?url=…", { status: 404 });
  },
} satisfies ExportedHandler<Env>;
Tres decisiones de diseño: solo se aceptan URL https:, para que nadie use tu Worker para leer file:// o servicios internos; el browser.close() va en un finally, para que la sesión se cierre aunque algo falle; y cada captura se cachea, porque las horas de navegador son lo que pagas.
El declare const document: any es un truco de TypeScript: la función que pasas a page.evaluate se ejecuta dentro de Chrome, donde sí existe document, pero el compilador del Worker no lo sabe.
Ejecución en local
Con wrangler dev, la primera vez que se usa el binding Wrangler descarga un Chrome y lo arranca en tu máquina:
├ Downloading browser...
│ downloaded browser
Y estas son las peticiones de prueba, contra este blog y contra example.com:
$ curl -s "localhost:8809/meta?url=https://blog.devutilites.com/"
{"titulo":"Blog","descripcion":"Notas de programación, herramientas y tecnología, ordenadas por temas.","h1":["Notas de programación, herramientas y tecnología, ordenadas por temas."],"enlaces":49} (HTTP 200, 2.385134s)
$ curl -s "localhost:8809/meta?url=https://example.com/"
{"titulo":"Example Domain","descripcion":null,"h1":[],"enlaces":1} (HTTP 200, 0.508761s)
$ curl -s -o captura.png -D - "localhost:8809/captura?url=https://example.com/" | grep -iE "^HTTP|x-cache|content-type"
HTTP/1.1 200 OK
Content-Type: image/png
x-cache: MISS
$ curl -s -o captura.png -D - "localhost:8809/captura?url=https://example.com/" | grep -iE "^HTTP|x-cache"   # segunda vez
HTTP/1.1 200 OK
x-cache: HIT
$ curl -s "localhost:8809/captura?url=file:///etc/passwd"
Parámetro url no válido (solo https) (HTTP 400)
La primera captura tarda 1,2 s (arrancar Chrome, cargar la página, renderizar) y la segunda 5 ms, servida desde KV. La URL file:// se rechaza antes de abrir el navegador. Si quieres ver lo que hace Chrome mientras desarrollas, la documentación describe un modo experimental con ventana: X_BROWSER_HEADFUL=true npx wrangler dev.
Errores comunes (y cómo evitarlos)
- No cerrar el navegador. Es la causa número uno de agotar el cupo.
browser.close()en unfinally. - Abrir un navegador por petición sin caché. Cachea capturas y PDF en KV o R2; reutiliza sesiones si haces muchas operaciones seguidas.
- Aceptar cualquier URL. Un servicio de capturas abierto es un proxy para cualquiera. Valida el esquema, limita dominios si puedes y protégelo con autenticación o rate limiting.
- Esperar a
networkidle0en páginas que nunca paran. Algunas webs hacen peticiones constantes. Pon untimeouto espera a un selector concreto. - Usar Puppeteer cuando bastaba una Quick Action. Para una captura o un PDF, el endpoint es más simple.
- Olvidar el límite de navegadores nuevos. En Free solo puedes abrir uno cada 20 segundos; con varias peticiones a la vez, reutiliza la sesión.
- Confiar en
documentfuera deevaluate. En el Worker no existe DOM.
Cuándo usar Browser Run (y cuándo no)
Úsalo para generar imágenes de vista previa (Open Graph), PDF de facturas o informes a partir de HTML, leer webs que se renderizan con JavaScript, convertir páginas a Markdown para alimentar un modelo de IA y pruebas sencillas de que una página carga.
No lo necesitas si la página que quieres leer es HTML estático: un fetch y HTMLRewriter son mucho más baratos. Y para suites grandes de tests de extremo a extremo, un Playwright en tu CI sigue siendo lo normal.
Sigue leyendo
- Cloudflare a fondo: la visión general de la plataforma.
- Cloudflare Workers a fondo: el runtime desde el que controlas el navegador.
- Cloudflare Workers KV a fondo: la caché de las capturas.
- Cloudflare R2 a fondo: para guardar PDF y capturas grandes.
- Cloudflare Workers AI a fondo: qué hacer con el Markdown que extraes.