Cloudflare R2 a fondo: almacenamiento de objetos compatible con S3 y sin pagar por la salida
Cómo funciona R2, clases de almacenamiento, operaciones A y B y sus precios, el binding de Workers con streaming, rangos y ETag, subidas multiparte, la API de S3, URLs prefirmadas, buckets públicos, pruebas en local y límites, con código probado.
Contenido
Si alguna vez has pagado una factura de Amazon S3, sabes que lo caro no suele ser guardar los datos, sino sacarlos. Cada gigabyte que sale hacia Internet se cobra, y en una web con muchas imágenes, vídeos o descargas, la partida de transferencia puede multiplicar por diez la de almacenamiento. Es el famoso egress.
R2 es la respuesta de Cloudflare: un almacenamiento de objetos compatible con la API de S3 que no cobra nada por la transferencia de salida. Pagas por lo que guardas y por las operaciones que haces; servir el mismo fichero un millón de veces cuesta lo mismo en transferencia que servirlo una vez: cero.
En este artículo vamos a ver cómo funciona por dentro, qué cuesta de verdad (con las operaciones de clase A y B, que es donde está la letra pequeña), cómo se usa desde un Worker con el binding nativo, cómo se usa desde cualquier sitio con la API de S3, y una API de ficheros completa con subidas en streaming, descargas parciales, ETag y subidas multiparte, probada en local sin cuenta de Cloudflare.
Qué es R2
R2 es un almacenamiento de objetos: guardas ficheros (objetos) identificados por una clave dentro de un contenedor (bucket). No hay carpetas de verdad, aunque las claves con / (fotos/2026/playa.jpg) se comportan como tales cuando listas con un delimitador. Cada objeto puede pesar hasta casi 5 TiB y llevar metadatos HTTP (Content-Type, Cache-Control...) y metadatos propios.
Hay tres formas de acceder a un bucket:
- Desde un Worker, con el binding de R2. La más rápida y cómoda:
env.MI_BUCKET.get("clave"). Sin credenciales, sin firmas, sin SDK. - Con la API compatible con S3, desde cualquier sitio: tu servidor,
rclone, el SDK de AWS, Terraform... Necesitas un token de API de R2 (Access Key ID y Secret). - Públicamente por HTTP, conectando un dominio propio al bucket (o con la URL
r2.dev, solo para pruebas).
Para qué se usa
- Imágenes, vídeos, descargas y cualquier fichero que sirva una web, sobre todo si se descarga mucho.
- Subidas de usuarios (avatares, adjuntos, documentos).
- Copias de seguridad y exportaciones (bases de datos, logs).
- Conjuntos de datos para análisis o para entrenar modelos.
- Como sustituto de S3 en aplicaciones existentes, cambiando solo el endpoint.
Cómo funciona por dentro
Cada bucket tiene una ubicación: R2 lo crea en la región más cercana a quien lo crea, o en la que pidas con una location hint (weur para Europa occidental, eeur, wnam, enam, apac, oc). Si necesitas garantizar que los datos no salen de la Unión Europea, puedes crear el bucket con la jurisdicción eu. Los datos se guardan en esa región; lo que se distribuye por la red de Cloudflare es el acceso, no los datos.
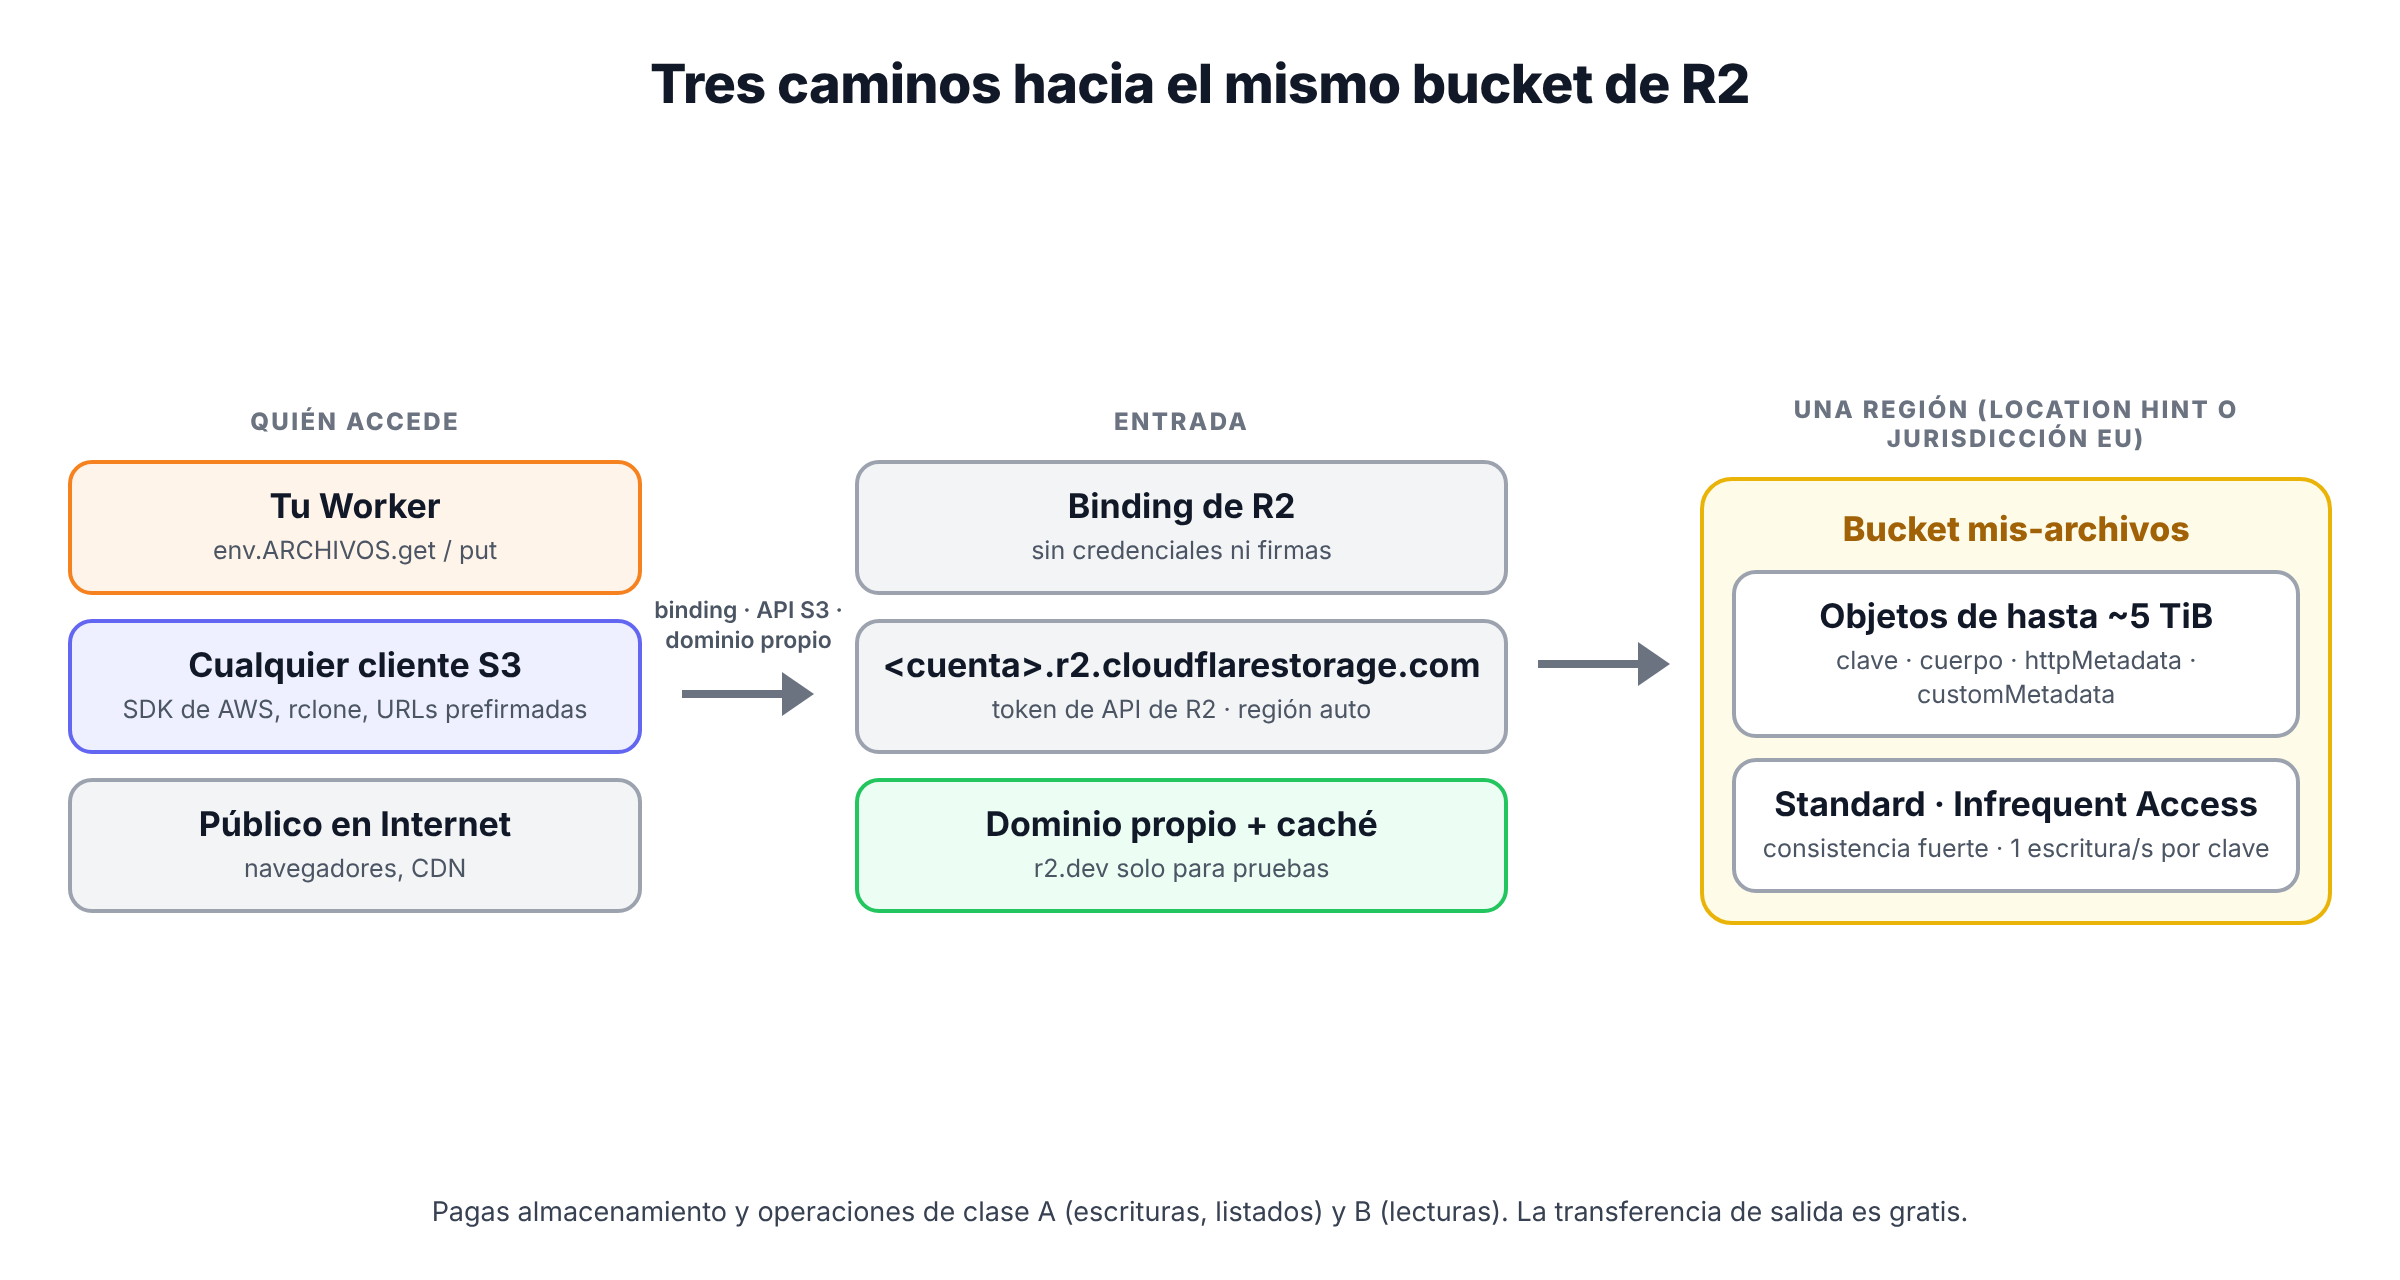
R2 es fuertemente consistente: en cuanto un put termina, cualquier lectura desde cualquier sitio ve el objeto nuevo, y los listados también. Hay una excepción práctica: un mismo objeto (misma clave) admite una escritura por segundo; si escribes más rápido, recibirás errores 429.
Las dos clases de almacenamiento
- Standard: para datos que se leen a menudo. Es la predeterminada y la única con capa gratuita.
- Infrequent Access: almacenamiento más barato a cambio de operaciones más caras, una tarifa por gigabyte leído y un mínimo de 30 días: aunque borres el objeto al día siguiente, pagas el mes. Útil para copias de seguridad y archivos que casi nunca se leen.
Lo que cuesta
R2 cobra tres cosas: el almacenamiento (por GB-mes), las operaciones de clase A (las que modifican estado: PutObject, CopyObject, ListObjects, las de multiparte...) y las de clase B (las que leen: GetObject, HeadObject...). Borrar es gratis, y no se cobran las peticiones rechazadas por falta de permiso (401).
| Concepto | Standard | Infrequent Access |
|---|---|---|
| Almacenamiento | 0,015 $ / GB-mes | 0,01 $ / GB-mes |
| Operaciones de clase A | 4,50 $ / millón | 9,00 $ / millón |
| Operaciones de clase B | 0,36 $ / millón | 0,90 $ / millón |
| Recuperación de datos | Gratis | 0,01 $ / GB |
| Transferencia de salida | Gratis | Gratis |
Y la capa gratuita, cada mes y solo para Standard:
| Incluido gratis cada mes | |
|---|---|
| Almacenamiento | 10 GB-mes |
| Operaciones de clase A | 1 millón |
| Operaciones de clase B | 10 millones |
Tres matices que conviene saber antes de hacer números:
- Se redondea hacia arriba a la unidad de facturación. Un millón y una operaciones se cobran como dos millones; 1,1 GB-mes como 2.
- El GB-mes se calcula con el pico diario. Guardar 1 GB 5 días y 3 GB los 25 restantes son
1 × 5/30 + 3 × 25/30 = 2,66GB-mes. - Las lecturas pueden ser la partida principal. El propio ejemplo de la documentación: 100.000 ficheros de 100 KB leídos 10 millones de veces al día salen a unos 104 dólares al mes, todo en operaciones de clase B (290 millones facturables). La solución es poner la caché de Cloudflare delante con un dominio propio: lo que sale de caché no llega a R2 y no es una operación.
Primeros pasos con Wrangler
# Crear el bucket (necesita cuenta)
npx wrangler r2 bucket create mis-archivos
npx wrangler r2 bucket create mis-archivos-eu --jurisdiction eu   # datos dentro de la UE
npx wrangler r2 bucket create copias --storage-class InfrequentAccess --location weur

# Gestionar objetos (añade --local para trabajar con los datos de wrangler dev)
npx wrangler r2 object put mis-archivos/notas/cli.txt --file ./hola.txt --content-type text/plain
npx wrangler r2 object get mis-archivos/notas/cli.txt --pipe
npx wrangler r2 object delete mis-archivos/notas/cli.txt

# Configuración del bucket
npx wrangler r2 bucket cors --help        # reglas CORS (para subidas desde el navegador)
npx wrangler r2 bucket lifecycle --help   # caducidad y paso a Infrequent Access
npx wrangler r2 bucket domain --help      # dominio propio
npx wrangler r2 bucket notification --help  # avisos a una cola al crear o borrar objetos
Y el binding en wrangler.jsonc:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "r2-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "r2_buckets": [
    { "binding": "ARCHIVOS", "bucket_name": "mis-archivos" }
  ],
  "vars": { "MAX_SUBIDA_MB": "50" }
}
Si omites bucket_name, Wrangler crea el bucket por ti en el primer wrangler deploy (aprovisionamiento automático) y escribe el nombre en la configuración.
La API del binding
Lo que hay en env.ARCHIVOS es un objeto R2Bucket con estos métodos:
| Método | Para qué | Clase |
|---|---|---|
head(clave) | Metadatos sin el cuerpo, o null si no existe | B |
get(clave, opciones?) | El objeto con su cuerpo en streaming. Admite range y onlyIf | B |
put(clave, valor, opciones?) | Sube un ReadableStream, ArrayBuffer, string, Blob... | A |
delete(clave | claves[]) | Borra uno o varios (hasta 1.000) | Gratis |
list(opciones?) | Lista por prefijo, con cursor, delimitador y metadatos | A |
createMultipartUpload(clave) | Empieza una subida por partes | A |
resumeMultipartUpload(clave, id) | Retoma una subida por partes desde otra petición | — |
Lo que devuelve get() es un R2ObjectBody: los metadatos (key, size, etag, httpEtag, uploaded, httpMetadata, customMetadata, range, storageClass) más el cuerpo como ReadableStream en body, y atajos como text(), json(), arrayBuffer() y blob(). Dos métodos de ayuda que se usan siempre: writeHttpMetadata(headers), que copia a unas cabeceras de respuesta los metadatos HTTP guardados al subir, y httpEtag, el ETag ya entrecomillado como manda el estándar.
Una API de ficheros completa
Este Worker convierte un bucket en una pequeña API de ficheros: subidas protegidas por token, descargas con soporte de Range (para vídeos y descargas reanudables) y de If-None-Match (para que el navegador no vuelva a descargar lo que ya tiene), HEAD, borrado y listados por "carpetas":
// API mínima de ficheros sobre un bucket R2
// PUT    /f/<clave>          sube (cuerpo en streaming)       requiere token
// GET    /f/<clave>          descarga (Range, If-None-Match)
// HEAD   /f/<clave>          solo metadatos
// DELETE /f/<clave>          borra                              requiere token
// GET    /lista?prefijo=x/   lista con paginación por cursor

export default {
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);

    if (url.pathname === "/lista") return listar(url, env);

    if (!url.pathname.startsWith("/f/")) return new Response("No existe", { status: 404 });
    const clave = decodeURIComponent(url.pathname.slice(3));
    if (!clave) return new Response("Falta la clave", { status: 400 });

    switch (request.method) {
      case "PUT": {
        if (!autorizado(request, env)) return new Response("No autorizado", { status: 401 });
        const tamano = Number(request.headers.get("Content-Length") ?? 0);
        if (tamano > Number(env.MAX_SUBIDA_MB) * 1024 * 1024) {
          return new Response("Demasiado grande", { status: 413 });
        }
        const objeto = await env.ARCHIVOS.put(clave, request.body, {
          httpMetadata: request.headers, // guarda Content-Type, Cache-Control, etc.
          customMetadata: { subidoPor: "api", origen: request.headers.get("User-Agent") ?? "?" },
        });
        return Response.json({ clave: objeto!.key, tamano: objeto!.size, etag: objeto!.httpEtag }, { status: 201 });
      }

      case "GET":
      case "HEAD": {
        const objeto =
          request.method === "HEAD"
            ? await env.ARCHIVOS.head(clave)
            : await env.ARCHIVOS.get(clave, { range: request.headers, onlyIf: request.headers });

        if (objeto === null) return new Response("No encontrado", { status: 404 });

        const headers = new Headers();
        objeto.writeHttpMetadata(headers); // Content-Type, Cache-Control... los que se guardaron al subir
        headers.set("ETag", objeto.httpEtag);
        headers.set("Accept-Ranges", "bytes");

        // Si no hay body, es un HEAD o una condición (If-None-Match) que no se cumplió
        if (!tieneCuerpo(objeto)) {
          const status = request.method === "HEAD" ? 200 : 304;
          if (status === 200) headers.set("Content-Length", String(objeto.size));
          return new Response(null, { status, headers });
        }

        if (objeto.range && request.headers.has("Range")) {
          const r = objeto.range as { offset: number; length: number };
          headers.set("Content-Range", `bytes ${r.offset}-${r.offset + r.length - 1}/${objeto.size}`);
          return new Response(objeto.body, { status: 206, headers });
        }
        return new Response(objeto.body, { headers });
      }

      case "DELETE": {
        if (!autorizado(request, env)) return new Response("No autorizado", { status: 401 });
        await env.ARCHIVOS.delete(clave); // borrar no cuesta nada y no falla si no existe
        return new Response(null, { status: 204 });
      }

      default:
        return new Response("Método no permitido", { status: 405, headers: { Allow: "GET, HEAD, PUT, DELETE" } });
    }
  },
} satisfies ExportedHandler<Env>;

async function listar(url: URL, env: Env): Promise<Response> {
  const resultado = await env.ARCHIVOS.list({
    prefix: url.searchParams.get("prefijo") ?? undefined,
    cursor: url.searchParams.get("cursor") ?? undefined,
    delimiter: "/", // agrupa "subcarpetas" en delimitedPrefixes
    limit: 100,
    include: ["httpMetadata", "customMetadata"],
  });
  return Response.json({
    objetos: resultado.objects.map((o) => ({ clave: o.key, tamano: o.size, tipo: o.httpMetadata?.contentType })),
    carpetas: resultado.delimitedPrefixes,
    siguiente: resultado.truncated ? resultado.cursor : null,
  });
}

function autorizado(request: Request, env: Env): boolean {
  return request.headers.get("Authorization") === `Bearer ${env.ADMIN_TOKEN}`;
}

// get() devuelve R2ObjectBody (con body) o R2Object (sin body) si falla onlyIf
function tieneCuerpo(o: R2Object): o is R2ObjectBody {
  return "body" in o;
}
Lo más importante está en dos líneas:
env.ARCHIVOS.put(clave, request.body, ...)sube en streaming: el cuerpo de la petición va directo a R2 sin cargarse en memoria. Con los 128 MB de memoria de un Worker, es la única forma razonable de aceptar ficheros grandes.env.ARCHIVOS.get(clave, { range: request.headers, onlyIf: request.headers })le pasa a R2 las cabeceras del cliente tal cual. R2 entiendeRange,If-None-Match,If-Match,If-Modified-Since... Si la condición no se cumple,get()devuelve el objeto sinbody, y por eso el código comprueba si hay cuerpo para responder un 304.
"body" in objeto no le basta a TypeScript. Mi primera versión comprobaba if (!("body" in objeto)) y luego pasaba objeto.body a new Response(). Compila mal: "Argument of type 'unknown' is not assignable to parameter of type 'BodyInit'". El estrechamiento con in no llega a R2ObjectBody. La solución es el pequeño type guard tieneCuerpo() del final del fichero.Así se comporta con npx wrangler dev --port 8788 (el token sale de .dev.vars):
$ curl -X PUT --data-binary @hola.txt localhost:8788/f/docs/hola.txt -w " %{http_code}\n"
No autorizado 401

$ curl -X PUT -H "Authorization: Bearer secreto-local" \
    -H "Content-Type: text/plain; charset=utf-8" -H "Cache-Control: public, max-age=3600" \
    --data-binary @hola.txt localhost:8788/f/docs/hola.txt -w " %{http_code}\n"
{"clave":"docs/hola.txt","tamano":38,"etag":"\"f238a3e221f546932c241e0cdce29ca4\""} 201

$ curl -i localhost:8788/f/docs/hola.txt
HTTP/1.1 200 OK
Content-Length: 38
Content-Type: text/plain; charset=utf-8
Accept-Ranges: bytes
Cache-Control: public, max-age=3600
ETag: "f238a3e221f546932c241e0cdce29ca4"

Hola R2, esto es un fichero de prueba.

$ curl -i -H "Range: bytes=0-6" localhost:8788/f/docs/hola.txt
HTTP/1.1 206 Partial Content
Content-Length: 7
Content-Range: bytes 0-6/38
...
Hola R2

$ curl -o /dev/null -w "%{http_code}\n" -H 'If-None-Match: "f238a3e221f546932c241e0cdce29ca4"' \
    localhost:8788/f/docs/hola.txt
304

$ curl -I localhost:8788/f/img/arquitectura.png
HTTP/1.1 200 OK
Content-Length: 203524
Content-Type: image/png
Accept-Ranges: bytes
ETag: "7e2c23804ce95f53ca71a31769e7657e"

$ curl localhost:8788/lista
{"objetos":[],"carpetas":["docs/","img/"],"siguiente":null}

$ curl "localhost:8788/lista?prefijo=docs/"
{"objetos":[{"clave":"docs/datos.json","tamano":8,"tipo":"application/json"},
            {"clave":"docs/hola.txt","tamano":38,"tipo":"text/plain; charset=utf-8"}],"carpetas":[],"siguiente":null}

$ curl -i -X POST localhost:8788/f/x
HTTP/1.1 405 Method Not Allowed

$ curl -X DELETE -H "Authorization: Bearer secreto-local" localhost:8788/f/docs/datos.json -w "%{http_code}\n"
204
Fíjate en el listado de la raíz: con delimiter: "/", R2 no devuelve los objetos de dentro de docs/ e img/, sino esas "carpetas" en delimitedPrefixes. Así se construye un explorador de ficheros sin traerse el bucket entero.
wrangler dev y la CLI comparten los datos locales. Un objeto subido con npx wrangler r2 object put mis-archivos/notas/cli.txt --local --file hola.txt aparece al momento en GET /lista?prefijo=notas/ del Worker en marcha. Todo vive en .wrangler/state/v3/r2.Paginar un listado
list() devuelve como máximo 1.000 objetos (aquí he pedido 100). Si hay más, truncated es true y cursor te da la siguiente página. Si usas include para traer metadatos, puede devolver menos de los que pides para que quepan, así que no compruebes si te han llegado limit objetos: comprueba truncated. Recuerda además que cada list() es una operación de clase A, la cara.
Subidas multiparte
Una sola petición put admite hasta 5 GiB (menos 5 MiB). Para ficheros más grandes, o para subir en paralelo y reanudar si algo falla, está la subida multiparte: hasta 10.000 partes de entre 5 MiB y 5 GiB, todas del mismo tamaño salvo la última. Así se hace con el binding (es un test del proyecto, así que está probado):
const MiB = 1024 * 1024;
const subida = await env.ARCHIVOS.createMultipartUpload("grande.bin", {
  httpMetadata: { contentType: "application/octet-stream" },
});

const partes: R2UploadedPart[] = [];
for (let i = 1; i <= 3; i++) {
  partes.push(await subida.uploadPart(i, new Uint8Array(5 * MiB).fill(i)));
}
partes.push(await subida.uploadPart(4, new Uint8Array(1234).fill(9))); // la última puede ser pequeña

const objeto = await subida.complete(partes);
// objeto.size === 15 * MiB + 1234
En una aplicación real, el navegador pide al Worker que cree la subida (que devuelve subida.uploadId), sube cada parte en una petición distinta a una ruta que hace env.ARCHIVOS.resumeMultipartUpload(clave, uploadId).uploadPart(n, request.body), y al final pide completar con la lista de partes. Si se abandona, abort() libera lo subido.
La API de S3 y las URLs prefirmadas
Fuera de Workers, R2 habla S3. El endpoint es https://<ID_DE_CUENTA>.r2.cloudflarestorage.com, la región es auto y las credenciales se crean en el panel como token de API de R2. Cualquier SDK de S3 funciona cambiando esos tres datos.
La pieza más útil es la URL prefirmada: una URL con la firma incluida que permite una operación (GET, PUT, HEAD o DELETE) sobre un objeto durante un tiempo (de 1 segundo a 7 días). Se genera en tu servidor sin hablar con R2 y se la das al navegador para que suba o descargue directamente, sin pasar por tu Worker ni por los 100 MB de límite del cuerpo de la petición. Este es el ejemplo de la documentación oficial con el SDK de AWS:
import { S3Client, GetObjectCommand, PutObjectCommand } from "@aws-sdk/client-s3";
import { getSignedUrl } from "@aws-sdk/s3-request-presigner";

const S3 = new S3Client({
  region: "auto", // obligatorio para el SDK, R2 lo ignora
  endpoint: `https://${ACCOUNT_ID}.r2.cloudflarestorage.com`,
  credentials: { accessKeyId: ACCESS_KEY_ID, secretAccessKey: SECRET_ACCESS_KEY },
});

// Descargar durante una hora
const urlDescarga = await getSignedUrl(S3, new GetObjectCommand({ Bucket: "mis-archivos", Key: "docs/hola.txt" }), {
  expiresIn: 3600,
});

// Subir: fijar el Content-Type hace que una subida con otro tipo falle con 403
const urlSubida = await getSignedUrl(
  S3,
  new PutObjectCommand({ Bucket: "mis-archivos", Key: "subidas/foto.png", ContentType: "image/png" }),
  { expiresIn: 600 },
);wrangler r2 bucket cors) o el navegador bloqueará la subida. Y un detalle de la documentación: las URLs prefirmadas solo funcionan con el dominio de la API de S3 (<ID_DE_CUENTA>.r2.cloudflarestorage.com), no con un dominio propio conectado al bucket.Buckets públicos
Para servir ficheros sin escribir un Worker, conecta un dominio propio al bucket (wrangler r2 bucket domain add o desde el panel). Con dominio propio tienes la caché de Cloudflare, reglas de caché, WAF y analíticas, y cada acierto de caché es una operación de clase B que te ahorras.
La alternativa rápida, la URL r2.dev, no es para producción: tiene un límite de velocidad variable (cientos de peticiones por segundo) y puede limitar el ancho de banda; si lo superas, devuelve 429.
¿Worker o dominio público? Si necesitas autenticación, transformar respuestas, contar descargas o decidir qué se ve, pon un Worker delante. Si son ficheros públicos sin más, el dominio propio es más simple y más barato.
Pruebas con Vitest
Las mismas pruebas que harías contra S3, pero sin red y en un segundo:
import { env, exports } from "cloudflare:workers";
import { describe, it, expect } from "vitest";

const auth = { Authorization: "Bearer secreto-local" };

describe("API de ficheros sobre R2", () => {
  it("sube, descarga y borra", async () => {
    const put = await exports.default.fetch("https://x/f/a/b.txt", {
      method: "PUT", headers: { ...auth, "Content-Type": "text/plain" }, body: "contenido",
    });
    expect(put.status).toBe(201);

    const get = await exports.default.fetch("https://x/f/a/b.txt");
    expect(get.headers.get("Content-Type")).toBe("text/plain");
    expect(await get.text()).toBe("contenido");

    const del = await exports.default.fetch("https://x/f/a/b.txt", { method: "DELETE", headers: auth });
    expect(del.status).toBe(204);
    expect(await env.ARCHIVOS.head("a/b.txt")).toBeNull();
  });

  it("devuelve 304 si el ETag coincide", async () => {
    const obj = await env.ARCHIVOS.put("c.txt", "hola");
    const res = await exports.default.fetch("https://x/f/c.txt", { headers: { "If-None-Match": obj!.httpEtag } });
    expect(res.status).toBe(304);
  });

  it("multipart: tres partes de 5 MiB + resto", async () => {
    const MiB = 1024 * 1024;
    const subida = await env.ARCHIVOS.createMultipartUpload("grande.bin", {
      httpMetadata: { contentType: "application/octet-stream" },
    });
    const partes: R2UploadedPart[] = [];
    for (let i = 1; i <= 3; i++) {
      partes.push(await subida.uploadPart(i, new Uint8Array(5 * MiB).fill(i)));
    }
    partes.push(await subida.uploadPart(4, new Uint8Array(1234).fill(9)));
    const objeto = await subida.complete(partes);
    expect(objeto.size).toBe(15 * MiB + 1234);

    const cola = await env.ARCHIVOS.get("grande.bin", { range: { suffix: 4 } });
    expect([...new Uint8Array(await cola!.arrayBuffer())]).toEqual([9, 9, 9, 9]);
  });
});
$ npx vitest run
Using secrets defined in .dev.vars
Test Files 1 passed (1)
Tests 3 passed (3)
Duration 1.31s (transform 25ms, setup 0ms, import 28ms, tests 235ms, environment 0ms)El test de multiparte sube 15 MiB en tres partes y una cola de 1.234 bytes, y luego lee los 4 últimos bytes con range: { suffix: 4 }. Miniflare simula R2 fielmente, incluidas las subidas multiparte y los rangos.
Límites que importan
| Límite | Valor |
|---|---|
| Datos y objetos por bucket | Sin límite |
| Buckets por cuenta | 1.000.000 |
| Tamaño de un objeto | 4,995 TiB (5 TiB menos 5 GiB) |
| Subida en una sola petición | 4,995 GiB (5 GiB menos 5 MiB) |
| Partes de una subida multiparte | 10.000, de 5 MiB a 5 GiB |
| Escrituras a la misma clave | 1 por segundo |
| Longitud de la clave | 1.024 bytes |
| Metadatos por objeto | 8.192 bytes |
| Dominios propios por bucket | 100 |
| Operaciones de gestión de buckets | 50 por segundo y bucket |
| API REST de Cloudflare para R2 | 1.200 peticiones cada 5 minutos |
Y uno que no es de R2 pero te afecta: si subes a través de un Worker, el cuerpo de la petición está limitado por el plan de la zona (100 MB en Free y Pro). Para subidas más grandes, URLs prefirmadas o multiparte por partes.
Migrar desde S3
Cloudflare tiene dos herramientas de migración integradas:
- Super Slurper: copia un bucket entero de S3, Google Cloud Storage u otro compatible a R2, de una vez.
- Sippy: migración gradual. Configuras R2 delante del bucket original; cada objeto que se pide y no está en R2 se copia en ese momento. Se activa con
wrangler r2 bucket sippy.
Errores comunes (y cómo evitarlos)
- Cargar el fichero en memoria.
await request.arrayBuffer()con un fichero de 200 MB revienta los 128 MB del Worker. Pasarequest.bodydirectamente aput()yobjeto.bodydirectamente anew Response(). - No guardar el
Content-Type. Si no lo guardas al subir, el navegador recibiráapplication/octet-streamy descargará las imágenes en lugar de mostrarlas.httpMetadata: request.headerslo resuelve. - Usar
etagen lugar dehttpEtag.etagva sin comillas; en una cabeceraETagdebe ir entrecomillado. - Listar para comprobar si existe.
head()es de clase B (barata);list()es de clase A (doce veces más cara). - Usar
r2.deven producción. Tiene límites de velocidad y no tiene caché configurable. - Infrequent Access para datos temporales. Con el mínimo de 30 días, un fichero que vive una hora se paga un mes entero.
- Escribir la misma clave muchas veces por segundo. Un contador o un "último estado" en un objeto de R2 acabará en 429. Para eso están KV o Durable Objects.
Cuándo usar R2 (y cuándo no)
Usa R2 para cualquier fichero que tu aplicación guarde y sirva: subidas de usuarios, medios, descargas, copias de seguridad, exportaciones y datos para análisis. Si ya usas S3 y tu factura de transferencia duele, R2 es probablemente la migración con mejor relación esfuerzo/ahorro que puedes hacer.
No es lo adecuado para datos pequeños que se leen y escriben constantemente (usa KV o D1), para estado que muchos clientes modifican a la vez (Durable Objects) ni para ficheros diminutos leídos millones de veces sin caché delante: ahí las operaciones de clase B suman más que el almacenamiento.
Sigue leyendo
- Cloudflare a fondo: la visión general de toda la plataforma.
- Cloudflare Workers a fondo: el runtime sobre el que se apoya todo lo de este artículo.
- Cloudflare D1 a fondo: la base de datos SQL para los metadatos de tus ficheros.
- Cloudflare Queues a fondo: procesa en segundo plano cada fichero que llega (miniaturas, antivirus...).
- Planes de Cloudflare Workers: Free frente a Paid: cómo encaja R2 en la factura.
- Cloudflare Images a fondo: redimensiona al vuelo las imágenes que guardas en R2.
- Cloudflare Stream a fondo: cuando el vídeo necesita streaming adaptativo.
- Cloudflare CDN y caché a fondo: Cache Reserve, la caché persistente montada sobre R2.