Cloudflare Queues a fondo: colas de mensajes con reintentos y cola de fallidos
Cómo funcionan las colas de Cloudflare, productores y consumidores, lotes, entrega al menos una vez, ack y retry por mensaje, espera exponencial, cola de fallidos, concurrencia, precios y límites, con un sistema de pedidos probado en local.
Contenido
Hay trabajo que no debería hacerse mientras el usuario espera: enviar el correo de confirmación, generar la factura en PDF, redimensionar la foto que acaba de subir, avisar a un servicio externo que tarda dos segundos en contestar o que a veces falla. Si lo haces dentro de la petición, la respuesta es lenta y un fallo externo se convierte en un error para el usuario.
La solución clásica es una cola de mensajes: la petición deja un mensaje con lo que hay que hacer y responde al momento; otro proceso lo recoge y lo hace, reintentando si falla. Cloudflare Queues es eso, integrado en Workers: un Worker envía mensajes con un binding y otro Worker (o el mismo) los recibe en lotes, sin servidores ni brokers que mantener.
En este artículo vamos a montar un sistema de pedidos con reintentos con espera exponencial y una cola de mensajes fallidos, a ejecutarlo de principio a fin en local viendo cómo un mensaje falla cuatro veces y acaba en la cola de fallidos, y a probar el consumidor con Vitest.
Cómo funciona
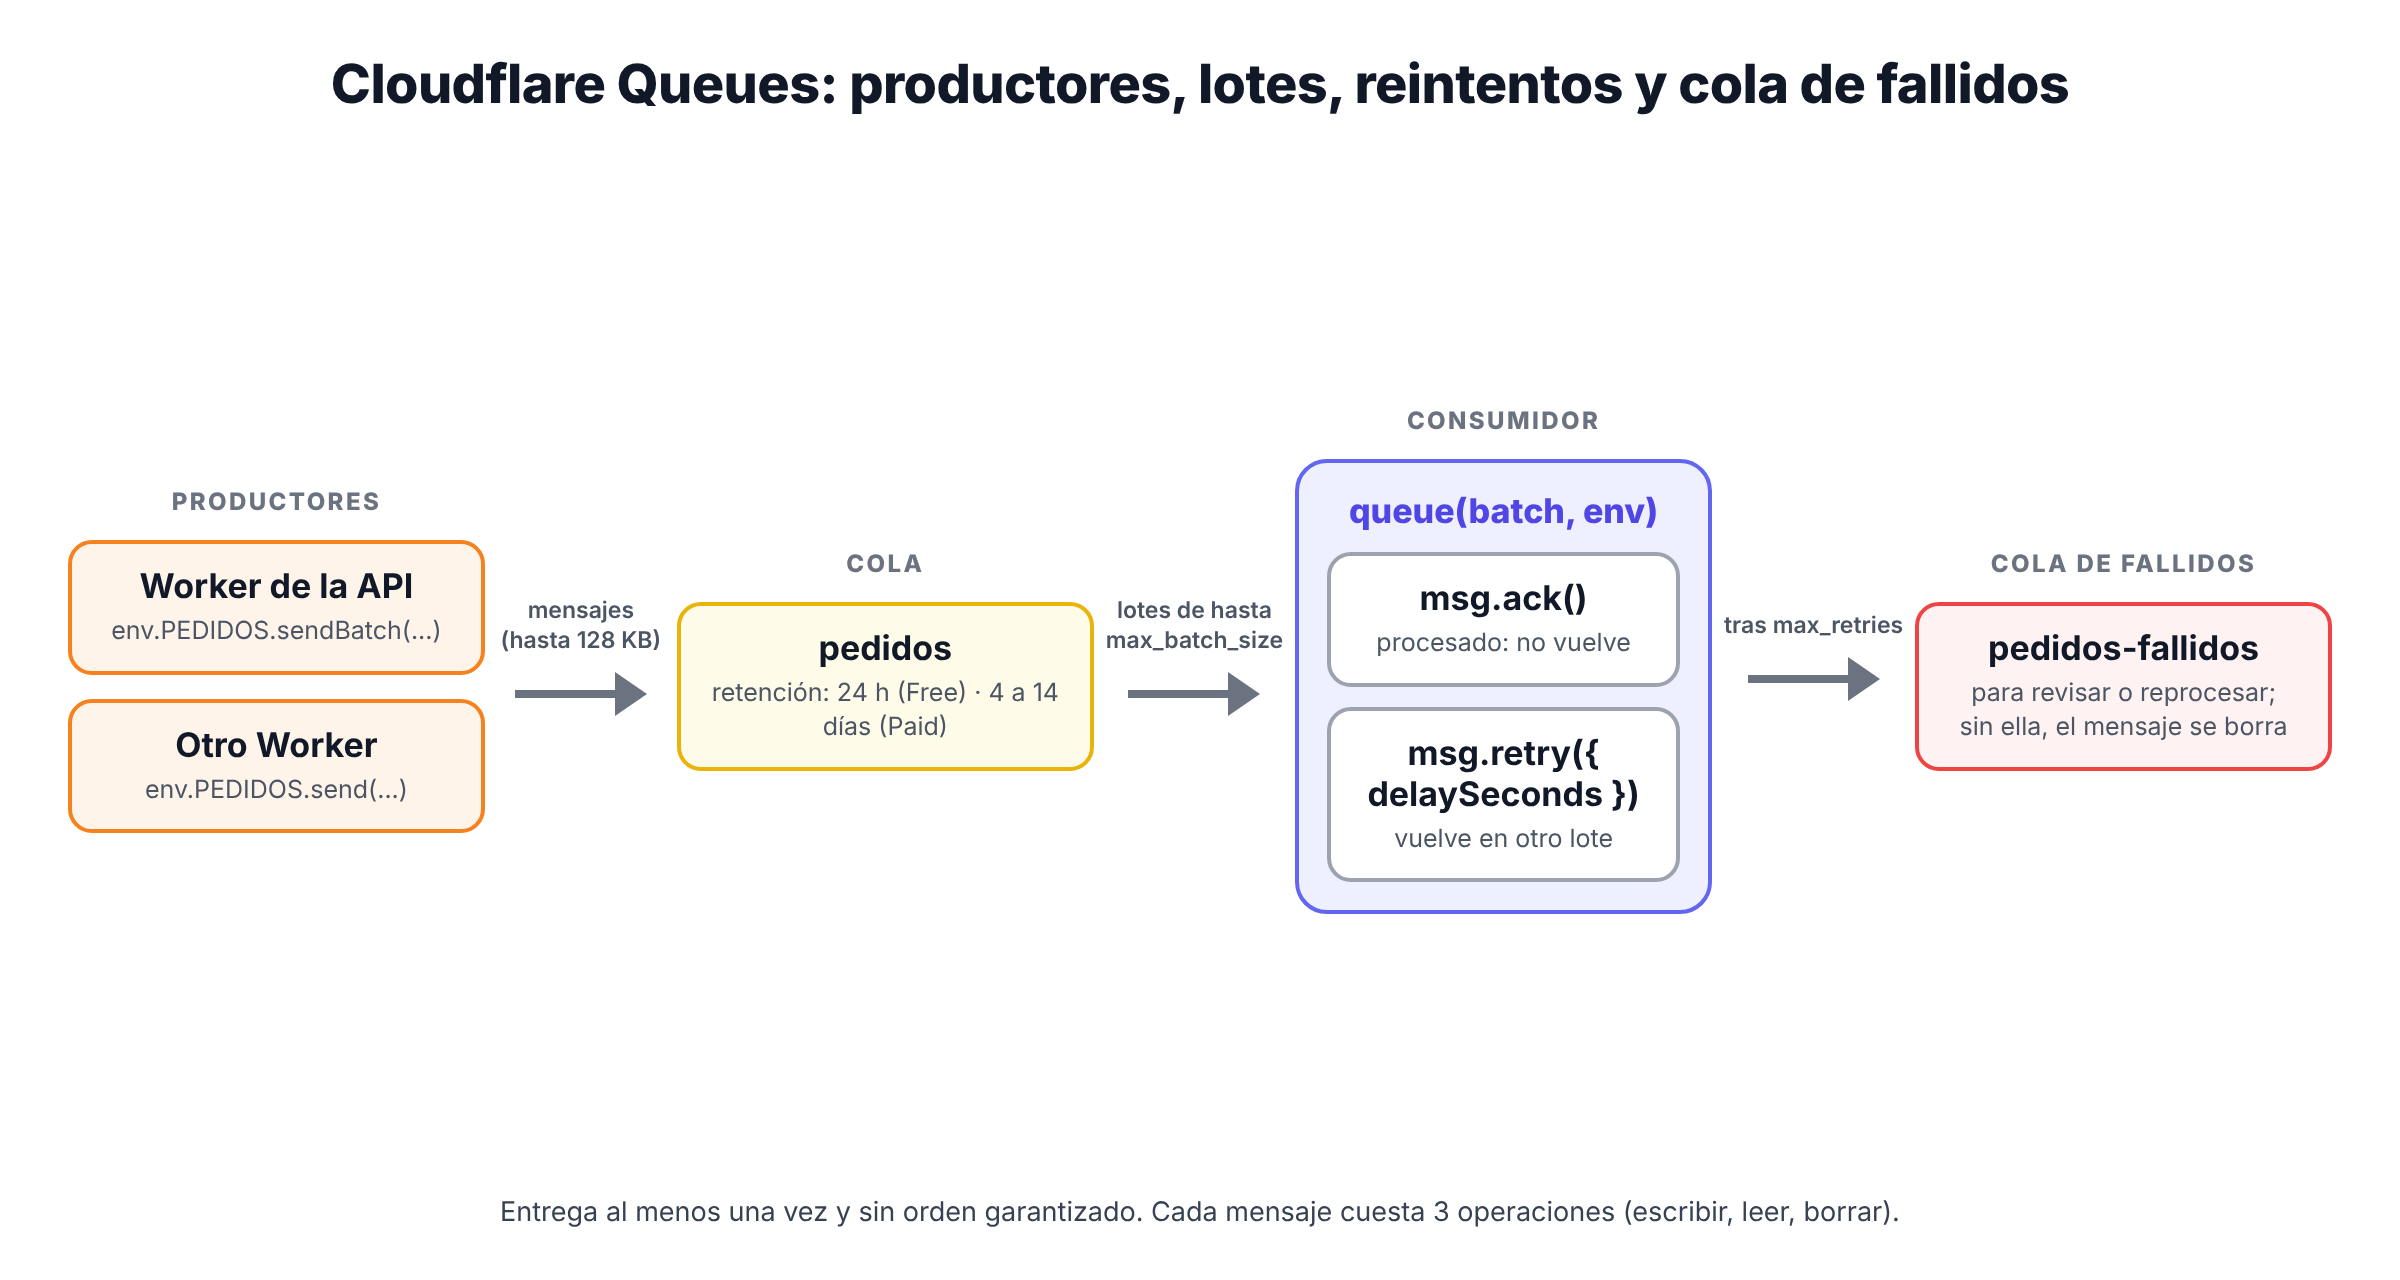
Hay tres piezas:
- La cola, que guarda los mensajes hasta que se procesan (o caducan).
- Los productores: cualquier Worker con un binding a la cola puede enviar mensajes con
send()osendBatch(). Puede haber muchos. - El consumidor: un Worker con un manejador
queue()que recibe los mensajes en lotes. Cada cola tiene un único consumidor configurado, aunque Cloudflare puede ejecutar varias invocaciones de ese consumidor en paralelo si la cola se va llenando.
Dos garantías que hay que tener claras desde el principio:
- Entrega al menos una vez. Un mensaje se entregará, pero en casos raros puede llegar dos veces. Tu consumidor tiene que ser idempotente: procesar dos veces el mismo pedido no debe cobrar dos veces.
- Sin orden garantizado. Los mensajes no tienen por qué llegar en el orden en que se enviaron. Si el orden importa, inclúyelo en el mensaje (una marca de tiempo o un número de secuencia) o usa un Durable Object.
Lotes, confirmaciones y reintentos
El consumidor recibe un lote cuando se junta max_batch_size mensajes (10 por defecto, hasta 100) o cuando pasa max_batch_timeout segundos (5 por defecto, hasta 60), lo que ocurra antes.
Si el manejador lanza una excepción, se reintenta el lote entero. Para no repetir el trabajo que sí salió bien, cada mensaje se puede confirmar con msg.ack() o devolver a la cola con msg.retry() de forma individual. Tras max_retries reintentos (3 por defecto), el mensaje se borra, salvo que hayas configurado una cola de mensajes fallidos (dead letter queue), donde se guarda para revisarlo.
Lo que cuesta
Queues se cobra por operaciones: cada escritura, lectura o borrado de 64 KB de mensaje es una operación. Entregar un mensaje normal cuesta 3 operaciones (escribir, leer y borrar).
| Workers Free | Workers Paid | |
|---|---|---|
| Operaciones | 10.000 al día | 1 millón al mes, luego 0,40 $ por millón |
| Retención de mensajes | 24 horas (fija) | 4 días por defecto, configurable hasta 14 |
Lo que conviene saber para estimar:
- Un millón de mensajes al día (30 millones al mes) son 90 millones de operaciones: 35,60 $ al mes, según el ejemplo de la documentación.
- Un mensaje de más de 64 KB cuenta como varios: uno de 65 KB o de 127 KB son 2 operaciones por cada escritura, lectura o borrado.
- Cada reintento es una lectura más. Un mensaje que falla 4 veces y va a la cola de fallidos cuesta 5 lecturas, más la escritura en la cola de fallidos.
- En el plan gratuito, 10.000 operaciones al día son unos 3.300 mensajes.
Configuración
# Con cuenta
npx wrangler queues create pedidos
npx wrangler queues create pedidos-fallidos
npx wrangler queues create avisos --delivery-delay-secs 300   # todos los mensajes esperan 5 minutos
En wrangler.jsonc, el productor es un binding y el consumidor una sección aparte. Aquí el mismo Worker produce y consume, y también consume la cola de fallidos:
{
  "$schema": "node_modules/wrangler/config-schema.json",
  "name": "queues-lab",
  "main": "src/index.ts",
  "compatibility_date": "2026-10-01",
  "queues": {
    "producers": [{ "binding": "PEDIDOS", "queue": "pedidos" }],
    "consumers": [
      {
        "queue": "pedidos",
        "max_batch_size": 10,      // hasta 10 mensajes por lote...
        "max_batch_timeout": 2,    // ...o lo que haya tras 2 segundos
        "max_retries": 3,          // 1 intento + 3 reintentos
        "retry_delay": 1,
        "dead_letter_queue": "pedidos-fallidos"
      },
      { "queue": "pedidos-fallidos", "max_batch_size": 10, "max_batch_timeout": 1 }
    ]
  },
  // Dónde dejamos el resultado del procesamiento (para verlo desde fuera)
  "kv_namespaces": [{ "binding": "RESULTADOS", "id": "33333333333333333333333333333333" }]
}
Un sistema de pedidos
La petición HTTP valida, encola y responde 202 Accepted en milisegundos. El consumidor procesa cada pedido (aquí, simula un servicio externo que rechaza los emails sin arroba), confirma los buenos uno a uno y reintenta los malos con espera exponencial: 2, 4 y 8 segundos.
export type Pedido = { id: string; email: string; total: number };

export default {
  // PRODUCTOR: la petición HTTP solo encola y responde al momento
  async fetch(request, env): Promise<Response> {
    const url = new URL(request.url);

    if (request.method === "POST" && url.pathname === "/pedidos") {
      const pedidos = await request.json<Pedido[]>();
      // sendBatch: hasta 100 mensajes (o 256 KB) en una llamada
      await env.PEDIDOS.sendBatch(pedidos.map((p) => ({ body: p })));
      return Response.json({ encolados: pedidos.length }, { status: 202 });
    }

    if (url.pathname === "/resultados") {
      const { keys } = await env.RESULTADOS.list();
      const valores = await Promise.all(keys.map(async (k) => [k.name, await env.RESULTADOS.get(k.name)]));
      return Response.json(Object.fromEntries(valores));
    }
    return new Response("No existe", { status: 404 });
  },

  // CONSUMIDOR: recibe lotes; un mismo Worker puede consumir varias colas
  async queue(batch, env): Promise<void> {
    if (batch.queue === "pedidos-fallidos") {
      for (const msg of batch.messages) {
        const p = msg.body as Pedido;
        // Ojo: aquí attempts vuelve a empezar en 1 (es otra cola)
        await env.RESULTADOS.put(p.id, "fallido: enviado a la cola de fallidos");
        msg.ack();
      }
      return;
    }

    console.log(`Lote de ${batch.messages.length} mensajes de "${batch.queue}"`);
    for (const msg of batch.messages) {
      const p = msg.body as Pedido;
      try {
        await procesar(p);
        await env.RESULTADOS.put(p.id, `ok (intento ${msg.attempts})`);
        msg.ack(); // confirmado: no se vuelve a entregar aunque otro del lote falle
      } catch (err) {
        console.log(`Pedido ${p.id} falló en el intento ${msg.attempts}: ${err}`);
        msg.retry({ delaySeconds: 2 ** msg.attempts }); // espera exponencial
      }
    }
  },
} satisfies ExportedHandler<Env, Pedido>;

async function procesar(p: Pedido): Promise<void> {
  // Simulamos un servicio externo que rechaza los emails no válidos
  if (!p.email.includes("@")) throw new Error("email no válido");
}
Fíjate en el tipo: ExportedHandler<Env, Pedido>. El segundo parámetro es el tipo de los mensajes de la cola, y así batch.messages llega tipado. (Aquí lo convierto igualmente con as Pedido porque el mismo manejador consume dos colas.)
Ejecución de principio a fin
wrangler dev simula la cola, los lotes, los reintentos y la cola de fallidos. Encolamos tres pedidos, uno de ellos con un email no válido:
$ curl -X POST localhost:8794/pedidos -H "Content-Type: application/json" -d '[
    {"id":"p1","email":"[email protected]","total":30},
    {"id":"p2","email":"[email protected]","total":12.5},
    {"id":"p3","email":"sin-arroba","total":9}]' -w " %{http_code}\n"
{"encolados":3} 202

$ sleep 3; curl localhost:8794/resultados
{"p1":"ok (intento 1)","p2":"ok (intento 1)"}

$ sleep 30; curl localhost:8794/resultados
{"p1":"ok (intento 1)","p2":"ok (intento 1)","p3":"fallido: enviado a la cola de fallidos"}
Y lo que cuenta el log de wrangler dev entretanto:
[wrangler:info] POST /pedidos 202 Accepted (9ms)
Lote de 3 mensajes de "pedidos"
Pedido p3 falló en el intento 1: Error: email no válido
[wrangler:info] QUEUE pedidos 2/3 (33ms)
Lote de 1 mensajes de "pedidos"
Pedido p3 falló en el intento 2: Error: email no válido
[wrangler:info] QUEUE pedidos 0/1 (2ms)
Lote de 1 mensajes de "pedidos"
Pedido p3 falló en el intento 3: Error: email no válido
[wrangler:info] QUEUE pedidos 0/1 (2ms)
Lote de 1 mensajes de "pedidos"
Pedido p3 falló en el intento 4: Error: email no válido
[wrangler:warn] Moving message "99a7c3544a1259f3c3203b08e705021b" on queue "pedidos" to dead letter queue "pedidos-fallidos" after 4 failed attempts...
[wrangler:info] QUEUE pedidos 0/1 (2ms)
[wrangler:info] QUEUE pedidos-fallidos 1/1 (9ms)
Se ve todo el ciclo: el primer lote trae los tres pedidos y confirma dos (2/3); p3 vuelve solo en lotes posteriores, con esperas crecientes; tras el intento 4 (el original más los 3 reintentos de max_retries), pasa a pedidos-fallidos, cuyo consumidor deja constancia en KV.
attempts vuelve a empezar. Al llegar a pedidos-fallidos, el mensaje trae attempts: 1: para Queues es un mensaje nuevo en otra cola. Si quieres saber cuántas veces falló originalmente, guárdalo tú en el cuerpo del mensaje o regístralo en el último intento.Retrasos y concurrencia
Un mensaje puede esperar antes de entregarse: env.PEDIDOS.send(pedido, { delaySeconds: 600 }) al enviarlo, msg.retry({ delaySeconds: 30 }) al reintentarlo, retry_delay en el consumidor para todos los reintentos o --delivery-delay-secs en la cola para todos los mensajes. El máximo es de 24 horas. Es una forma sencilla de programar tareas ("recuérdale el carrito abandonado dentro de una hora").
La concurrencia es automática: si los mensajes se acumulan más rápido de lo que el consumidor los procesa, Cloudflare lanza más invocaciones en paralelo, hasta 250. Si tu consumidor llama a una API externa con límites, ponle un techo con max_concurrency en su configuración. Hay que saber que los reintentos con retry() no hacen que la concurrencia baje.
ctx.waitUntil() lo hace sin cola y sin coste extra: la respuesta sale y el Worker sigue trabajando hasta 30 segundos. Usa una cola cuando necesites reintentos, durabilidad o repartir mucho trabajo.Pruebas del consumidor
El plugin de Vitest permite construir un lote a mano con createMessageBatch, pasárselo al manejador y comprobar qué mensajes se confirmaron y cuáles se reintentaron con getQueueResult:
import { env } from "cloudflare:workers";
import { createExecutionContext, createMessageBatch, getQueueResult } from "cloudflare:test";
import { describe, it, expect } from "vitest";
import worker, { type Pedido } from "../src/index";

describe("consumidor de pedidos", () => {
  it("confirma los buenos y reintenta el malo con espera exponencial", async () => {
    const batch = createMessageBatch<Pedido>("pedidos", [
      { id: "m1", timestamp: new Date(), attempts: 1, body: { id: "p1", email: "[email protected]", total: 30 } },
      { id: "m2", timestamp: new Date(), attempts: 2, body: { id: "p2", email: "sin-arroba", total: 9 } },
    ]);
    const ctx = createExecutionContext();
    await worker.queue(batch, env, ctx);
    const resultado = await getQueueResult(batch, ctx);

    expect(resultado.explicitAcks).toEqual(["m1"]);
    expect(resultado.retryMessages).toMatchObject([{ msgId: "m2" }]);
    expect(await env.RESULTADOS.get("p1")).toBe("ok (intento 1)");
  });
});
$ npx vitest run
Test Files 1 passed (1)
Tests 1 passed (1)
Duration 1.65s (transform 39ms, setup 0ms, import 63ms, tests 20ms, environment 0ms)Un detalle que me encontré: retryMessages incluye el id del mensaje, pero no el delaySeconds pedido, así que la espera exponencial no se puede comprobar desde aquí. Por eso el test solo verifica qué se reintenta, y la espera la he comprobado en la ejecución con wrangler dev.
Límites que importan
| Límite | Valor |
|---|---|
| Colas por cuenta | 10.000 |
| Tamaño de un mensaje | 128 KB |
| Reintentos por mensaje | 100 |
| Mensajes por lote del consumidor | 100 |
sendBatch | 100 mensajes o 256 KB en total |
| Espera máxima para formar un lote | 60 segundos |
| Rendimiento por cola | 5.000 mensajes por segundo |
| Mensajes pendientes por cola | 25 GB |
| Invocaciones concurrentes del consumidor | 250 |
| Duración de una invocación del consumidor | 15 minutos de reloj |
| CPU del consumidor | Configurable hasta 5 minutos |
delaySeconds | 24 horas |
Si un mensaje no cabe en 128 KB (un documento, una imagen), guarda el contenido en R2 y envía en el mensaje solo la clave.
Errores comunes (y cómo evitarlos)
- Consumidores no idempotentes. La entrega es "al menos una vez". Usa el id del pedido (no el del mensaje) para detectar duplicados: comprobar en D1 si ya se procesó antes de cobrar o enviar.
- Lanzar una excepción por un mensaje. Reintenta el lote entero, incluidos los que ya salieron bien. Envuelve cada mensaje en
try/catchy usaack()yretry()individuales. - No configurar cola de fallidos. Sin ella, tras los reintentos el mensaje se borra sin dejar rastro.
- Reintentar sin espera. Si un servicio externo está caído, reintentar al momento solo lo machaca. Espera exponencial con
delaySeconds. - Contar con el orden. No hay garantía de orden: si importa, va en los datos.
- Mensajes grandes. Por encima de 64 KB se cobran dobles, y por encima de 128 KB no caben. Referencia a R2 en su lugar.
- Olvidar la retención en el plan gratuito. Son 24 horas fijas: si tu consumidor falla un fin de semana entero, los mensajes caducan.
Cuándo usar Queues (y cuándo no)
Usa Queues para todo lo que pueda hacerse después y deba hacerse aunque algo falle: correos, webhooks salientes, procesado de ficheros subidos a R2 (las notificaciones de eventos de R2 escriben directamente en una cola), sincronización con servicios externos, ingesta de eventos por lotes hacia D1 o R2.
No es lo adecuado para flujos de varios pasos con estado que duran horas o días (para eso está Workflows, que guarda el progreso de cada paso), para tareas que necesitan orden estricto (Durable Objects) ni para tareas programadas a horas fijas (Cron Triggers).
Sigue leyendo
- Cloudflare a fondo: la visión general, con Workflows.
- Cloudflare Workers a fondo:
waitUntily Cron Triggers, las alternativas ligeras. - Cloudflare R2 a fondo: ficheros grandes referenciados desde mensajes.
- Cloudflare Durable Objects a fondo: cuando el orden y la coordinación importan.
- Planes de Cloudflare Workers: Free frente a Paid: operaciones y retención en cada plan.
- Cloudflare Workflows a fondo: cuando el trabajo tiene varios pasos con estado o esperas.
- Cloudflare Email a fondo: correo entrante y saliente para procesar en segundo plano.